生成式AI的数学基础:一本直观入门小书

《The Little Book of Generative AI Foundations》在Hacker News引发讨论,定位为直观的生成式AI数学入门读物。
本文介绍了在Hacker News上引发讨论的《The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer》。该书旨在填补厚重理论教材与纯实践指南之间的空白,用直观方式讲解生成式AI的数学基础,面向数学背景不深的技术从业者。文章推断其内容可能覆盖概率分布、梯度下降和生成模型核心思想等模块,并讨论了直观与严谨之间的取舍:入门书优先建立心智模型,读者后续仍需严谨教材校正理解。目标读者包括有工程背景但数学生疏的开发者、产品经理和AI入门学生。
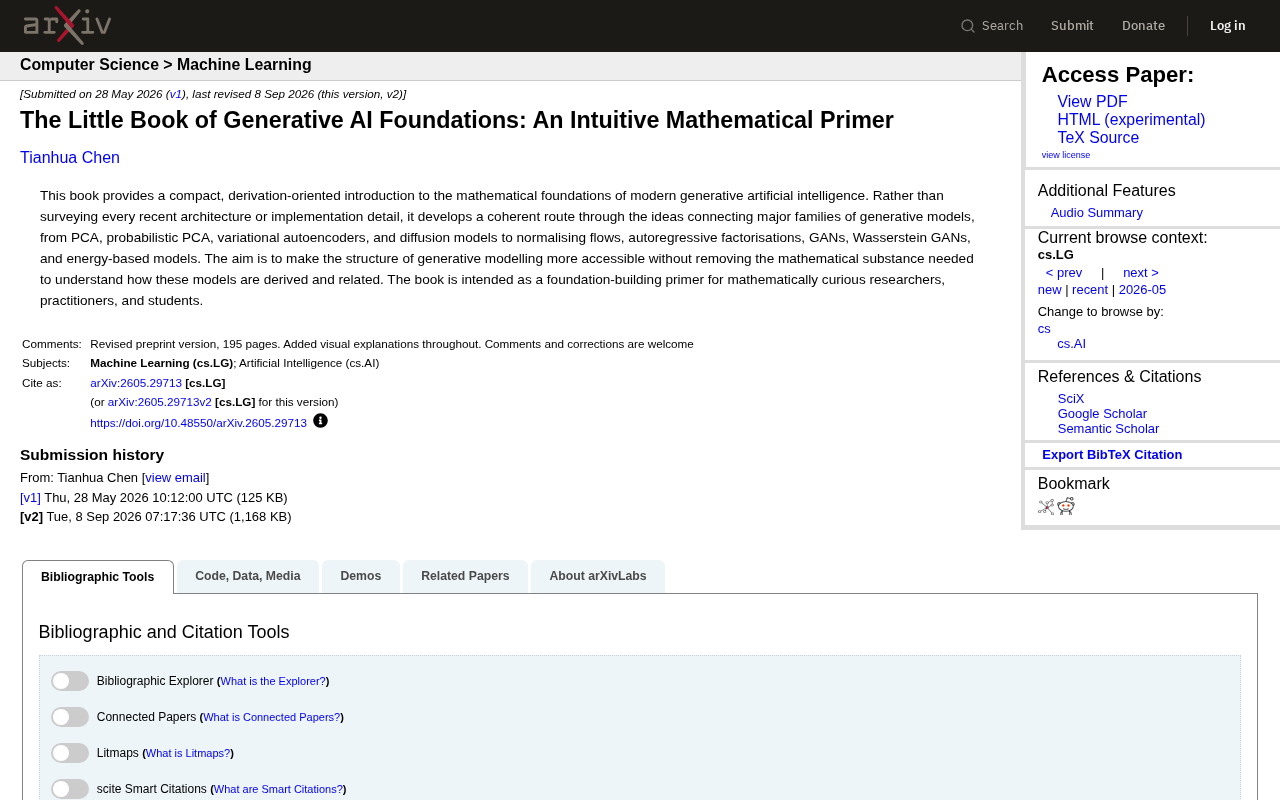
生成式AI的爆发让许多人想深入了解其背后的原理,但复杂的数学公式往往成为拦路虎。最近在Hacker News上引发讨论的《The Little Book of Generative AI Foundations: An Intuitive Mathematical Primer》试图解决这一矛盾——用直观的方式讲解生成式AI的数学基础。
为什么需要一本“直观的数学入门书”
当前市面上的AI教材大致分为两类:一类是面向研究者的厚重理论书,充斥着矩阵微积分和概率图模型;另一类是面向应用开发者的实践指南,侧重调参和API调用,对原理避而不谈。两者之间缺少一座桥梁,让具备基础编程能力、但数学背景不深的读者能够理解生成式模型的核心机制。
这本小书的定位正是填补这一空白。从标题中的“Intuitive Mathematical Primer”可以看出,它不追求数学上的完备性,而是强调直觉建立——先让读者理解“为什么这样设计”,再补充必要的公式推导。这种思路在Hacker News上获得了关注,说明不少技术从业者对“够用且易懂”的数学解释存在真实需求。
直观讲解可能覆盖的核心内容
虽然原始素材未披露目录结构,但从生成式AI的基础知识体系推断,一本合格的直观数学入门书通常需要覆盖几个关键模块:
概率与分布的基础直觉
生成式模型的本质是学习数据分布,因此概率论是绕不开的起点。直观讲解的重点不在于测度论,而在于让读者理解条件概率、贝叶斯更新和采样过程——这些概念直接对应生成模型如何“从分布中抽取样本”。
KL散度(Kullback-Leibler Divergence)是生成模型中最常用的分布差异度量之一,但它并非严格意义上的“距离”:它不满足对称性,即从分布 P 到 Q 的 KL 散度通常不等于从 Q 到 P 的 KL 散度。直观上,KL(P||Q) 衡量的是“用 Q 来编码来自 P 的样本时,平均需要多付出多少比特的信息量”。在变分自编码器中,KL 散度用于约束隐变量分布接近先验;在生成对抗网络中,它与 JS 散度密切相关。理解 KL 散度的非对称性,有助于读者明白为什么不同生成模型在训练时会出现“模式崩塌”或“覆盖不足”等不同倾向。
神经网络与梯度下降
从线性代数到反向传播,这部分内容容易被写成公式堆砌。直观入门的价值在于用几何视角解释梯度下降:把损失函数想象成地形,训练过程就是在山谷中寻找最低点。这种比喻虽不严谨,但能帮助读者建立对优化过程的物理直觉。
反向传播(Backpropagation)的本质是链式法则在计算图上的高效实现。直观理解可以分两步:前向传播时,网络逐层计算输出并记录中间结果;反向传播时,从损失函数出发,沿着计算图反向逐层计算每个参数对损失的偏导数。关键直觉在于“局部梯度相乘”——每一层只需知道自己的局部导数,再乘以上游传回的梯度,就能得到最终梯度。这种设计使得深层网络的梯度计算复杂度与前向传播同阶,避免了数值微分的高昂代价。读者若能把反向传播想象成“误差信号沿网络反向流动、每层按局部规则分摊责任”,就抓住了其核心。
生成模型的核心思想
无论是变分自编码器、生成对抗网络还是扩散模型,其数学框架都涉及隐变量、KL散度和分数匹配等概念。一本小书无法深入每个细节,但可以通过统一的视角——比如“如何度量两个分布的差异”——将这些模型串联起来,让读者形成整体认知而非孤立记忆。
扩散模型的核心直觉可以用“加噪与去噪”来概括:前向过程逐步向数据添加高斯噪声,直到数据变成纯噪声;反向过程则训练一个神经网络,从纯噪声开始逐步去噪,最终生成样本。数学上,这等价于学习数据分布在各噪声水平下的得分函数(即对数概率密度的梯度),因此扩散模型与分数匹配(score matching)紧密相关。与 GAN 相比,扩散模型的训练更稳定,但采样需要多步迭代,速度较慢。理解“从噪声中逐步恢复结构”这一直觉,是把握扩散模型为何能生成高质量图像的关键。
直观与严谨之间的取舍
这类入门书面临一个固有矛盾:过度简化会误导读者,过度严谨则失去可读性。“Intuitive Mathematical Primer”这一命名暗示了作者的选择——优先保证直觉正确,在关键处标注“此处有简化,详见参考文献”。
这种取舍在Hacker News的讨论氛围中通常会被接受。技术社区对入门材料的评价标准往往是“能否让我快速建立心智模型”,而非“数学上是否无懈可击”。不过,读者也需要保持警惕:直观解释在建立初步认知后,仍需通过更严谨的教材来校正理解偏差。
谁适合读这类书
从讨论热度来看,目标读者大致包括几类人:有工程背景但数学生疏的开发者、希望理解模型内部机制的产品经理、以及准备进入AI领域的学生。对于已经熟悉Transformer架构细节的从业者,这本书的价值可能有限;但对于那些“会用但说不清为什么”的实践者,直观数学入门恰恰是补齐短板的一步。
生成式AI的数学门槛客观存在,但并非不可逾越。像《The Little Book of Generative AI Foundations》这样的尝试,其意义在于降低入门的心理门槛,让更多人在动手调模型之前,先理解模型在做什么。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。