生成式Gibbs采样:用物理上下文组合扩散模型
广义Gibbs采样框架在推理时组合预训练扩散模型与物理能量项,无需联合数据即可采样复杂联合系统。
芝加哥大学Wei Zhou提出广义Gibbs采样框架,针对端到端扩散模型在联合系统采样中面临的组合数据稀缺、循环依赖与分布外泛化三大瓶颈,提供了一条无需重新训练的解决路径。框架的核心思想是:将扩散模型的去噪过程重新理解为贝叶斯后验采样器,在推理阶段把各子系统的预训练模型与可解析计算的物理上下文能量项通过Gibbs迭代组合起来。当组分间相互作用为二次型时,算法可在有限扩散时间内实现无偏采样,并借助副本交换加速混合。该框架在量子统计领域展现出突出优势:仅用经典统计训练的水分子模型,通过推理时组合32个路径积分副本即可涌现核量子效应,相比传统PIMD实现约32倍加速。非二次相互作用情形下存在近似误差,反复调用模型会放大其固有缺陷,是后续需要攻克的核心挑战。
为什么单一大模型解决不了联合系统采样
扩散模型在科学发现中已经展示出惊人的能力。微软研究院的BioEmu可以根据给定序列生成蛋白质构象样本,MatterGen则能为无机材料生成结构。只要有足够的数据训练,这些端到端模型表现极佳。但来自芝加哥大学Aaron Dinner课题组、同时受纽约大学John Zhang联合指导的博士生Wei Zhou在一场学术报告中指出,现实中的训练数据往往撑不起这种理想。
问题集中在三点。第一是组合稀缺性:单体蛋白质的数据非常丰富,但当你想训练一个蛋白质二聚体乃至更大组装体的模型时,数据量却远远跟不上组合空间的爆炸式增长。第二是循环依赖:要让端到端模型完美工作,你本质上需要目标分布的数据来训练——可如果你已经有了目标分布的数据,又何必再训练模型去生成它?第三是模块化问题:预训练模型通常在标准条件下(纯水、室温、无结合伴侣)训练,一旦环境改变(加入离子、引入结合伴侣),这些场景几乎都是分布外的,模型很难迁移。
这三个问题指向同一个结论:症结不在训练出更强的端到端模型,而在于我们使用模型的方式。真实物理系统太过多样,试图用单一模型覆盖一切注定失败。
组合思路:在推理时拼装模型
Wei Zhou提出的方案被称为"组合"(composition)。以一个由红、黑两条聚合物链加上周围溶剂和离子构成的系统为例,整个系统状态记为S,它可以被分解为若干子系统:红色聚合物、黑色聚合物,以及溶剂和离子。
与其训练一个包揽一切的模型,不如利用已有的单体模型——这些模型有充足数据支撑,训练质量很好——再加上物理学家已经发展得相当精确的力场来描述溶剂和组分间相互作用,在推理阶段把它们组合起来。这样我们只需要每个单体的预训练模型,外加一项被称为"物理上下文"(physical context)的能量项。
这个上下文项负责描述模型没见过的部分:溶剂、离子及其相互作用。它本质上是一个可以直接计算的能量项,具有玻尔兹曼分布的熟悉形式,无需模型去学习。预训练模型只知道聚合物作为孤立组分的行为,而联合系统中的缺失部分正由上下文补足。
把去噪过程理解为后验采样
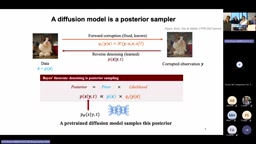
要让组合成为可能,需要重新理解扩散模型的一个事实。训练扩散模型时,先从目标数据出发,用前向破坏核(通常是线性高斯)把数据加噪,再让模型学习逆向的去噪过程。借助贝叶斯定理,去噪过程实际上是一个"去噪后验"——后验等于先验乘以似然,先验是训练数据,似然则来自我们定义的前向破坏过程。
关键洞察在于:如果不从纯噪声出发,而是从某个特定的扩散时刻、针对给定的加噪观测启动,扩散模型实际上就是一个从去噪后验中采样的后验采样器。Wei Zhou把去噪器当作黑箱处理——输入加噪观测和扩散时间,输出一批样本——在此基础上构建整个采样理论,不涉及具体的网络架构。
扩散模型的前向过程通常定义为线性高斯核:在每个时间步 $t$,原始数据 $x_0$ 被逐渐混入高斯噪声,直至 $t=T$ 时数据完全淹没在标准正态分布中。反向过程通过训练一个去噪网络(通常参数化为预测噪声的 score function)来逐步恢复数据。贝叶斯视角下,这个逆向步骤可以被解释为:以加噪观测 $x_t$ 为条件、求原始数据 $x_0$ 的后验分布 $p(x_0 | x_t)$。这正是 Wei Zhou 所利用的核心性质——去噪器天然是一个条件采样器,而不只是一个生成器。这个视角的优势在于,它把"从哪里启动扩散链"变成了一个可控的设计参数:从中间时刻 $t^$ 启动,等价于对一个以 $x_{t^}$ 为观测的后验进行采样,从而可以把外部物理约束以"观测"的形式注入,而无需重新训练模型。
广义Gibbs采样框架
基于这一理解,作者构造了一个关于扩散时间t的联合分布族。它由两部分组成:一是上下文因子,贡献预训练先验没有建模的缺失项;二是所有预训练先验的乘积,两者由模型训练所用的前向核(线性高斯)连接。
这个联合分布之所以有意义,是因为它满足"零时极限":当扩散时间趋近于零、前向核退化为delta函数时,积分掉模型变量后剩下的正是此前定义的组合目标。更进一步,命题一证明:如果系统可分解(总能量等于各子系统孤立能量加上环境能量与相互作用),且每个模型都在孤立组分上完美训练,上下文因子负责其余能量项,那么联合分布在零时极限下将收敛到真实的物理分布。
采样则通过Gibbs方法完成,分两步交替进行。第一步固定全系统状态,更新每个预训练模型相关的变量——这正是去噪后验采样。第二步称为"上下文感知聚合",固定模型变量去更新全系统状态,其有效能量包含两部分:全系统的能量项(控制环境与相互作用),以及一个把全系统的部分自由度约束到当前模型变量的约束项。两步反复迭代构成马尔可夫链,最终收敛到目标分布。
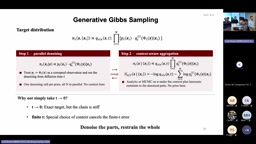
一个微妙之处是:零时刻下马尔可夫链根本无法移动(去噪原样输出,约束项变为无穷),因此必须选择有限时间,而这会引入误差。
Gibbs采样是马尔可夫链蒙特卡洛(MCMC)方法中的经典算法:面对多变量联合分布时,每次只更新一个变量(或一组变量),将其他变量固定、从对应的条件分布中采样,循环往复直至收敛到目标联合分布。它的优势在于,当联合分布难以直接采样时,各变量的条件分布往往形式上更简单、可处理。本文的"广义"体现在两点:其一,采样空间被增广到包含扩散时间 $t$,使得去噪后验可以被直接用作条件采样步骤;其二,不同子系统可以使用异构的模型(神经网络去噪器与解析力场),各自只负责自己管辖的自由度,通过上下文因子在推理时耦合,而非共享同一个参数化模型。这种设计让框架在理论上继承了Gibbs采样的收敛保证,同时在实践中绕开了对统一训练数据的需求。
二次相互作用下的无偏采样
这里出现了一个漂亮的结论。如果目标物理系统中组分间的相互作用是二次型的,由于前向核本身是线性高斯,总能找到合适的上下文时间表使得x的边缘分布在有限时间下精确无偏——当且仅当所选的上下文调度满足特定两个条件。
换句话说,只要注入的噪声不超过某个上限,就能在有限时间找到让采样精确的上下文因子。不过为保证协方差矩阵正定,需要对扩散时间设上界。而较小的时间会拖慢混合速度,作者用"扩散时间上的副本交换"(replica exchange over diffusion time)来加速——构造扩散时间更大的副本并在它们之间交换,混合加速的同时最小时间的副本仍保持无偏。

这与现有方法形成鲜明对比。无论是split-Gibbs采样、引导扩散还是score composition,都要求所有模型工作在同一共享空间;而广义Gibbs采样定义了一个增广空间,每个模型只控制联合系统的部分自由度,其余由物理模型掌管,实现了对联合系统的异构建模。在标准split-Gibbs中因协方差不匹配会出现"协方差膨胀"导致有偏,而本框架只需按命题二修正协方差,即可对任意线性逆问题在任意小于上限的时间保持无偏。
副本交换(Replica Exchange,又称并行回火 Parallel Tempering)是一种克服 MCMC 混合缓慢问题的标准技巧:同时运行多条温度(或噪声水平)不同的马尔可夫链,定期在相邻副本之间以 Metropolis 准则交换状态。高温(高噪声)副本能轻松越过能量壁垒探索大范围构象空间,低温(低噪声)副本则精确刻画目标分布的细节;通过交换,低温副本借助高温副本的流动性实现加速混合,同时不破坏稳态分布。在本文框架中,"扩散时间"扮演了"温度"的角色:较大的扩散时间对应噪声更强、去噪约束更松的副本,混合更快但边缘分布已非精确目标;最小时间的副本满足无偏条件,通过与大时间副本交换状态来加速其混合,在保证精度的前提下显著提升采样效率。
三类应用:从格点模型到量子统计
框架覆盖三种情形,采样流程完全相同,差异只在于相互作用类型决定能否在有限时间精确。
线性逆问题对应单先验加线性高斯上下文。作者在高斯混合模型上验证:标准split-Gibbs的误差随比值增大而上升,本算法通过协方差修正消除了精度与混合之间的痛苦权衡。
二次相互作用的多先验对应标量场格点模型和量子统计。在L×L的格点模型中,自旋间相互作用是二次型,只需一个一维模型在推理时复制L×L份并注入二次相互作用,算法正确捕捉了相变行为。量子统计的应用尤其精彩:路径积分表示把一个含核量子效应的系统展开成多个经典副本、由二次相互作用耦合相邻副本。这恰好落入精确范围——只需一个在经典玻色分布上训练的去噪模型,推理时组合即可。

由于量子信息全部来自推理时组合的二次项,框架带来了意外的灵活性:改变质量可模拟同位素效应,改变副本数量p则实现了温度可迁移性。在体相水的测试中,模型仅在300K经典统计水盒上训练、组合32个副本,就自然涌现出量子统计行为。把氢换成氘、氚后结构变得更有序,与路径积分分子动力学(PIMD)参考数据吻合良好。性能上,由于上下文聚合是解析的、无需评估全系统能量和力,相比传统PIMD方法实现了约32倍加速。
非二次相互作用的多先验是最后一类,会产生近似误差。作者研究了丙氨酸二肽体系:在真空数据上训练的模型本不知道钠离子的存在,直接采样给出偏长的氧-氧距离;用算法在推理时组合钠离子后,几乎正确恢复了氧-氧峰。双肽二聚体的平行/反平行构象这种集体行为也被自动重现,只是由于非二次性仍存在一定偏差。
路径积分分子动力学(Path Integral Molecular Dynamics,PIMD)是研究含核量子效应(Nuclear Quantum Effects,NQE)的标准计算化学方法。其理论基础是费曼路径积分:在热力学统计下,一个量子粒子可以被等价地表示为 $p$ 个经典"珠子"(beads)构成的环形聚合物,珠子之间由谐振子势连接,所有珠子的平均位置对应量子粒子的期望位置。$p$ 越大(对应副本数量越多),对量子统计的描述越精确,但计算代价也线性增长。氢原子质量小,其零点能和量子隧穿效应尤为显著,NQE 对水、质子传导等体系的结构与动力学有实质性影响。传统 PIMD 需要对所有 $p$ 个副本同时评估力场或神经网络势,而本文框架中副本间的谐振子耦合恰好是二次型,可以解析处理,神经网络仅需评估单个经典副本的去噪分布,因此实现了对计算代价的大幅削减。
价值与局限
这项工作的核心观点是:研究联合分布不必依赖一个包揽一切的巨型端到端模型,而可以把联合系统分解为孤立组分、在推理时重新组合。广义Gibbs采样框架在二次相互作用下精确,在非二次情形下有近似误差。
作者坦承未来的几项挑战。由于框架中扩散模型被反复使用,会放大模型固有误差——一次性生成看起来没问题,反复使用时模型缺陷就暴露出来,因此需要开发高保真先验。此外还要把框架推广到二次型之外、发展非二次情形的误差控制,并扩展到大型生物分子复合物。
现场讨论也触及了方法的边界:Gibbs采样本质上是框架,无法保证模型是否在联合分布所需的区域有过训练。如果某种构型只有在溶剂存在下才会出现,而单独看溶剂和分子都观察不到,Gibbs采样就会失效。对于非二次相互作用,deconvolution无解意味着只能取接近零的时间,从而回到混合缓慢的问题——这正是该方法在实用中需要权衡的地方。
相关推荐

AI智能体的真实风险:被夸大的"黑客"与被忽视的隐患
AI智能体"黑客"事件频发,但真实风险究竟是什么?本文剖析OpenAI训练暂停、DNS隧道漏洞、Meta Muse隐私泄露,以及智能体消除摩擦可能引发的银行挤兑与医疗成本上涨,提出"AI现实主义"的理性视角。

OpenAI Dev Day 全盘点:20+ 发布背后的三大趋势
OpenAI Dev Day 一次性发布 20+ 产品,涵盖个人智能体 DOTS、GPT-6.1 Sol、Decisions API、Space 协作区与模型市场。本文全面盘点并解读其揭示的三大 AI 趋势。

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。