昇腾950PR单卡推理DeepSeek V4-Flash实测:208 TPS并已开源

昇腾950PR单卡128GB显存跑通裁剪版DeepSeek V4-Flash,解码峰值208 TPS并已开源。
华为昇腾950PR在单卡128GB显存配置下成功运行裁剪版DeepSeek V4-Flash(ds-v4-flash),解码峰值达208 TPS,相关代码已开源。显存规划上,约109GB用于全量权重,剩余约11GB支撑800K上下文;极限场景下1.6M上下文搭配128并发可实现约3700 tokens/s的聚合吞吐。测试中一个亮点是通过Pin Agent让模型自主完成对950PR的硬件适配,约6分钟内一次性通过验证,体现了Agent工具链在国产硬件上手门槛方面的降本潜力。主要局限在于裁剪后的模型无法将推理思考强度开至最高档,且尚未完成深度优化,整体性能暂不及Pro7000平台。这些数据来自个人初步测试,应作为方向性参考,不宜视为严格基准。
单卡128G显存跑通DeepSeek V4-Flash
国产AI推理硬件的进展正在加速。据B站UP主的实测分享,华为昇腾950PR在单卡配置下成功运行了裁剪版的DeepSeek广告 V4-Flash(ds-v4-flash)模型,解码峰值达到208 TPS,相关代码也已经开源。这对于关注国产算力落地的开发者来说是一个值得留意的信号。
从设备信息来看,通过 npu-smi 可以确认该卡为昇腾950PR,配备 128GB 显存。UP主提到这次测试的重点是验证 MXFP4 和 MXFP8 两种低精度格式在昇腾平台上的推理能力,这也是当前大模型推理降本增效的关键路径之一。
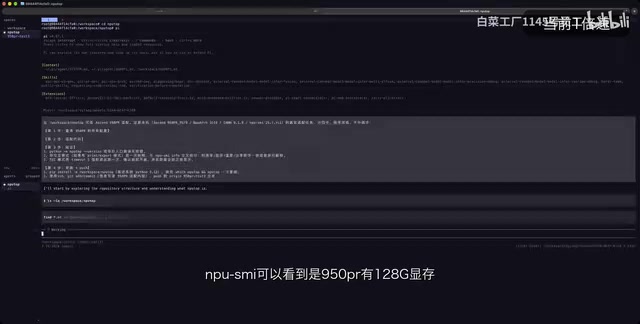
值得一提的是,UP主原本计划使用 VLM(视觉语言模型相关方案),但由于适配复杂度过高而放弃,最终选择了 SGLang 相关的推理栈来完成部署。这类工程取舍在实际落地中非常常见——理论上更强的方案,往往受制于生态成熟度而难以直接上手。
MXFP4 和 MXFP8 是由 OCP(Open Compute Project)规范定义的"微缩放浮点"(Microscaling Floating Point)格式,属于当前大模型推理量化的前沿方向。与传统的 INT4/INT8 量化不同,MX 格式在每组(通常16个)权重上共享一个缩放因子,在极低比特数下仍能保留较好的数值表示范围,从而在压缩显存占用和带宽需求的同时,尽量维持推理精度。MXFP4 将每个参数压缩至4比特,MXFP8 则保留8比特,两者均已被 NVIDIA Blackwell 和部分国产芯片列为原生支持的目标格式。昇腾平台对这两种格式的验证,意味着其硬件指令集和驱动栈已具备相应支持能力,这对于追求低成本、高吞吐推理部署的场景具有实际意义。
显存分配与上下文长度实测
在具体的显存规划上,UP主给出了相对清晰的数据。启动推理服务后,128GB 显存中约 109GB 用于存放全量权重,剩余约 11GB 可用于 KV Cache,可支撑约 800K 的上下文长度。如果再叠加内存进行扩展,单请求解码(Decode)峰值可以达到前文提到的 208 TPS。

在更极限的场景下,UP主报出了一组更激进的数字:约 1.6M 的超长上下文配合 128 并发时,吞吐可以冲到约 3700(推测为聚合 tokens/s)。这组数据反映出裁剪版模型在长上下文与高并发之间的可调空间——通过牺牲部分模型规模,换取显存腾挪与更大的服务容量。
需要说明的是,这些数据来自单一来源的初步测试,属于个人白嫖到的短期试用环境(UP主提到通过活动获得了数百小时的950PR使用时长),并非严格的标准化 benchmark,读者应将其视为方向性参考而非最终定论。
KV Cache(键值缓存)是 Transformer 推理中用于存储注意力机制历史键(Key)和值(Value)张量的显存区域,其大小直接决定了模型能够处理的最大上下文长度。KV Cache 的显存占用与序列长度、层数、注意力头数以及精度格式成正比,因此在权重已占用大部分显存的情况下,剩余空间的分配方式对实际可用上下文窗口影响极大。800K 上下文对应约 11GB KV Cache 的比例,说明该裁剪版模型在架构层面已对 KV 维度做了精简,否则原始规模的 DeepSeek V3/V4 系列模型在同等显存下通常难以支撑如此长的上下文。将内存(CPU RAM)扩展为 KV Cache 溢出区是一种常见的工程手段,代价是访问延迟上升,适合对吞吐要求高、对单次延迟不敏感的批处理场景。
让模型自己完成硬件适配
这次测试中一个有意思的环节,是UP主用 npu-top 相关工具搭配 Pin Agent,让本地模型自己完成对950PR的适配工作。据描述,在开启加速后达到约 6倍速度,模型在约 6分钟内一次性完成了所有适配任务,并顺利通过了 npu-top 的验证测试。
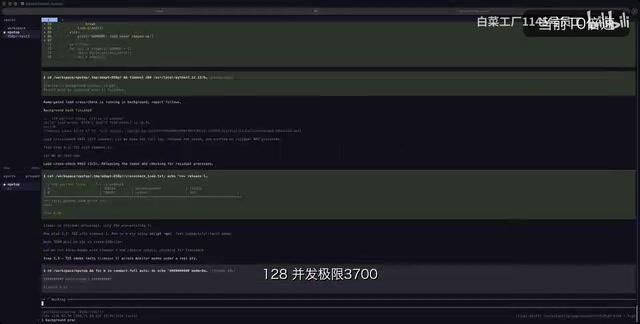
这种"用模型适配硬件、再用硬件跑模型"的闭环,某种程度上体现了当前 Agent 工具链在工程自动化上的潜力。让模型自主处理繁琐的环境适配,能显著降低国产硬件的上手门槛——这恰恰是昇腾生态过去被诟病的痛点之一。
Pin Agent 是一类基于大模型的自动化工程 Agent,核心思路是将繁琐的环境配置、驱动适配、参数调优等任务描述为自然语言指令或结构化工具调用,由模型自主规划并执行一系列命令行操作,最终完成目标验证。在国产 AI 芯片场景中,这类工具的价值尤为突出——昇腾等平台的软件生态文档分散、接口变动频繁,人工适配往往需要大量试错。通过 Agent 自动读取错误日志、检索文档、生成修复脚本并反复验证的方式,可以将原本需要数小时乃至数天的适配工作压缩至分钟级。这也是当前"模型驱动的 DevOps"方向的一个具体落地案例。
遗留问题与后续计划
UP主也坦诚地指出了本次测试的局限。最主要的遗憾是,裁剪后的模型无法将思考强度开到 MAX 档位,否则很容易陷入推理循环。这说明模型裁剪在压缩体积、提升吞吐的同时,也不可避免地损失了部分推理稳定性,长链条思考能力受到影响。

此外,UP主提到目前还在尝试用950PR跑更高规格的模型,但速度暂时不及 Pro7000 平台,且尚未进行深度优化。换言之,208 TPS 是在未充分调优状态下取得的成绩,仍有进一步压榨的空间。
代码已经开源,UP主表示后续会做一期更详细的评测。对于希望在国产算力上验证大模型推理方案的团队而言,这类开源实践提供了可复现的起点,值得持续关注其优化进展。
小结
昇腾950PR单卡跑通裁剪版 DeepSeek V4-Flash 并开源,是国产推理硬件生态里一个务实的落地案例。128GB 显存、200+ TPS 的单卡解码、百万级上下文的并发能力,配合 Agent 自动适配的工程思路,勾勒出国产算力从"能跑"到"好用"过渡的一个片段。当然,模型裁剪带来的推理强度限制、以及尚未深度优化的现状,也提醒我们对这些初步数据保持理性预期。
相关推荐
OpenAI遭遇黑客入侵 Altman面临法律风险累积
OpenAI在内部调查中发现系统遭黑客入侵,CEO奥特曼同时面临法律风险累积。本文梳理AI公司数据安全隐患、企业治理争议与合规挑战,分析事件背后的行业启示。

mcp.so 实用指南:一站式发现MCP服务器扩展AI编程能力
mcp.so 是一个发现 MCP 服务器的目录平台,帮助 AI 编程开发者为智能体连接外部工具和服务。本文介绍它的功能、使用方法以及对 AI 工作流的价值。

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。