生物医学翻译模型压缩实战:体积减69%,推理快98%

联合知识蒸馏与量化,法英生物医学翻译模型体积缩减69%、速度翻倍且质量不损。
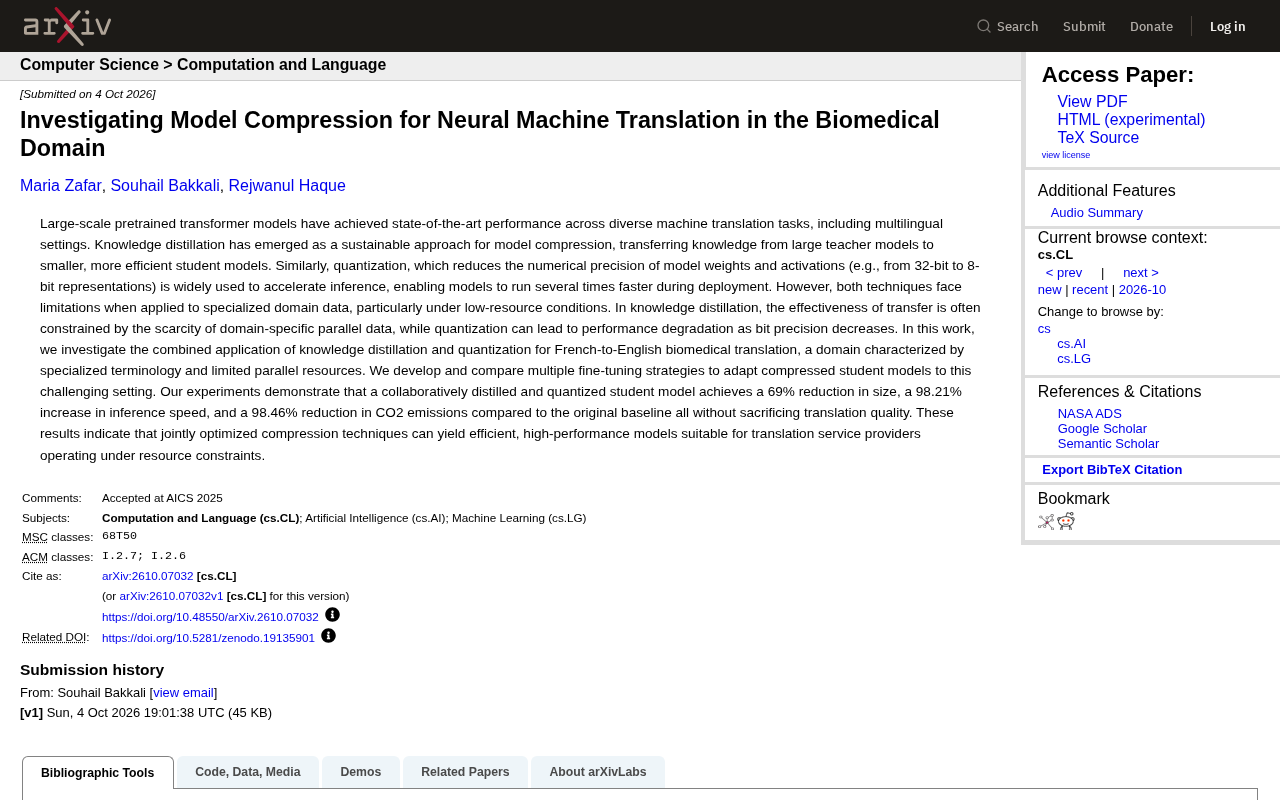
这篇arXiv论文针对法语到英语的生物医学机器翻译场景,将知识蒸馏(用大教师模型指导小学生模型)与量化(降低数值精度以加速推理)两种压缩技术联合应用,并专门设计了针对低资源专业领域的微调策略。实验结果显示,最优的"协同蒸馏与量化"学生模型相比基线体积缩减69%、推理速度提升98.21%、CO2排放减少98.46%,且翻译质量未出现显著下降。研究表明,在专业领域、低资源、部署成本敏感的三重约束下,精心设计的组合压缩策略优于任何单一技术,为资源受限环境中的NMT实用化部署提供了可复用的方法论参考,同时也凸显了模型压缩在绿色AI方向被低估的价值。
大型预训练Transformer模型在机器翻译任务上表现出色,但庞大的体积和高昂的推理成本,让它们难以在资源受限的部署环境中落地。一篇来自arXiv的新论文《Investigating Model Compression for Neural Machine Translation in the Biomedical Domain》给出了一条务实的路径:把知识蒸馏与量化两种压缩技术结合起来,专门针对法语到英语的生物医学翻译场景进行优化,并在不牺牲翻译质量的前提下取得了惊人的效率提升。
为什么生物医学翻译是个硬骨头
生物医学领域的机器翻译有两个绕不开的难点。一是专业术语密集,药品名、解剖结构、疾病分类等词汇对翻译准确性要求极高,一个术语译错可能带来严重后果。二是平行语料稀缺——相比新闻、通用对话这类语料丰富的领域,生物医学的高质量双语对照数据本就有限,低资源条件下模型很难学好。
这两点恰恰放大了压缩技术的短板。知识蒸馏依赖足够的领域数据把大模型(教师)的知识迁移给小模型(学生),数据越少迁移效果越打折;而量化在降低数值精度(如从32位降到8位)时,位宽越低越容易带来性能退化。换句话说,单独用任何一种压缩手段,在这种专业低资源场景下都可能失效。
低资源(low-resource)在NLP语境中通常指可用的双语平行语料少于数十万句对,有时甚至不足万句。与此对比,通用领域翻译模型往往在数亿乃至数十亿句对上预训练。生物医学领域受限于专业文献获取门槛高、标注成本大,公开可用的法英平行语料主要来源于Medline摘要、临床试验注册信息等,总量通常在百万句对量级,远低于新闻或网页语料。这种稀缺性意味着领域适配(domain adaptation)和知识蒸馏的训练信号都更加噪声敏感,微调策略的设计空间也因此更窄、容错率更低。
两种压缩技术的组合拳
论文的核心思路是把知识蒸馏和量化联合使用,而不是各自为战。
知识蒸馏解决的是「把大模型变小」的问题:用一个大型教师模型指导一个结构更精简的学生模型学习,让小模型尽可能复刻大模型的翻译能力。量化解决的是「让计算更快」的问题:通过降低权重和激活值的数值精度,大幅加速推理过程,使模型在部署时能跑得快好几倍。
研究者没有停留在简单叠加,而是开发并对比了多种微调策略,专门针对如何把压缩后的学生模型适配到这个高难度场景。这一步是关键——在低资源领域,微调策略的选择往往决定了压缩模型能否保住质量底线。他们提出的「协同蒸馏与量化」学生模型,正是在这些策略对比中胜出的方案。
知识蒸馏的理论基础源自Hinton等人2015年的工作:大模型(教师)输出的"软标签"(即各类别的概率分布)包含了比硬标签更丰富的结构信息,例如模型对近义词之间相似度的隐式编码。学生模型通过拟合这些软标签,而非直接拟合真实答案,能以更紧凑的参数量习得教师模型的泛化能力。在机器翻译中,这一过程通常体现为词级别或序列级别的分布匹配。
量化则是将模型权重和/或激活值从浮点数(通常为FP32)压缩为低位整数(INT8、INT4等)。INT8量化在精度损失极小的情况下可将内存带宽需求减半、推理吞吐提升约2倍,是目前工业界最成熟的部署加速方案。两者的协同之处在于:知识蒸馏可以在量化引入精度误差之前,先将模型结构精简到更易量化的形态,从而减少量化对最终翻译质量的冲击。
实验结果:效率与质量的双赢
论文给出的量化成果相当直观。与原始基线模型相比,经过协同蒸馏和量化的学生模型实现了:
- 体积缩减 69%,大幅降低存储和内存占用
- 推理速度提升 98.21%,接近翻一倍的加速
- CO2 排放减少 98.46%,显著降低碳足迹
最重要的是,这一切都是在不牺牲翻译质量的前提下实现的。对于需要处理大量专业文档的翻译服务提供商来说,这意味着可以用更小的硬件开销、更低的能耗,提供同等水准的翻译服务。
这里的碳排放数据尤其值得关注。随着大模型训练与推理的能耗争议日益突出,模型压缩不再只是性价比问题,而是可持续AI的重要一环。近乎98%的碳排放削减,说明压缩技术在绿色AI方向上有着被低估的价值。
对实际部署的启示
这项研究的意义不止于一组漂亮的数字。它验证了一个值得推广的工程范式:在专业领域、低资源、部署成本敏感的三重约束下,联合优化的压缩技术比单一技术更能兼顾效率与性能。
对翻译服务商、医疗信息化厂商乃至任何需要在边缘或受限环境部署NMT模型的团队而言,这提供了可复用的方法论——先用知识蒸馏压缩模型结构,再用量化加速推理,配合针对领域数据设计的微调策略,就有机会在不损失质量的情况下大幅降本增效。
当然,论文聚焦的是法英生物医学单一语向,其结论能否推广到其他语言对、其他专业领域仍需进一步验证。但它至少证明了一点:模型压缩在专业领域并非只能做「减法」上的妥协,精心设计的组合策略同样可以做出「加法」上的收益。
小结
这篇论文为专业领域的高效机器翻译部署提供了一个扎实的参考样本。在大模型军备竞赛的背景下,如何让模型「瘦身」却不「掉智商」,正变得与追求更大规模同等重要。知识蒸馏加量化的协同方案,或许正是资源受限团队走向实用化落地的一条可行之路。
相关推荐

扎克伯格新片口碑两极,微软Surface全押AI开发
扎克伯格新片《The Social Reckoning》口碑两极,烂番茄68分难复刻《社交网络》。微软发布全押AI开发的Surface Laptop Ultra,起售价2600美元;苹果或携手LG进军智能家居。

Nano Banana 2.1 使用教程:在 Google AI Studio 中快速找到并体验
想在 Google AI Studio 里体验超写实图像模型 Nano Banana 2.1,却找不到入口?本教程详解查找路径:进入 Playground,打开右侧模型选择器,点击 Images 标签即可选中这个付费模型,并附人像生成实测效果分析。

Claude Haiku 5.5发布:最便宜最快的小模型来了
Anthropic发布Claude Haiku 5.5,号称最便宜最快最强的小模型。价格比上一代降约75%,输入每百万token仅10美分,计算机使用能力从16%提升至72%,并首次引入effort成本调节设置。