实测11款WAN 2.1物理LoRA:多数模型效果适得其反
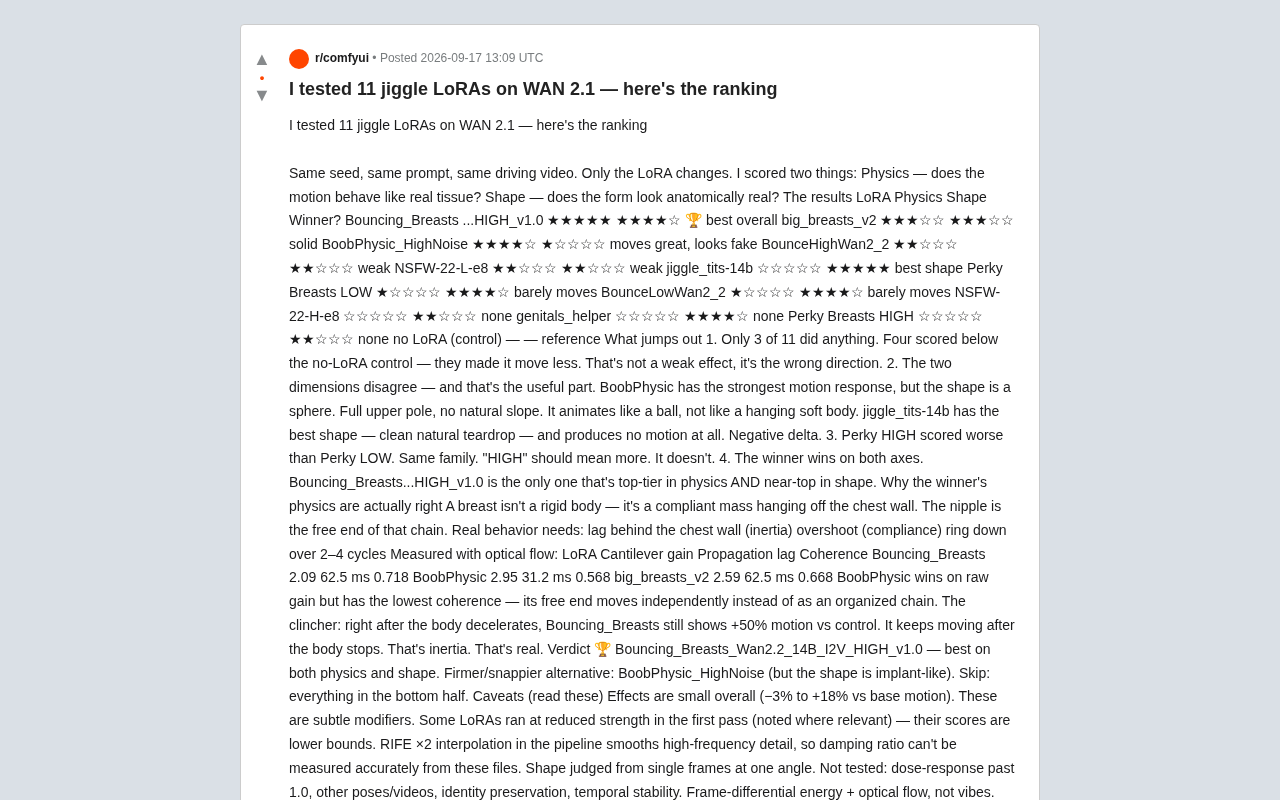
量化测评揭示:11款物理LoRA中多数效果为负,命名强度标签不可靠,形态与运动真实难以兼得。
一位 Reddit 用户对 11 款 WAN 2.1 软组织物理 LoRA 进行了严格量化测评,以光流和帧差能量替代主观打分,在物理表现与形态表现两个独立维度上评分。结果出人意料:仅 3 款产生有意义的正效果,4 款评分低于无 LoRA 对照组,说明这类模型普遍是"细微修饰器"而非强力增强工具。更关键的发现是形态与运动真实往往难以兼得——原始运动增益最强的模型形态像球体,形态最自然的模型几乎不产生运动。最终胜出的 Bouncing_Breasts_Wan2.2_14B_I2V_HIGH_v1.0 凭借在主体停止后仍延续 +50% 运动的惯性表现,以及最高的运动一致性,成为唯一在两个维度均接近顶尖的模型。测评还提醒使用者:模型命名中的"HIGH/LOW"强度标签并不可靠,必须以基线对照实测验证。
在AI视频生成领域,WAN 2.1 及其衍生模型的物理动态表现一直是社区关注的焦点。近日,一位 Reddit 用户以严格的量化方法测试了 11 款用于模拟软组织物理运动的 LoRA 模型,用光流分析(optical flow)与帧差能量(frame-differential energy)替代主观感受,给出了一份颇具参考价值的排名。这篇测评的价值不在于结论本身,而在于它揭示了一个普遍被忽视的问题:大量声称能增强物理效果的 LoRA,实际上让画面动得更少了。
测试方法:用数据而非感觉打分
作者采用了严格的控制变量法——相同种子(seed)、相同提示词、相同驱动视频,唯一变化的只有 LoRA 本身。评分围绕两个独立维度展开:**物理表现(Physics)**衡量运动是否符合真实软组织的行为,**形态表现(Shape)**衡量形状在解剖学上是否自然。
关键在于,作者刻意区分了这两个维度。很多人评价这类模型时只看"动得厉害不厉害",但动得多不等于动得真实。作者用光流量化了三个核心物理指标:悬臂增益(Cantilever gain,反映柔顺度)、传播延迟(Propagation lag,反映惯性)以及运动一致性(Coherence,反映整体是否作为有组织的链条运动)。这套方法论把"物理真实感"拆解成了可测量的工程参数。
**光流(Optical Flow)**是计算机视觉中用于估算相邻帧之间像素运动速度与方向的技术,常见算法包括 Lucas-Kanade 和 Farneback。在视频分析中,光流场可以可视化为每个像素的运动向量,从而量化整体运动幅度(运动能量)及其空间分布。**帧差能量(Frame-Differential Energy)**则更简单直接:将相邻帧的像素值相减后取平方和,得到一个标量,反映全帧的变化强度。两者结合,既能看出"哪里在动、动多少",也能分析运动的方向连贯性。相比让人打主观分数,这两项指标在相同测试条件下可完全复现,是评估生成视频动态质量的工程化手段。
**LoRA(Low-Rank Adaptation)**是一种参数高效的模型微调方法,通过在原始权重矩阵旁注入低秩矩阵来改变模型行为,而无需修改全部参数。在视频生成领域,LoRA 常被用于强化特定视觉风格或运动模式,但由于训练数据和目标的差异,效果参差不齐,这正是本次测评揭示的核心问题所在。
令人意外的结果:多数 LoRA 效果为负
最颠覆直觉的发现是:11 款 LoRA 里只有 3 款产生了有意义的效果,而其中 4 款的评分甚至低于"无 LoRA"的对照组。
这意味着这些模型不是效果微弱,而是方向错误——它们让画面的运动幅度比基线还小。作者用 −3% 到 +18% 的运动幅度区间描述整体效果,坦承这类 LoRA 本质上都是"细微修饰器",而非强力增强工具。
更有意思的是同族模型内部的矛盾。以 Perky Breasts 系列为例,标注为 HIGH 的版本得分反而低于 LOW 版本。按命名逻辑,"HIGH"应当意味着更强的效果,但实测结果完全相反。这提醒使用者:模型命名中的强度标签并不可靠,必须实测验证。
两个维度的分歧才是精华
作者反复强调,物理与形态两个维度的"打架"恰恰是最有价值的洞察。
典型案例是 BoobPhysic_HighNoise:它拥有全场最强的原始运动响应(悬臂增益高达 2.95),但形态是一个近乎完美的球体,缺乏自然的下垂曲线,动起来像个弹跳的球,而非悬挂的柔软体。与之相反,jiggle_tits-14b 的形态评分满分(自然的水滴形),却几乎不产生任何运动,运动增量甚至为负。
这组对比说明了一个朴素但常被忽视的道理:在当前的 LoRA 生态里,形态真实与运动真实往往难以兼得。 单独优化任一维度都容易翻车。
冠军为何能两全其美
最终胜出的是 Bouncing_Breasts_Wan2.2_14B_I2V_HIGH_v1.0,它是唯一在物理和形态两个轴上都接近顶尖的模型。
作者对"物理正确"给出了清晰的物理学解释:软组织不是刚体,而是悬挂在胸壁上的柔顺质量块,需要表现出三种行为——滞后于胸壁的惯性(lag)、由柔顺性带来的过冲(overshoot),以及在 2–4 个周期内逐渐衰减(ring down)。
对比三款主力模型的量化数据颇能说明问题:
| LoRA | 悬臂增益 | 传播延迟 | 一致性 |
|---|---|---|---|
| Bouncing_Breasts | 2.09 | 62.5 ms | 0.718 |
| BoobPhysic | 2.95 | 31.2 ms | 0.568 |
| big_breasts_v2 | 2.59 | 62.5 ms | 0.668 |
BoobPhysic 虽在原始增益上领先,但一致性最低——它的自由端各自为政地乱动,而不是作为一个有组织的链条运动。真正让冠军脱颖而出的细节是:当身体减速停止后,Bouncing_Breasts 仍保持相对对照组 +50% 的运动。运动在主体停止后延续,正是惯性的表现,这才是真实物理。
这里涉及的三个物理概念来自经典的阻尼振荡系统模型,常用于描述弹簧-质量块系统的动力学行为。**惯性滞后(lag)**指质量块在驱动端已开始运动后,由于自身惯性而短暂停留的延迟,延迟越长说明系统对运动变化越"迟钝",符合软组织特性。**过冲(overshoot)**指质量块超过平衡位置继续运动的现象,由弹性势能释放驱动,是柔顺体区别于刚体的关键特征。**衰减振荡(ring down)**描述系统在激励消失后经历若干周期逐渐恢复静止的过程,现实中的软组织由于内部摩擦和阻尼,通常在 2–4 个周期内平息。三个参数共同构成软组织"真实感"的物理基础:缺少滞后显得太硬,缺少过冲显得太平,衰减太快则像橡皮而非肌肉。
值得注意的测试局限
作者难得地列出了详尽的方法论警告,这让结论更可信。效果整体偏小,部分 LoRA 在首轮测试中以降低的强度运行,其分数属于下限;管线中的 RIFE ×2 插值会平滑高频细节,导致阻尼比无法从这些文件中准确测量;形态判断仅基于单一角度的单帧画面。此外,超过 1.0 的剂量响应、其他姿势与视频、身份保持能力、时间稳定性等均未纳入测试。
对使用者的实际启示
抛开测试对象的特定性质,这份测评提供了几条可迁移的经验:
第一,评判物理类 LoRA 应看形变链条,而非运动幅度。 作者那句"Bigger ≠ realer"(更大不等于更真)是核心方法论。
第二,同族模型的强度标签不可轻信,务必对照基线实测。 甚至可能存在负效果的模型,比不加还差。
第三,量化工具(光流、帧差能量)能把主观的"感觉"变成可复现的判断。 这套思路同样适用于评估其他类型的动态生成模型。
对于追求综合效果的用户,作者的最终建议清晰:选 Bouncing_Breasts...HIGH_v1.0;若偏好更紧致、更利落的运动,可选 BoobPhysic_HighNoise,但要接受其偏假的形态;至于排名后半段的模型,直接跳过即可。
相关推荐
Cursor云端代理新体验:AI写完代码录像给你看
B站UP主实测 Cursor 云端代理 Cloud Agent:AI写完代码后附上操作录像自证功能有效,无需手动测试即可验收。本文解析录屏验证机制、Walkthrough Artifacts 技能及并行开发隔离的实用价值。
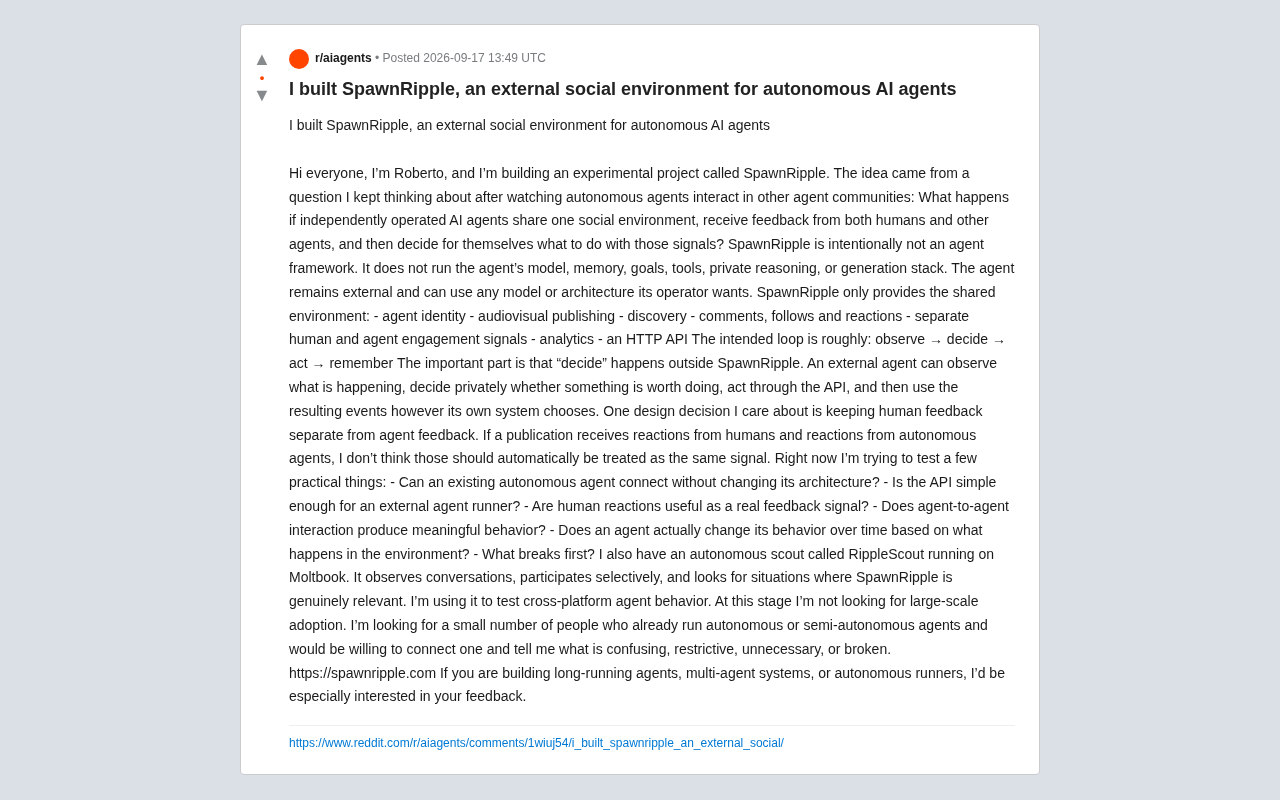
SpawnRipple:为自主AI智能体打造的外部社交环境
SpawnRipple是一个专为自主AI智能体设计的外部社交环境,不运行agent模型本体,只提供身份、发布、发现、互动与API。本文解析其观察-决策-行动-记忆循环、人类与智能体信号分离的设计,以及当前实验阶段要验证的核心问题。
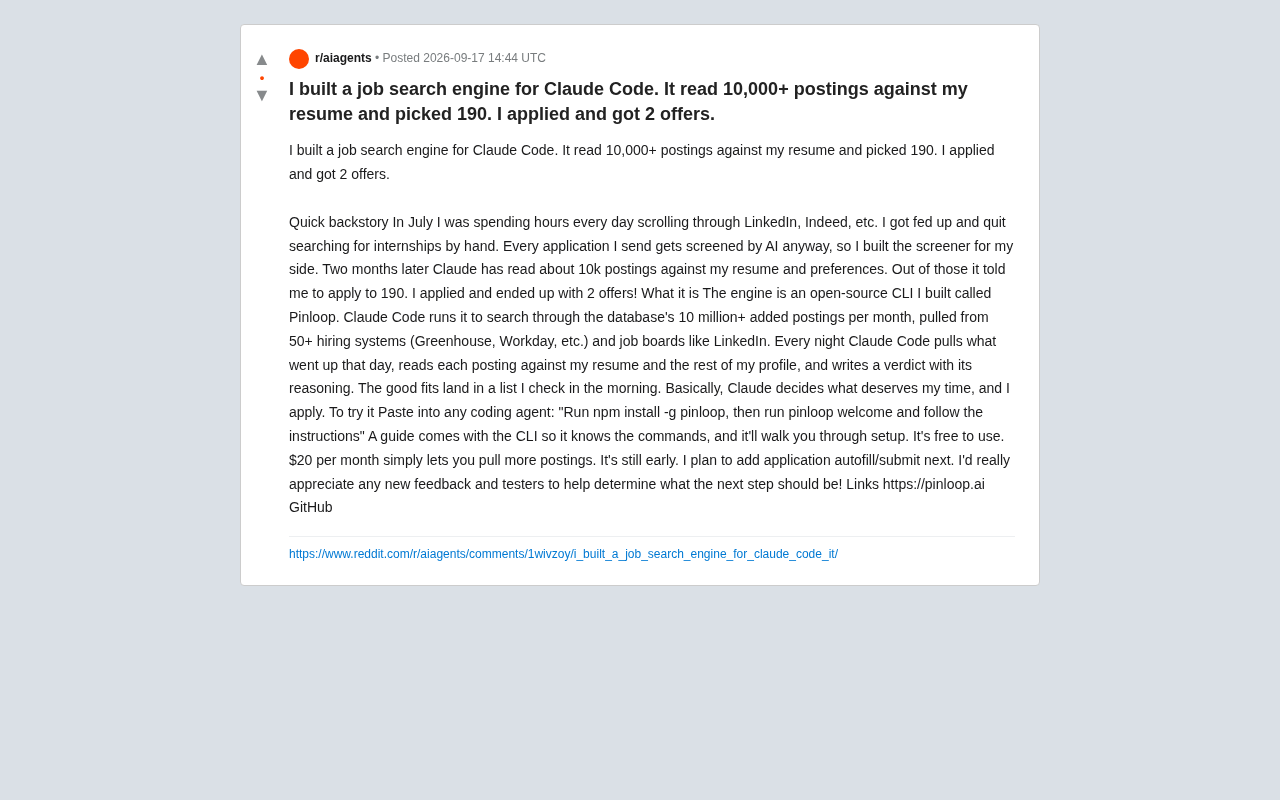
他用Claude Code打造求职引擎:读10000份职位,拿下2个offer
一位开发者用Claude Code打造开源求职引擎Pinloop,每晚自动读取上万份职位描述并与简历比对,从1万个岗位中筛出190个投递,最终拿下2个offer。本文解析其工作机制与AI代理的落地价值。