实测28个Claude Code技能后我只留下这5个

实测28个Claude Code技能后只留5个,筛选标准是token是否配得上结果改变。
一位开发者实测28个Claude Code技能后仅保留5个:ponytail(写最少能跑的代码)、caveman(用更少token表达)、graphify(将代码库转为可查询知识图谱)、grill-me(按需对方案进行尖锐追问)和ui-ux-pro-max(补充界面设计智能)。筛选的唯一标准是:该技能加载的token是否配得上它带来的结果改变。文章指出,随着大模型快速吸收过去需外部框架才能实现的能力,Superpowers、GSD这类完整方法论框架已显冗余,其余被移除的技能多属"模型已默认会做"或"两行项目指令即可替代"。作者由此提炼出三条判断问题,并强调技能遵循开放的Agent Skills标准可跨工具使用,但捆绑钩子的插件具有工具特定性,安装前须阅读SKILL.md、检查钩子与遥测行为。
测试了28个Claude Code技能,最终只保留5个
一位开发者在实际工作中试用28个Claude Code技能后,最终只保留了5个:ponytail、caveman、graphify、grill-me和ui-ux-pro-max。这个筛选过程本身比名单更有价值。
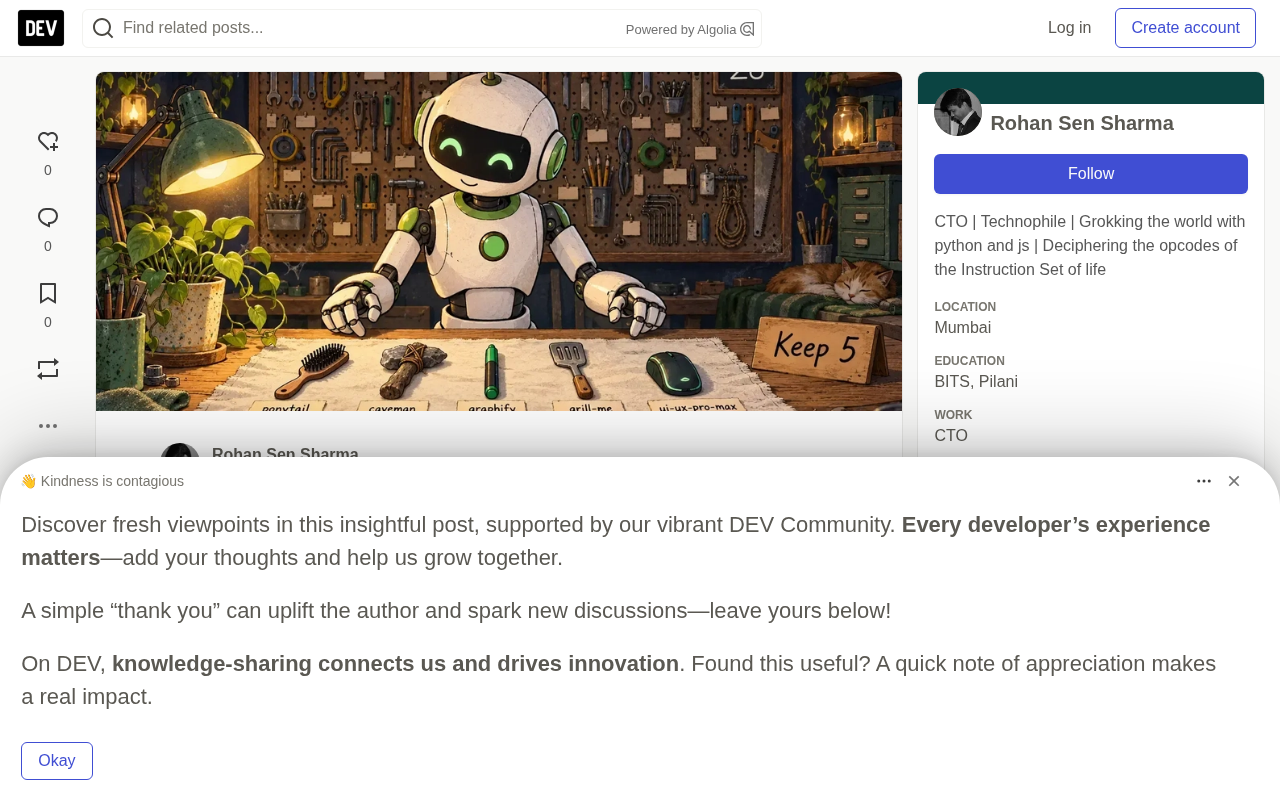
核心理由很直接:每个已安装技能都在消耗上下文窗口,而大模型正在快速吸收过去需要外部框架才能实现的能力。半年前,Superpowers和Get Shit Done这类完整开发方法论框架是让编码智能体学会规划、测试和审查的最快路径;如今这些行为很大一部分已内置到模型中。作者筛选每个技能的标准只有一个:它加载的token,是否配得上它带来的结果改变?
5个值得留下的技能
ponytail:让智能体写最少能跑的代码
ponytail(MIT协议)推动智能体用最少的代码完成工作。据其README,自第5版起实测报告约减少53%代码量、降低26%成本、运行速度提升41%,这些是作者自家基准数据,并非第三方验证。
这款技能解决的问题是LLM普遍存在的“过度生成”倾向——模型倾向于写更多代码来展示能力,而ponytail通过钩子机制在SessionStart、SubagentStart和UserPromptSubmit三个节点介入,把输出拉回到“够用就好”。安装命令为/plugin marketplace add DietrichGebert/ponytail,随后执行/plugin install ponytail@ponytail。
需要注意的是,它通过自动运行的钩子实现功能。在Codex中安装时,需要信任其两个生命周期钩子后才能生效。
钩子(Hook)机制是理解 ponytail 以及后文安全警告的关键。在 Claude Code 这类智能体中,钩子是绑定到特定生命周期事件的自动执行脚本:SessionStart 在会话建立时触发,SubagentStart 在派生出的子智能体启动时触发,UserPromptSubmit 则在每次用户提交提示词后、模型生成回复前触发。钩子的特点是不经过模型判断即自动运行,因此可以在提示词到达模型之前对其做改写(ponytail 正是借此把"写更多"的指令压缩成"够用即可"),但它也意味着脚本以用户权限静默执行——这正是原文强调"安装前要检查钩子"的原因。
caveman:用更少token说清楚
caveman(Apache-2.0协议)让智能体用简洁、克制的英语表达,同时保持代码精确性。可选的本地代理还能压缩智能体读取的内容,如日志、JSON和测试输出。据其README,在54次Claude Code运行中,输入token减少了33.2%。
隐私层面有两个事实值得注意:代理运行在本地机器上,位于智能体与模型API之间,使用你自己的密钥;独立的caveman CLI默认发送使用统计——命令、token计数、随机安装ID、操作系统和IP,但绝不包含提示词或代码。可通过caveman telemetry off或设置DO_NOT_TRACK=1关闭。技能本身不发送任何数据。
graphify:把代码库变成可查询的知识图谱
graphify(Apache-2.0协议)将代码库、文档、SQL模式和PDF转化为可查询的知识图谱,输出为graph.html、GRAPH_REPORT.md和graph.json,通过/graphify命令查询。代码用tree-sitter在本地解析,不离开机器;文档和媒体则通过你配置的模型或API密钥处理。
它的价值在于让智能体不必在每次任务时都重新理解大型代码库的结构。不过该项目目前有约1500个未解决issue,README也指向了付费的graphify.com平台,维护节奏值得关注。
grill-me:对方案进行不留情面的追问
grill-me属于Matt Pocock的技能集合(MIT协议),执行“对方案或设计进行不留情面的面试”。它会将任务交给一个追问技能,分轮次提出尖锐问题,每轮附带可接受或覆盖的推荐答案。
这款技能设置了disable-model-invocation: true,不会自动加载,只有你主动调用时才运行。这意味着它对上下文窗口的日常开销为零,却能在关键决策点提供结构化的压力测试。这种“按需加载”模式,恰恰是作者认为技能应该遵循的设计哲学。
安装方式为/plugin install mattpocock-skills,它已进入Claude Code官方市场。
ui-ux-pro-max:懂模式的设计辅助
ui-ux-pro-max(MIT协议)为跨平台界面构建添加设计智能。2.0版本引入了设计系统生成器,能针对项目提出模式、配色方案和行动号召的位置建议。
对于需要快速产出可用界面的开发者来说,这款技能填补了通用编码模型在设计决策上的短板。安装命令为/plugin marketplace add nextlevelbuilder/ui-ux-pro-max-skill,随后执行/plugin install ui-ux-pro-max@ui-ux-pro-max-skill。
被移除的23个技能,以及背后的判断框架
被移除的名单中有两个大名字:Superpowers和Get Shit Done(现以GSD Core继续)。两者都是优秀框架——Superpowers是建立在可组合技能之上的完整开发方法论,GSD是元提示和规范驱动开发系统。半年前它们让智能体以自身无法实现的方式规划、测试和审查,作者当时都在使用。
变化来自模型本身。这些框架所做的很多事情现在已内置。此外,完整方法论加载到每个会话中,与“只加载能改变结果的少数技能”的原则直接冲突。其余被移除的技能大多属于同一类:模型现在默认会做的事,或者作者可以用两行项目指令描述清楚的事。
这个判断框架可以提炼为三个问题:
- 模型现在是否已经默认做到了?
- 我能否用简短的项目指令替代?
- 它带来的结果改变,是否值得每次会话都加载?
**上下文窗口(Context Window)**是整篇文章的核心成本变量。它是模型单次推理能够同时"看见"的 token 总量,包含系统提示、技能说明、历史对话、读入的文件与工具输出,所有内容共享同一配额。这意味着技能并非"免费插件":每个常驻技能的 SKILL.md 及其描述都会在每次会话中占用一段固定 token,被挤出的空间直接减少了可用于代码本体的容量,还会稀释模型对真正重要指令的注意力。这正是作者用"token 是否配得上结果改变"作为唯一筛选标准的原因,也解释了为何 grill-me 的按需加载(disable-model-invocation: true)被特别称赞。
技能与Codex的兼容性
大多数技能可以跨工具使用。技能遵循开放的Agent Skills标准:一个包含SKILL.md文件和可选脚本的文件夹。Codex从仓库中的.agents/skills和用户目录的~/.agents/skills读取技能,用$skill-name调用。
插件因可捆绑钩子和命令而具有工具特定性,因此需查找每个项目的Codex安装方式。上述五个技能目前都有Codex安装路径。
Agent Skills 标准是 Anthropic 于 2025 年提出的开放约定,用于在不同智能体产品之间复用同一份技能定义。其最小单元是一个文件夹,其中 SKILL.md 以 YAML frontmatter 声明元数据(如名称、描述、是否允许模型自动调用),后可跟任意脚本、模板或参考文档。标准刻意保持极简,只规定"如何描述一个流程",不规定宿主如何执行,因此 Claude Code、Codex 乃至第三方工具都能读取同一目录。而**插件(Plugin)**是更高一层的打包单位,除技能外还可捆绑钩子、斜杠命令和市场源信息,一旦涉及钩子便与宿主的事件模型强绑定,跨工具复用性随之下降。
安装技能安全吗?
技能是指令加可选脚本,以你的权限运行。安装前建议:
- 阅读SKILL.md。 它很短,会明确告诉你技能要求模型做什么。
- 检查钩子。 钩子在事件触发时自动运行,不会提示。ponytail的Codex插件就要求你信任两个钩子。
- 检查遥测和网络调用。 caveman CLI是一个正面例子,它明确告知发送什么以及如何停止。
- 优先选择许可证清晰、维护活跃的项目。 上述所有技能均为MIT或Apache-2.0协议,且在作者检查时处于活跃维护状态。
遥测(Telemetry)与供应商中立性是此处容易被忽略的两个维度。遥测指工具在后台回报的使用数据,范围可大可小:caveman 的独立 CLI 上报命令名、token 计数、随机安装 ID、操作系统与 IP,但明确排除提示词和代码,属于相对克制的做法,且提供了 caveman telemetry off 与 DO_NOT_TRACK=1 两种退出开关。判断一个技能是否安全,除原文列举的要点外,还可关注:脚本是否发起外部网络请求、是否读取 ~/.ssh 或环境变量中的密钥、依赖是否锁定版本。凡以"便利"为名要求无关权限的技能,都应先审计再安装。
常见问题
最好的Claude Code技能是哪些? 在测试28个后,保留的五个是:ponytail用于写更少代码,caveman用于更简洁输出,graphify用于代码库知识图谱,grill-me用于压力测试方案,ui-ux-pro-max用于界面设计。最佳集合应该很小,因为每个已安装技能都在争夺上下文。
Claude Code技能能在Codex中工作吗? 大多可以。技能遵循开放的Agent Skills标准,Codex从.agents/skills读取。捆绑钩子或命令的插件具有工具特定性。
技能和MCP服务器有什么区别? 技能教Claude一个流程,比如如何审查代码或规划功能;MCP服务器给Claude访问另一个系统的能力,比如GitHub或数据库。技能改变Claude知道什么,MCP服务器改变它能触及什么,许多工作流两者并用。
更少技能,更好结果
模型会继续吸收今天技能所添加的能力,这份名单还会继续缩小。真正持久的习惯是背后那个问题:这个技能对结果的改变,是否足以让它在每次会话中都占有一席之地?
如果只能保留一个技能,你会选哪个?
本文基于nulltensor.com发布的实测文章编译整理。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。