实测5款顶级AI Token套餐:谁才是性价比之王?
作者实测五款顶级AI套餐后,推荐用OpenCode多开GitHub账号的方案兼顾速度与价格。
作者作为AI编程重度用户,先后购买并实测了GLM MAX、MiniMax Ultra、ChatGPT $200、阿里百炼尊享版以及DeepSeek按量付费共五款高额度套餐。综合速度、额度与价格三个维度,各方案均存在明显短板:GLM MAX高强度下4-5天耗尽、MiniMax Ultra稳定性差、DeepSeek涨价后月费可达1200元、ChatGPT国内响应偏慢。廉价低倍率中转站因限速问题体验极差同样不推荐。最终作者唯一推荐的方案是OpenCode多开GitHub账号——注册多个账号并行使用,五个账号合计约350元,在速度、并发和价格之间取得最佳平衡。
作为一个长期高强度使用AI编程工具的重度用户,我先后购买了市面上五款最高额度的Token套餐,涵盖国内外主流大模型平台。经过实际的高负载使用,我对每款套餐的速度、额度和价格都有了切身体会。这篇文章分享我的真实感受,以及最终的选择。
五大顶级套餐实测对比
先把结论摆出来:选模型要从三个维度考量——智力(模型能力)、速度、价格。而其中最关键的往往是速度,因为它直接决定了使用体验。就像看视频时卡顿一样,模型响应慢会让人非常难受。
GLM MAX套餐:额度撑不住高强度
GLM的MAX套餐每月要1000多元,按季度购买折算下来每月约860元。它一周的积分是14万,对应大约13亿token。听起来额度不小,但如果是超高强度使用,基本4到5天就用完了。一旦额度耗尽,如果没有备用方案,后面就只能干等。
需要特别提醒的是,它的Fresh版本体验很差、速度非常慢。如果你是冲着Fresh版本去买的,我劝你三思。
MiniMax Ultra:便宜但不稳定
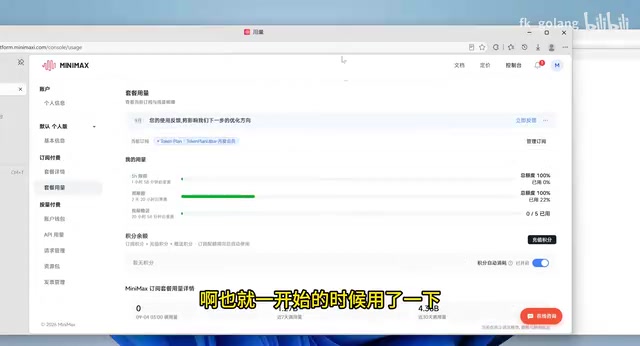
MiniMax的最高等级Ultra套餐价格约469元,相对来说比较划算。我用它消耗了大约43亿token,但基本是初期用得多,后面就很少碰了。
原因在于它的稳定性问题:有时候很快,有时候又很慢,波动明显。大致规律是早上响应快一些,晚上就慢下来。这种不确定性对追求效率的用户来说是硬伤。
ChatGPT $200套餐与阿里百炼尊享版
ChatGPT的200美元套餐能力自然不用多说,但在国内使用需要配合魔法网络,实测响应速度不太理想,偏慢。
阿里百炼的最高套餐尊享版价格高达1400元,25万额度,同样很快就用完。整体体验我感觉和GLM的800多元套餐差不多,性价比并不突出。
DeepSeek按量付费:快,但也烧钱
DeepSeek采用按Token量付费的模式。我从8月6号到8月25号,差不多20天时间消耗了800块钱。这里有个变化节点:8月17号之后DeepSeek涨价了。
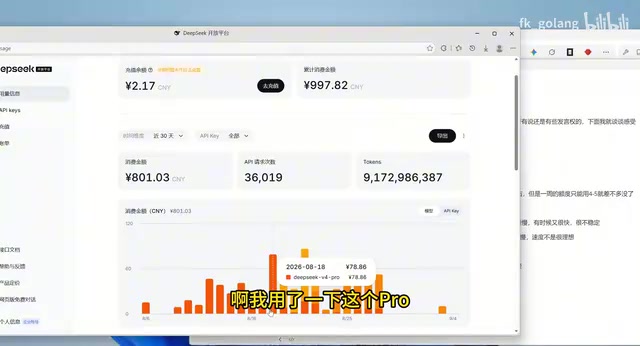
涨价后我试用了两小时Pro版本,直接消耗了78块钱,吓得我赶紧停下来转到Fresh版本。有意思的是,现在的Fresh版本性能比之前的Pro版本还要略高一点,价格也稍贵一丢丢,两者都是40多的水平。
算下来,正常按Token量付费,一个月可能要花到1200元左右,确实很贵,普通用户长期用不太现实。
DeepSeek的定价体系分为输入token和输出token两部分分别计费,且区分缓存命中与未命中场景。「Pro版本」和「Fresh版本」并非官方固定术语,在不同平台或时期可能对应不同的模型版本或服务等级——Pro通常指更强的推理能力版本,Fresh则指优化了响应速度的轻量化变体。2025年8月17日的涨价调整,使得DeepSeek主力模型的输出token价格有所上浮,直接影响了高频调用用户的月度账单。按量付费模式对于使用量波动大的用户相对灵活,但对于每天持续高强度使用的场景,固定套餐的可预期成本往往更具优势,这也是文中横向对比各套餐的核心出发点。
为什么不推荐廉价中转站?
很多人会问,为什么不用中转站省钱?我开了这么多最高额度套餐,中转站自然也试过不少。
我的结论很明确:那种倍率0.0几的廉价中转站体验都非常差,速度慢到离谱。你充了100多块,想一天用完都做不到,因为响应实在太慢。这里说的是低倍率中转站,正规中转站基本按官方价格消耗,不在此列。除非你是学生党、时间充裕,否则真的不建议碰这类中转。
所谓「中转站」,是指第三方平台通过统一API接口,将多家大模型的调用能力打包转售给用户的服务。用户向中转站充值,中转站再代为调用OpenAI、DeepSeek等官方API,从中赚取差价。「倍率」是衡量中转站价格的核心指标:官方价格为1倍,倍率0.1意味着同样的token只需官方价格的十分之一。低倍率之所以体验差,根本原因在于这类平台往往通过超卖、限速、共享低优先级API Key等方式压缩成本——用户表面上省了钱,实际上响应队列被严重拥堵,单次请求可能要等待数十秒甚至超时。对于AI编程这类需要快速迭代、频繁调用的场景,延迟带来的时间损耗远比省下的费用更昂贵。
最终答案:OpenCode多开方案
经过这一轮实测,我唯一推荐的中转是OpenCode,也是本期的主角。
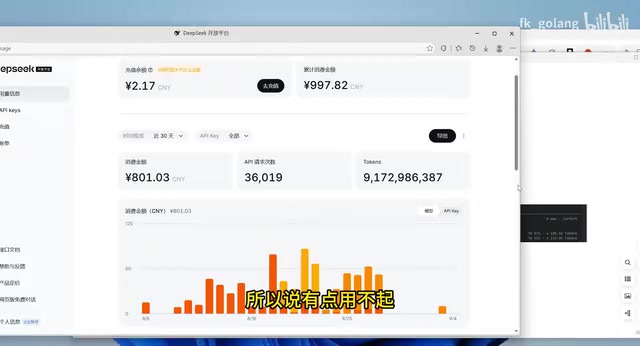
用OpenCode调用DeepSeek,速度非常快,大约3到5分钟就能突破100k,基本和官方持平。但快也意味着烧钱快,所以我20天就干到了800块。
OpenCode只有10美元的套餐。如果你想要极致的响应速度和并发,同时价格又不能太高,那思路就是多开几个账号。
操作其实很简单:注册多个GitHub账号,用一个支付宝就能同时授权多个账号的自动续费。开五个号大约350元左右,基本用不完,比上面任何一个单独套餐都便宜。单个账号如果用DeepSeek Flash,官方标称是37000次请求(我这边36000次消耗了800块,感觉这个数字有水分)。
所以我的建议是尽量多开几个号。我目前开了三个号试水,看能不能把这三个号的额度打满。如果打不满,我会再出一期视频。综合来看,OpenCode多开方案在速度、并发和价格三者之间取得了最佳平衡,可以说是这轮实测中唯一的"真神"。
OpenCode是一个面向开发者的AI代码辅助平台,通过订阅制提供对主流大模型的高速API访问,底层对接DeepSeek等模型。其核心优势在于服务器资源与官方直连,延迟和并发表现接近原生API,而非廉价中转站那种共享限速模式。「100k token」指的是10万个token,token是大模型处理文本的基本计量单位,大约相当于75,000个英文单词或更少的中文字符——3到5分钟内消耗100k,意味着极高的生成速率,适合上下文长、代码块大的编程场景。多账号并行使用的本质是将并发限制分散到多个独立配额池中,避免单账号触发速率限制(Rate Limit)导致的等待,是开发者社区中常见的合规提速方案。
选购建议总结
如果你也是高强度AI用户,选套餐时记住三个原则:不必追求最顶尖的模型(用不起)、速度一定要快(决定体验)、价格不能离谱。对大多数追求性价比的用户来说,与其花千元买单个官方顶级套餐,不如通过OpenCode多开的方式,用更低的成本换来更好的速度和并发体验。
相关推荐
AI递归自我改进RSI:距离真正实现还有多远?
RSI递归自我改进距离真正实现还有多远?本文解析Acer AI的RSI Agent经验积累流程、Shotcut去水印任务实测、OS World 20评测结果,以及OpenAI自动化研究员目标,剖析AI自我改进的现状与关键瓶颈。
三位AI研究者激辩:递归自我改进离我们还有多远?
三位AI研究者(含前OpenAI联合创始人John Schulman)深度辩论递归自我改进与智能爆炸的距离,拆解持续学习瓶颈、蒸馏对抗中心化、RL成功之谜及ASI时间线预测。
AI编程平台爆火:不懂技术也能做出赚钱产品?
一场AI编程竞赛意外吸引1000多人报名,创作者主张不懂技术的人也能用AI coding做出赚钱产品。本文解析AI编程平台的商业化逻辑、行业智能体机会,并理性探讨"程序员要出局"这一激进观点。