实测:Claude Code九次建游戏,哪些Token技巧真省钱
九次构建实测显示,多数省Token技巧已过时,真正有效的只有三条。
一位开发者用 Claude Code 对 Breakout、Snake 和 Space Invaders 各构建三次,比较三种策略的 Token 花费,并用日志代理记录每一分钱。结果显示,遵循全部十条流行省 Token 技巧的 Build B 从来不是最便宜的,只做三处改动的 Build C 反而胜出。最大开销来自会话中途切换模型:Opus 读不到 Sonnet 的缓存,会按 Opus 价格重写整个对话。逐条验证十条技巧后,缓存五分钟失效、改 effort 破坏缓存、MCP 开销大等说法均被证伪,子代理在小任务上更贵,截图贵或省的说法都不准确。真正有效的只有三条:切换模型时开新会话、加简短回答指令、过滤嘈杂输出。
一次严谨的Token消耗实验:九次构建,三种策略
一位开发者用Claude Code做了个很有意思的实测:让AI分别构建Breakout、Snake和Space Invaders三款游戏,每款游戏构建三次,共九次构建。每次都用完全相同的五个提示词,走真实API,并用日志代理记录每一分钱的花费。
三种构建策略分别是:
- Build A:最典型的使用方式——一个长会话,不写CLAUDE.md,装了MCP服务器,用截图传递设计稿,中途切换到Opus模型
- Build B:遵循全部十条流行的省Token技巧——CLAUDE.md里加简短回答指令,每步之间clear,不用MCP,设计用文字描述,Opus用全新会话,测试交给子代理
- Build C:只采用Build A的三个改动——加简短回答指令、过滤嘈杂输出、切换模型时开新会话
结果出人意料:九款游戏全部能运行、全部匹配设计、测试全部通过,但最便宜的构建从来不是遵循全部技巧的那个。
三款游戏的账单:切换模型才是最大开销
Breakout:42美分 vs 73美分
Build A在第三个提示词后就产出了一个带关卡和音效的可玩游戏。然后执行了/model Opus——这一步就花掉39美分。原因是Opus读不到Sonnet的缓存,把整个对话重新写了一遍,近28000个Token按Opus价格计费。更少人提到的是:切回Sonnet跑测试时,对话已经变长,Sonnet又把全部内容重写了一遍。
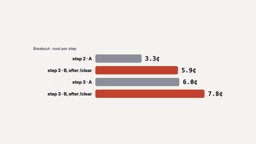
Build B每步之间clear听起来很省,但每次clear都让Claude Code重新写入项目上下文、重读游戏代码,第2、3步反而比Build A更贵。
Build C保持单一会话,只在切Opus时开新会话。三款Breakout的最终账单是73、59、42美分。
Snake:一个Bug暴露了clear的副作用
同样的模式再次出现:Build A中途切Opus花44美分,切回Sonnet又花14美分;Build B反复clear导致中间步骤更贵。
Build B的Snake还有个真实缺陷——页面一打开蛇就开始移动,玩家还没按键就可能输掉。Build C的Snake会等待方向键。账单:71、51、39美分,Build C再次最便宜。
第三关的墙壁渲染也出现分歧:A和C画成长条,B散落成单个方块。同一个提示词,三种理解。
Space Invaders:差距缩小
这是三款中最大的游戏。Build A第一个提示词就用了10次请求、16美分,切Opus又花43美分。
这次Build C赢得不多——它的Opus步骤用了10次请求,是整个测试中抛光步骤里请求最多的,几乎吃掉了全部差距。账单:84、50、49美分,B和C几乎打平。
Build A的Invaders还多出了没人要求的东西:标题画面和静音键,文件16KB,几乎是B和C的两倍。
提示词缓存(Prompt Caching) 是理解这些账单的关键机制。Claude API 允许将对话前缀(系统提示、历史消息)标记为可缓存,后续请求命中缓存时,这部分 Token 按原价约 1/10 到 1/20 计费,而不是全价。但缓存与模型绑定:Sonnet 写入的缓存,Opus 读不到,反之亦然。因此文中 /model Opus 后"整个对话重新写了一遍",就是缓存未命中的直接后果——近 28000 个 Token 全部按 Opus 输入价格重新计费。缓存还有 TTL(生存时间),Claude Code 申请的是 1 小时缓存,这解释了为什么"离开六分钟后仍从缓存读取"。理解这一点,就能明白"切换模型开新会话"为何有效:新会话虽丢失上下文,但避免了用更贵的模型重写全部历史。
十条技巧逐条验证:只有三条站得住
开发者还用同样的日志代理在小规模真实会话上逐条测试了十条流行建议。
被证伪或过时的技巧
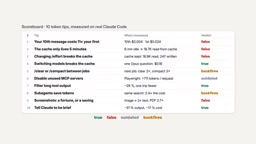
“第10条消息成本是第1条的11倍” —— 在10个短问题中,第1条花2.4美分,第10条不到半美分。绝大部分内容从缓存返回,价格只有原价的二十分之一。这条不成立。
“缓存5分钟后失效” —— Claude Code每次请求都申请一小时缓存。离开六分钟后,下一个问题仍从缓存读取18000个Token。至少在API Key场景下不成立。
“改effort会破坏缓存” —— 执行/effort high后,下一个问题仍从缓存读取19000个Token。不成立,但它会把high存为未来所有会话的默认值。
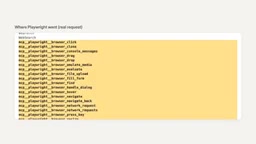
“禁用不用的MCP服务器” —— Claude Code现在按名称列出工具、按需加载。Playwright每次请求只增加700个Token。这条已过时。
“子代理在小搜索上省Token” —— 子代理自带指令和工具,成本是直接做的2.4倍。在小任务上适得其反。
“截图很贵”或“截图省Token” —— 同一页面以文字、截图、PDF三种形式呈现,分别约500、1100、1400个Token。两种说法都不准确。
MCP(Model Context Protocol) 是 Anthropic 推出的开放协议,让 Claude 通过标准化服务器连接外部工具(如 Playwright 浏览器自动化、数据库、文件系统等)。早期实现中,所有 MCP 服务器的工具定义会一次性注入每次请求的上下文,服务器越多,固定开销越大,因此"禁用不用的 MCP"曾是有效建议。但 Claude Code 现在改为按名称列出工具、按需加载完整定义,Playwright 每次请求仅增加约 700 个 Token。这属于典型的"工程优化让旧技巧过时":技巧本身没错,只是工具已经解决了它针对的问题。类似地,子代理(subagent)会携带自己的系统指令和工具集,在小搜索任务上固定成本高于直接执行,所以文中测得 2.4 倍开销。
真正有效的技巧
“切换模型时开新会话” —— 唯一被九次构建反复证实的结论。一次Opus提问在小会话中花18美分,是普通提问的20到60倍。
“让Claude回答简短” —— 一行指令把输出Token减半,账单降低约六分之一。在游戏中它还让代码更短:Build A的Breakout文件约11KB,B和C约8KB。少说话也意味着少写代码。
“过滤冗长工具输出” —— Sonnet经常自己加管道过滤,Claude Code也已限制超大输出,但手动过滤仍能省下一次往返。
关于clear —— 在短任务上,继续对话花1.5美分,clear花3美分,compact花4.5美分。clear只在旧对话又大又已完成时才划算,小任务上会反噬。
实践建议:只做三件事
三次构建加十项单点测试指向同一个结论:大部分流行技巧要么已过时,要么被过度推广。真正值得做的只有三件:
- 切换模型时开新会话——这是唯一在所有游戏中都成立的最大开销来源
- 在CLAUDE.md里加一行简短回答指令——省钱的同时让代码更精简
- 过滤嘈杂的命令输出——仍有实际收益
至于文字描述能否替代截图,测试给出了肯定答案:文字描述的效果和截图一样好。
有一个权衡需要留意:简短回答指令会让Claude写更少的代码。对小型游戏没有代价,但项目变大时需要检查是否丢失了什么。
(本文基于YouTube创作者的公开发布实测整理,所有数值均来自其日志代理记录。)
背景补充
clear、compact 与继续对话 是 Claude Code 管理上下文的三种方式,成本结构不同。继续对话会携带全部历史,但历史可命中缓存,增量计费低;clear 清空会话,下一次请求需要重新写入项目上下文、重读文件,相当于重建缓存;compact 让模型把历史压缩成摘要,本身要消耗一次生成请求,再叠加后续重建成本。所以三者在短任务上的账单是 1.5、3、4.5 美分。判断标准不是"上下文多大",而是"旧上下文是否还有用":已完成且不再引用的大对话,clear 能避免每次请求都携带冗余历史;仍在推进的小任务,clear 反而制造了重建开销。这正是 Build B 每步 clear 却更贵的根本原因。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。