实测:Claude Haiku 5.5 成本竟是 GPT-6 Luna 的12倍

Claude Haiku 5.5在agent场景下因超高token消耗与100k后五倍计费叠加,实际成本是GPT-6 Luna的12倍。
一位开发者用voxel pagoda任务对比了Claude Haiku 5.5与GPT-6 Luna,发现前者的API等效成本高达$24.96,是后者$1.96的约12倍。差距由两层因素叠加形成:Haiku 5.5的输入输出token消耗量均约为Luna的四倍,延续了Claude系列"token吞噬者"的特征;更关键的是,Haiku在上下文超过100k token后API单价直接翻五倍,而agent会话中几乎每轮对话都会超过这一阈值。相比之下,Luna的高价阈值设在272k,且默认启用自动上下文压缩,从机制上规避了高价区间。这一案例揭示了一个核心判断:评估模型成本,不能只看每百万token的标价,必须将token效率、计费阈值与实际工作负载模式综合计算。
一场关于廉价模型的意外翻车
当 Anthropic 推出被定位为"最便宜"的 Claude Haiku 5.5 时,不少开发者期待它能摆脱 Claude 系列长期被诟病的"token 吞噬者"形象。然而一位 Reddit 用户用经典的 voxel pagoda(体素宝塔)测试给出了一个令人意外的结论:在完成同一个任务时,Claude Haiku 5.5 的成本竟是直接竞品 GPT-6 Luna 的 12 倍。
这个结果之所以值得深入讨论,是因为它揭示了一个常被忽视的事实——模型的"单价便宜"和"实际使用便宜"完全是两回事。定价表上的数字,远不足以反映真实工作负载下的开销。
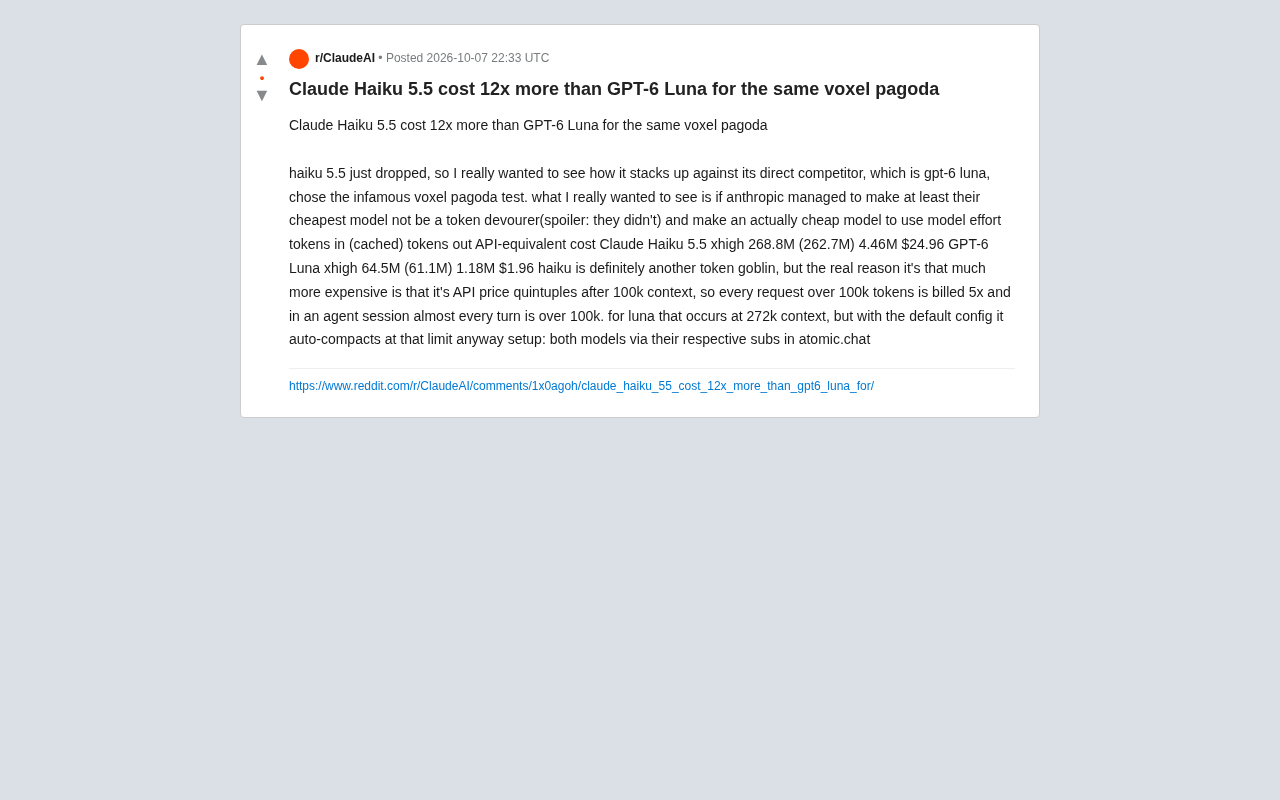
测试数据:差距来自哪里
测试者选择了业界常用的 voxel pagoda 生成任务,两个模型均在 atomic.chat 平台通过各自订阅接入,并均设置为 xhigh 推理强度。实测数据如下:
| 模型 | 推理强度 | 输入 token(缓存) | 输出 token | API 等效成本 |
|---|---|---|---|---|
| Claude Haiku 5.5 | xhigh | 268.8M(262.7M) | 4.46M | $24.96 |
| GPT-6 Luna | xhigh | 64.5M(61.1M) | 1.18M | $1.96 |
从数据可以看出两重差距叠加。首先是 token 消耗量本身:Haiku 5.5 的输入 token 高达 2.688 亿,是 Luna(6450 万)的四倍多,输出 token 也接近四倍。这印证了测试者的判断——Haiku 依旧是个"token goblin"(token 妖怪),并没有如期望般变得精简。
真正的成本黑洞:100k 上下文后的5倍计费
如果只是 token 多了四倍,成本差距不至于拉到12倍。测试者指出,真正的罪魁祸首是 Claude Haiku 5.5 在上下文超过 100k token 后,API 价格会直接翻五倍。
这个阈值在实际的 agent(智能体)工作流中几乎形同虚设。在一个连续的 agent 会话里,几乎每一轮对话的上下文都会轻松突破 10 万 token,这意味着绝大多数请求都在以五倍单价计费。四倍的 token 量再乘以频繁触发的五倍计费,最终叠加出了那个惊人的12倍成本差。
相比之下,GPT-6 Luna 的高价计费阈值被设定在 272k token,门槛高出近三倍。更关键的是,在默认配置下,Luna 到达该上限时会自动进行上下文压缩(auto-compact),从机制上主动规避了触发高价区间的风险。
阶梯式上下文计费(tiered context pricing)是近年大模型 API 普遍采用的定价策略:供应商以某个 token 长度为分界线,低于该长度按标准单价计费,超过后切换到更高单价。这一设计的商业逻辑在于,处理超长上下文对算力(尤其是 KV cache 显存)的消耗远超线性增长,因此供应商倾向于通过价格信号让开发者主动控制上下文长度。对于以单次问答为主的应用,阈值往往不会被触达;但在 agent 场景中,每一轮工具调用的结果、历史对话、系统提示都会被拼入上下文窗口并随轮次线性累积,导致几乎每次请求都处于高价区间。因此,阶梯计费的实际影响完全取决于应用的上下文增长模式,而非模型的标价本身。
对开发者的现实启示
这次对比给实际构建 AI 应用的开发者提供了几条值得记住的经验。
定价阈值比单价更重要。 很多模型采用阶梯计费,低上下文时单价诱人,但一旦跨过某个 token 门槛,成本会非线性飙升。在选择模型前,务必确认这个阈值在哪里,以及你的典型工作负载是否会频繁越过它。
Agent 场景放大一切成本。 单次问答可能永远触不到 100k 的红线,但 agent 会话会不断累积上下文。如果你的产品形态是多轮自主执行的智能体,上下文增长模式几乎决定了最终账单。
自动压缩机制是实打实的省钱设计。 Luna 的 auto-compact 并非锦上添花,而是在高价阈值处主动踩刹车的关键功能。缺乏类似机制的模型,需要开发者自行实现上下文管理来控制开销。
需要说明的是,本文结论来自单一 Reddit 用户的 voxel pagoda 测试,样本有限,不同任务类型下的表现可能存在差异。但它清晰地传递了一个判断:评估模型成本时,不能只看每百万 token 的标价,而要把 token 消耗效率、计费阈值和实际工作负载模式综合起来算一笔总账。对于把"最便宜"写在宣传语里的模型,这笔账尤其值得自己亲手算一遍。
上下文压缩(context compression / auto-compact)是指在上下文窗口接近某一阈值时,自动将历史对话或中间推理结果进行摘要或截断,以减少后续请求的 token 数量。其本质是以少量信息损失换取大幅降低的计费成本。实现方式可分为两类:模型服务商在 API 层面内置的自动压缩(如 Luna 的 auto-compact),以及开发者在应用层自行管理的显式压缩——例如周期性地调用一次摘要请求替换原始历史记录。前者对开发者透明但灵活度低,后者需要额外工程投入但可精细控制压缩时机与策略。对于没有内置压缩机制的模型,开发者若不主动介入,上下文将无限增长,最终持续触发高价阈值。
相关推荐

Claude Code 本地安装全攻略:NPM 装机与防封号实战
Claude Code 本地安装完整教程:涵盖 NPM 安装方式、Node.js 与 Git 前置准备、ccswitch 绕过账户登录防封号实战,以及 DeepSeek Harness、Codex 配置与国内模型选择建议。

Replit携手Databricks:构建受治理的企业级AI应用
Replit 与 Databricks(配合 Lakebase)的组合为企业提供从开发到部署的完整平台,兼顾敏捷开发与数据治理。本文解析这套方案的核心价值、Lakebase 的角色及企业落地时需关注的现实问题。

陶哲轩转发倡议:数学家应停止与OpenAI合作?
菲尔兹奖得主陶哲轩转发"人类数学协会"声明,呼吁数学家停止与OpenAI合作,抵制AI继续攻克开放数学难题。本文解析事件背后AI介入数学研究的伦理争议与深层张力。