实测Claude Opus 5.5、GPT-6 Astra与Gemini 4 Argon:三项目定高下

实测三款顶级模型做三个真实项目:Opus 全胜但最贵,Astra 性价比最高,Argon 最便宜却未入梯队。
博主 Wade 用 3D 二十一点、Blender 涩谷屋顶和 Notion 克隆三个真实项目横评 Claude Opus 5.5、GPT-6 Astra 与 Gemini 4 Argon。结果显示,基准测试中几分到十分左右的差距在真实任务中被放大:Opus 靠辅助代理、逐音节唇形同步、OSM 真实建筑数据和对抗性测试全部胜出,总花费 216.72 美元、近 11 小时;Astra 以约三分之一成本(77.86 美元)提供扎实构建与诚实自报,稳居第二;Argon 成本最低(至少 8.75 美元),但自报帧率不可靠、4K 实为 1080p 拉伸、代理从未打开自己的应用。作者结论是基准排名成立且被放大,但便宜不等于高效。
在基准测试分数只差几分的情况下,三个顶级模型在实际编码任务中会拉开多大差距?YouTube 频道 AI Wade Journey 的博主 Wade 用三个真实项目做了回答:一个带说话荷官的 3D 二十一点游戏、用 Blender 搭建的涩谷 Sky 屋顶场景、以及一个 Notion 克隆应用。结论是:基准排名基本成立,但差距被显著放大。Claude Opus 5.5 三个项目全部胜出,GPT-6 Astra 以约三分之一成本稳居第二,而 Gemini 4 Argon 虽然最便宜,但尚未进入同一梯队。
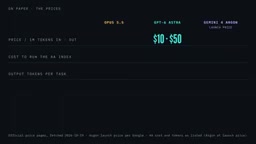
基准测试那几分差距,在真实任务中意味着什么
先看纸面数据。据 Artificial Analysis 的 Intelligence Index,Opus 得分 58,Astra 和 Argon 均为 53;LiveBench 上三者总分差距在 2.5 分以内;在用户投票的 Web 应用排行榜上,Opus 第 1、Astra 第 2、Argon 第 9。有趣的是,在小浏览器游戏类别中 Astra 甚至略胜 Opus。
但有一个数字值得单独拎出来:LiveBench 的长时程 agentic 任务——最接近本次实测场景的指标——Opus 和 Astra 都在 80 分以上,Argon 只有约 70。Wade 的账单结构几乎复刻了这个分数分布:Opus 总花费 216.72 美元,Astra 77.86 美元,Argon 按 Google 发布价至少 8.75 美元。
价格层面,情况有些反直觉:按 token 单价,Astra 是 Opus 的 2.5 倍,Argon 仅为 Opus 的一半。但项目不按 token 计价。运行 Artificial Analysis 全套测试的成本分别约为 Opus 8700 美元、Astra 5300 美元、Argon 2400 美元——Opus 单价更低,总账单更高,因为它做得更多。
Artificial Analysis Intelligence Index 是一个聚合型基准,把来自 MMLU-Pro、GPQA、LiveCodeBench、SciCode 等多个独立评测集的分数标准化后加权合成一个 0–100 的综合分,意在用一个数字概括模型的通用智能水平。它的优点是跨模型可比、更新及时,缺点是权重设计带有主观性,且无法反映模型在特定任务类型(如长时程编码)上的专长差异。因此文章中出现“综合分只差 5 分、但细分 agentic 指标差 10 分以上”的情况并不矛盾——聚合分会掩盖子维度上的真实分化。
LiveBench 则采用另一套思路:题目来自近期竞赛、论文与新闻,并按月更新以防数据污染,同时设有客观可验证的答案。它把任务分为推理、编码、数学、数据分析、语言、指令遵循六类,其中 agentic coding 子项专门考察模型在多步骤工具调用与文件操作中的持续表现,这也是文章反复引用它作为“最接近实测场景指标”的原因。
三个项目的实战细节
第一回合:3D 二十一点与会说话的荷官
任务要求包括真实赌场音效、一位带唇形同步的女性荷官、八句指定台词,以及 60 帧每秒的运行帧率。
Argon 完全从数学构建一切:每个筹码点击、纸牌滑动、爵士和弦都由代码生成。但它自报的 60 帧来自一个上限为 60 的计数器,且是在小型无头窗口中测得,没有任何规则测试。Astra 走真人路线,下载了带 66 个面部形态的 3D 头像,用语音响度驱动嘴型,通过 20 句荷官台词、17 项规则测试和 19 项浏览器检查,并诚实注明“锁定 60 帧未被证实”。Opus 走得最远:1600 行代码从零构建荷官,105 句台词逐音节唇形同步,两个辅助代理分别构建荷官和环境,甚至停下来问 Wade 声音是否自然,并用语音识别验证全部八句台词,在完整 4K 下测得 60 帧。
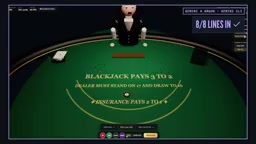
账单:Astra 8 分钟、34.52 美元;Argon 约 1 小时 10 分钟、发布价 3.36 美元;Opus 6 小时 10 分钟、121.89 美元——是 Astra 的 3.5 倍,仅两个辅助代理就花了近 40 美元。
唇形同步(lip sync) 指让 3D 角色的口型与语音音素在时间上对齐的技术。常见做法有两类:一是 viseme 映射,把语音识别出的音素序列映射到预设口型姿态(如 Meta 的 Oculus LipSync、Ready Player Me 的 ARKit 52 blendshape 方案);二是音频驱动的神经网络,直接从波形回归面部系数。文章提到的“66 个面部形态”即 blendshapes,是 ARKit 标准的一套表情参数;“按音节同步”则属于更细粒度的 viseme 级别控制,需要对台词做强制对齐(forced alignment)得到每个音素的起止时间。这也是 Opus 的 105 句台词逐音节同步在工程量上远超 Astra 的原因——后者只用语音响度驱动嘴型开合,属于振幅近似而非音素对齐。
第二回合:Blender 中的涩谷 Sky 屋顶
任务要求搭建涩谷 Sky 屋顶并在黎明雪景中渲染 30 秒电影级画面,建筑结构必须准确,音乐用代码谱写。提示词从未指定分辨率——这成了关键变量。
Argon 的甲板干净低多边形,但周围东京只是平面上的 64 个盒子,富士山是 1.5 公里外的白色圆锥。文件是 4K,帧却不是:画面以 1080p 渲染后拉伸,唯一说明这一点的是代码里的一行注释。Astra 渲染了真正的 4K,约 40 分钟输出 900 帧原生画面,屋顶遵循官方图纸——黄色直升机坪、六根木梁、玻璃边缘——但周围城市是一千个随机盒子,没有富士山,音乐是 123 个手写音符。Opus 从真实数据出发:辅助代理先研究真实甲板并列出无法确认的部分,随后从 OpenStreetMap 拉取超过 22000 栋建筑,使用塔楼真实轮廓与高度,按真实方位放置富士山,并从四个角度对照实景照片校验模型,每个剪辑点都落在音乐小节上。交付时为 1080p/24 帧,Wade 要求 4K 后它修复了一个导致视图全黑的曝光设置并重新渲染,耗时 79 分钟。
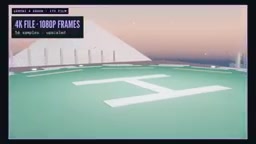
账单:Astra 59 分钟、30.56 美元;Argon 约 3.5 小时、至少 4.17 美元(连接中断 23 次,Wade 确认是 VPN 问题);Opus 3.5 小时含 4K 重渲、69.32 美元。
OpenStreetMap(OSM) 是一个开放协作的世界地图数据库,其建筑数据以多边形轮廓加标签(高度、层数、用途)的形式存储,可通过 Overpass API 按经纬度范围批量拉取。在 3D 场景重建中,OSM 常被用来生成城市白模:把建筑轮廓挤出为体块,高度标签缺失时按层数×3 米估算。文章里 Opus“拉取超过 22000 栋建筑、使用塔楼真实轮廓与高度”,本质是把 OSM 数据导入 Blender 后做程序化建模,这与 Astra“随机生成一千个盒子”的区别在于地理真实性与遮挡关系是否正确。
渲染分辨率与输出分辨率的区别也值得澄清:Blender 中渲染分辨率由场景设置决定,输出尺寸只是最终编码参数,把 1080p 画面拉伸到 4K 不会增加任何细节。识别这一点只能靠检查工程文件或渲染日志,而非成片观感——这正是 Argon 那行代码注释成为关键证据的原因。
第三回合:Notion 克隆
任务是用 React 和 TypeScript 构建 Notion 风格应用,包含嵌套页面、带斜杠菜单的块编辑器、拖拽排序、小型数据库、搜索、深色模式和浏览器内保存。
Argon 写了最多代码、覆盖最广的块类型,但代理从未在浏览器中打开自己的应用,只跑了五个模拟测试。删除页面或点击重置演示,数据直接消失,没有确认也没有撤销。Astra 的应用完成度最高:封面图、收藏、15 秒撤销、可导出导入的备份,31 分钟、12 项数据测试通过,并在 Chrome 中自行点击界面,包括真实鼠标拖拽。Opus 像一支 QA 团队:21 项浏览器测试全部通过,随后派出第二个 Opus 代理攻击应用,找出 14 个 bug——例如在代码块内输入斜杠会破坏代码——全部修复并补充回归测试。
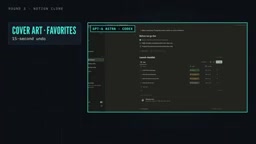
账单:Astra 31 分钟、12.77 美元;Argon 约 31 分钟、1.22 美元(会话时钟显示近 19 小时,其中 17.5 小时是一个命令在等待批准);Opus 1 小时 18 分钟、25.50 美元。
Agentic 编码代理的自我验证能力,指代理能否在交付前主动打开浏览器、点击界面、运行真实交互测试,而非仅依赖它自己编写的单元测试。文章中的分歧正在于此:Argon 只跑了五个模拟测试、从未打开应用;Astra 用浏览器自动化点击了真实界面(包括鼠标拖拽);Opus 更进一步,用第二个代理扮演攻击者对应用做对抗性测试。这一差异对应业界所说的“生成-验证鸿沟”——模型生成代码的能力与其发现自身代码缺陷的能力并不同步,后者依赖是否被赋予浏览器控制、可观测性与多轮自主循环。这也是为什么同一批基准分数下,实际交付质量会被显著放大的机制性原因。
总账与解读:便宜不等于高效
三个项目合计,Opus 216.72 美元、Astra 77.86 美元、Argon 按发布价至少 8.75 美元(全价至少 17.50 美元)。工作时长:Astra 总计约 2.5 小时,Argon 约 5 小时(估算),Opus 近 11 小时。这些是基于会话日志的 API 等价估算,并非订阅实际扣费。
Wade 的核心结论是:Opus 5.5 是这里最强的构建者,适合追求最完整、最经测试的结果且能承担时间与账单的用户;Astra 是紧随其后的价值之选,构建扎实、报告诚实、成本约三分之一;Argon 最便宜,但尚未进入同一梯队。他特别强调“便宜不等于高效”——当每个产出都需要人工复核时,省下的钱会以另一种方式还回去。
需要说明的边界:每个任务只跑一次,三者分别运行在 Claude Code(最高 effort)、Codex(最高档)和 Gemini CLI on Vertex AI(high thinking)中,因此比较的是三套编码代理配置而非纯粹的模型。结果会因环境而异。但在同一套设置下,基准分数的排序在真实工作中不仅成立,而且被放大。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。