实测Gemini 4 Neon:8个场景,真能平替Opus 5.5?

Gemini 4 Neon 跑分第三、擅长编程与长任务,但并非 Opus 5.5 的无脑平替。
文章对谷歌两周内发布的第四个模型 Gemini 4 Neon 做了实测评估。纸面上它在 AEI 智慧指数以 61 分排总榜第三,高于 Opus 5.5 的 59 分,Cursor Bench 4.1 达 65.4%,定价为输入 3 美元、输出 15 美元每百万 Token,缓存命中低至 0.15 美元。八个真实场景测试显示,它在文章转讲解视频、交互式元素周期表、SVG 绘图、代码演奏等任务上完成度高,但 Blender 3D 角色建模这类需要空间精度的任务表现不佳,与多个顶级模型一样卡壳。作者结论是它更像「Kimi K3 的高速版」——推理更快、世界知识更全、节奏更轻,适合作为日常开发主力,而非在所有场景替换 Opus 5.5。
谷歌两周内连发第四个模型,Gemini 4 Neon 的定位相当微妙——官方把它卡在 Carbon 和 Hydrogen 之间,偏重编程和长程任务。网上已有不少声音说它能平替 Opus 5.5,但拿八个真实场景跑了一整天后,结论可能和你想的不太一样。
先给结论:跑分确实排进了前三,但它不是那种「无脑替换」的平替。它更像一个推理更快、世界知识更全、价格相同但节奏更轻的主力开发模型——有人形容它是「Kimi K3 的高速版」。
纸面实力:榜单第三,价格与缓存是亮点
Neon 的官方定位偏编程和长程任务,参数更轻,推理速度明显更快,上下文达到 100 万 Token,思考深度分四档。定价方面,输入 3 美元、输出 15 美元每百万 Token,命中缓存低至 0.15 美元,官方称能省 95%。有 Google AI Pro 或 Ultra 订阅的用户现在就能直接用。
榜单数据上,AEI 智慧指数 61 分,总榜第三,高于 Opus 5.5 的 59 分和 GPT 6.2 的 57 分。Cursor Bench 4.1 为 65.4%,比 Opus 5.5 高 7.3 个百分点;Graphworks 为 95.2%。不过也有两项硬核代码指标 Opus 5.5 仍然略高——Terminal Bench 和 FrontierTier Code。Ties Arena 1518 分排第三,Agent Arena 1333 分,与 Opus 5.5 的 1336 分只差 3 分。纸面数据确实好看,但实际干活才是关键。
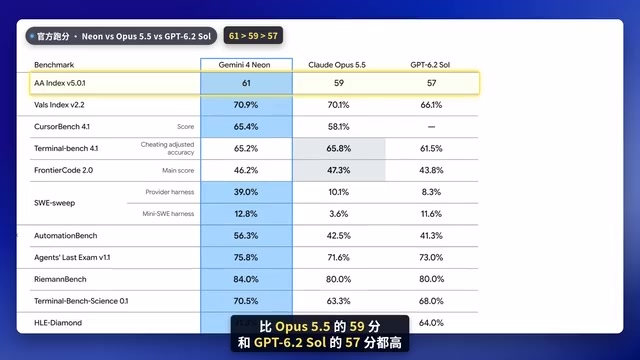
AEI 智慧指数是 Artificial Excellence Index 的简称,一个面向大模型综合能力的第三方评测榜单,通常由多个学科与工程任务加权合成,分数区间大致在 40–70 分之间,因此 61 分与 59 分的差距在实际体验中往往被解读为「同一梯队内的微弱领先」,而非代际差距。
Cursor Bench 则是 Cursor 团队维护的编程基准,重点考察模型在真实 IDE 环境下的多文件编辑、依赖理解与指令遵循能力,采用通过率计分,65.4% 意味着在给定任务集里有约三分之二的用例被判定为可用交付。
提示词缓存(Prompt Caching) 是降低长上下文成本的关键机制:服务端把重复出现的前缀(如系统提示、代码库上下文)缓存起来,后续请求命中时按极低单价计费。文中 0.15 美元/百万 Token 正是命中缓存后的输入价格,相较 3 美元的标准输入价确实接近 95% 的降幅,但前提是请求前缀稳定,否则缓存无法复用。
八个真实场景:能干活,但有边界
文章转讲解视频:九成五可用,剪辑仍需人工
最实用的一个测试,是把一篇 AI 知识管理文章丢给 Neon,让它用代码直接生成讲解视频。第一遍出来的结果就有九成五能用,作为起点完全够用。不过剪辑节奏还得自己再磨,想直接靠它出爆款还差口气。对常年写长文的人来说,这相当于多了一条内容分发的路。
交互式元素周期表与纯代码特效
让它做一张交互式元素周期表,没给设计提示词也没挂任何 skills,点开氖、碳、氢会弹出 3D 原子模型和元素实际形态,布局干净,要求都照做了。纯代码做黑洞穿越——吸积盘、引力透镜、镜头推进的动感都出来了,在纯代码特效里算拿得出手,离电影级还有一段距离,整体观感与此前测试的 GPT 6.2 索尔差不多。
代码演奏与 SVG 小题:一次成型
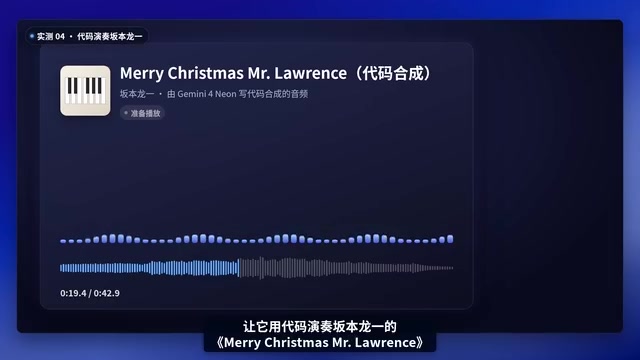
用代码演奏坂本龙一的《Merry Christmas Mr. Lawrence》,旋律和和声的味道是对的,就是电子合成音色一听便知。纯 SVG 画骑自行车的人,车架和鸟的比例一次就立住了;顺手加册一张中文海报,一句话一个世界,版面干净、重心也稳。茶壶倒茶的 Kamis 动画从倒水到水位上涨是完整的,壶嘴和水花还是偏平面。代码画蒙娜丽莎,坐姿和构图认得出来,脸上的笔触就比较糙了。
Blender 3D 角色建模:顶级模型集体卡壳
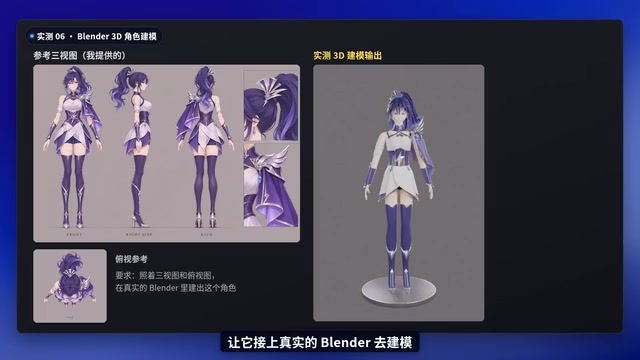
最难的一道题是 Blender 3D 角色建模。给了一套角色三视图和俯视图,让它接上真实的 Blender 去建模,出来的脸偏平、手也很僵。平坐标去捏人脸和手指,现在的大模型还是做不好——这道题测过的几个顶级模型目前也都没做出来,Neon 不例外。
文中的「思考深度分四档」对应的是可配置的推理预算(reasoning budget)机制:模型在给出最终答案前会先生成一段内部思考链,档位越高,允许的思考 Token 越多、越适合复杂推理,但延迟也随之上升。档位可调的意义在于把「快」和「深」拆成两个独立旋钮——日常改代码用低档换取响应速度,遇到架构设计或疑难 bug 再切高档。这也是文中说它「不会动不动卡进超长思考」的技术根源:节奏由调用方控制,而非模型自行决定是否长时间思考。
不是平替,是另一种取舍
八个场景测完,开头的问题有了答案:与其说 Gemini 4 Neon 是 Opus 5.5 的平替,不如说它更像 Kimi K3 的高速版。输入输出同样是 3 美元和 15 美元,但推理快得多,不会动不动卡进超长思考里,世界知识也更全,加上谷歌订阅给的额度很宽裕。它适合把节奏放在第一位的日常开发,而不是所有场景都追求极致的硬核代码指标。
接下来更值得观察的是长期主力开发中的稳定性——纸面第三和实际主力之间,往往差的就是那几周的连续使用体验。你现在的日常写代码主力是哪个模型?觉得 Neon 能接住你的需求吗?
相关推荐
Gemini 4 Neon 社区实践:9个案例解析场景游戏与3D动效
B站社区整理的Gemini 4 Neon实践合集,通过9个场景生成、游戏原型与3D动效案例,展示模型在实际创作流程中的落地方式与模型PK对比思路。

Gemini 4 Neon对比Carbon实测:性能与费用差多少
谷歌Gemini 4 Neon与Carbon实测对比:Neon默认档59.6分追平旗舰,速度翻倍、原价便宜四分之一,但Carbon在科研计算领先8.5个百分点。11月底前Carbon五折更划算,12月起Neon价格优势生效。

Gemini 4 Neon实测:数据可视化亮眼,但难敌Opus
B站UP主实测Gemini 4 Neon:Agent Arena排名第三,动态数据可视化优于Astra,但3D场景与复杂任务协调能力明显落后Opus和Fable,性价比也面临同门Soul的挤压。