实测GPT-5.6三模型Sol/Terra/Luna:编程能力几何?

GPT-5.6发布:Sol、Terra、Luna三模型全面解析
OpenAI此次一口气推出三个新模型,命名颇具宇宙意象——Sol(太阳)、Terra(地球)、Luna(月球),分层逻辑清晰直观。三者定位对应如下:
- GPT-5.6 Sol:旗舰高性能模型,综合能力最强
- GPT-5.6 Terra:中端定位,兼顾性能与成本
- GPT-5.6 Luna:轻量级低配版,适合轻量任务
这套天体命名法背后,是AI行业产品线分级策略成熟化的体现。从行业背景来看,Anthropic早在Claude 3系列便以Haiku(俳句)、Sonnet(十四行诗)、Opus(作品)三档确立了"轻量-均衡-旗舰"的三层架构,Google Gemini同样以Nano、Pro、Ultra形成梯队。这套分层逻辑的核心驱动力是推理成本(inference cost)的差异化管理。
推理成本与架构背景:推理成本是指大语言模型每次生成响应时所需的计算资源开销,主要由模型参数量、激活的专家数量以及生成token数共同决定。当前主流旗舰模型普遍采用混合专家架构(Mixture of Experts, MoE)——将模型的前馈神经网络层替换为多个并行的"专家"子网络,每次前向传播时由轻量级"路由器"动态选择激活其中的2-4个专家,而非全部参数。这使得模型总参数量可以极大(据报道GPT-4超过1万亿参数),但每次推理实际激活的参数量仅为总量的一小部分,在不损失模型容量的前提下显著降低计算成本。旗舰模型每次API调用的算力成本仍可达轻量模型的10-50倍,因此业界还普遍采用**知识蒸馏(Knowledge Distillation)**技术——由Geoffrey Hinton团队于2015年正式提出,其核心是让小模型(Student)学习大模型(Teacher)输出的软标签(每个类别的概率分布),而非简单的硬性标注。在LLM场景下,蒸馏通常包括响应蒸馏、特征蒸馏和黑盒蒸馏三种路线,GPT-4o mini、Claude Haiku等轻量模型均大量采用此技术,在参数量缩减80%以上的情况下仍能保留旗舰模型60-70%的综合能力。对企业用户而言,按任务复杂度选择合适档位的模型,可大幅降低API调用费用;对C端用户,轻量模型则意味着更快的响应速度。
这套命名与产品分层方式,让不少用户第一时间联想到Anthropic的Claude系列。测评者直言:"有对Claude拙劣模仿之嫌。"除了模型本身,本次更新还做了一项重要整合:将ChatGPT与Codex合并,并在网页端、手机App及桌面版统一上线了"Work模式"。
Work模式:云端Codex的回归
熟悉OpenAI产品线的用户或许还记得,网页端曾有一个支持云端执行任务的Codex功能,后来悄然下线。要理解Work模式的来龙去脉,需要回溯Codex的历史:它最初于2021年作为独立API产品发布,是当时业界首个专为代码生成优化的大语言模型,GitHub Copilot的底层引擎即基于早期Codex版本。
Codex技术路线与GitHub Copilot的渊源:Codex的核心技术是在GPT-3基础上,使用约1540亿token的公开代码库数据(主要来自GitHub,涵盖54种编程语言)进行微调(fine-tuning)。相比通用语言模型,Codex在函数级代码补全任务(HumanEval基准测试)上的pass@1准确率高达28.8%,而同期GPT-3仅为0%。这一代差验证了领域专项微调的有效性。值得关注的是,GitHub Copilot于2021年6月公测时,其底层引擎正是早期Codex版本——GitHub(Microsoft旗下)与OpenAI之间的这次合作,开创了"基础模型+垂直产品+云计算基础设施"的商业化范式:OpenAI提供模型能力,GitHub提供海量代码训练语料与分发渠道,Azure担任算力底座。2023年3月Codex API下线后,Copilot底层逐步迁移至GPT-4系列,这一轨迹也折射出AI代码助手从"专项微调小模型"向"通用旗舰模型"转移的整体趋势。Code Interpreter(现称Advanced Data Analysis)则在Codex能力基础上更进一步,为模型配备了Python沙箱执行环境,允许模型不仅生成代码,还能运行代码并将执行结果作为新的上下文继续推理——这种"闭环验证"机制显著减少了幻觉式代码错误。
此次Work模式的回归,本质上是将代码执行能力(Code Interpreter)与云端运行环境(Sandbox)深度整合——模型不仅能写代码,还能在OpenAI托管的服务器上实时运行、调试并部署。这种"生成即部署"的闭环,对没有运维能力的个人开发者是显著的门槛降低。此次Work模式被普遍视为将其"缝缝补补"后重新上架。官方声称部分能力已超越前代"Fable 5"(即GPT-5.5),实际表现是否名副其实,还需用数据说话。
编程实测:亮点与短板并存
测评者以Codex为核心工具,进行了从小游戏到网页开发的多场景实战测试。
亮点一:一键部署让发布更简单
本次更新中最值得关注的实用新功能是:付费用户可直接使用OpenAI服务器托管部署Web项目。AI写完网页项目后,可直接部署并返回访问链接。默认为私有部署(需登录账号查看),也支持公开部署或绑定自定义子域名。
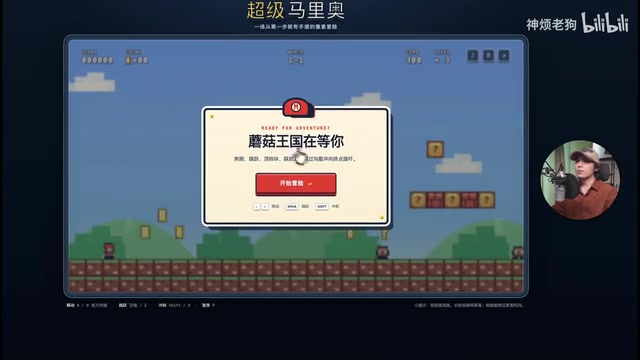
在经典的马里奥小游戏测试中,新模型不仅顺利实现了功能,UI设计相比上一代也有明显提升,游戏可正常运行、角色可以变大,整体体验流畅。
亮点二:交互项目设计可圈可点
在制作"可交互相机(橡皮泥效果)"时,模型表现相当亮眼。页面设计精致,支持标记识别开关、变形力度与影响范围调节,还能在触摸和鼠标操作间无缝切换。拟态设计的旋钮与光影细节获得测评者较高评价,认为"相比上一代确实强太多"。
硬伤:纯审美设计仍是瓶颈
然而一旦涉及纯审美向设计,问题便暴露出来。制作"GPT-5.6介绍视频"时,卡片悬浮抖动、无缝放大等动效颇为丝滑,但整体视觉风格被吐槽"像小时候的寒假作业——做完了,但观赏性存疑"。
在不借助审美增强插件、仅凭模型自身能力制作介绍网站时,成品虽比GPT-5.5好看不少,但仍存在难以忽视的细节瑕疵。
游戏开发实测:封面与实机的巨大落差
游戏开发测试是整个评测中最戏剧性的环节,暴露出明显的"买家秀与卖家秀"差距。
3D射击游戏:封面惊艳,实机翻车
模型为3D射击游戏生成的封面"非常不错",但实机体验令人失望:换枪、飞行、锁定等功能虽一应俱全,却操控极其难受,"完全看不到子弹",被直接评价为"完全狗屎"。横板赛车游戏同样如此——封面精美,但物理引擎(空翻效果)表现糟糕。
这种"封面惊艳、实机翻车"的现象,揭示了当前LLM生成游戏的核心技术局限。AI生成封面图依赖图像生成模型(如DALL-E系列),在静态美术资产上已高度成熟;但实机游戏需要运行在浏览器WebGL或Three.js等实时渲染框架上,涉及复杂的时序逻辑。
WebGL与游戏引擎的技术挑战:WebGL(Web Graphics Library)于2011年由Khronos Group标准化,是OpenGL ES 2.0的JavaScript绑定版本,允许网页直接调用设备GPU执行着色器程序(Shader)完成3D渲染,无需任何插件。Three.js则将WebGL封装成声明式的场景图(Scene Graph)API,是目前浏览器端3D游戏与可视化的最主流框架,npm周下载量超过200万次。然而,即便有Three.js加持,LLM生成完整3D游戏代码仍面临结构性挑战:游戏引擎需要维护精确的"游戏循环"(Game Loop,通常基于requestAnimationFrame实现),在每一帧约16ms内完成物理计算、碰撞检测、渲染调用等多个子系统的时序协调。物理引擎的刚体动力学模拟(如Cannon.js)对参数极其敏感,质量、摩擦系数的细微偏差都会导致物体行为异常。射线检测(Raycasting)用于判断子弹是否击中目标,需要在世界坐标系、相机坐标系和屏幕坐标系之间做精确变换——LLM在处理这类多坐标系转换问题时容易产生系统性错误,表现为子弹"打不中"目标的视觉现象。这些bug在静态预览时不可见,只有真正运行才会暴露。
CS类游戏:意外的高完成度
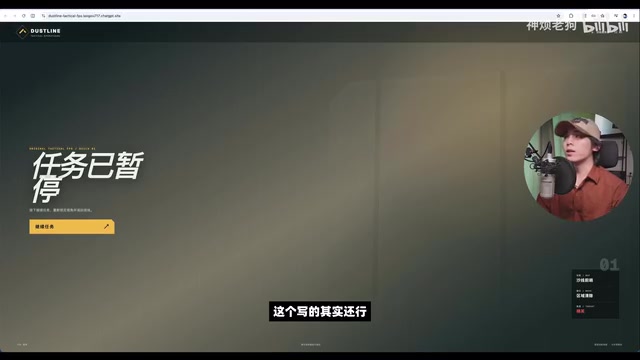
相比之下,"在新闻剑甲中制作高还原CS游戏"的表现反而更令人满意。三把武器切换、子弹弹痕、拆炸弹任务等核心玩法均较为完整,测评者认为"写得其实还行"。这一结果并非偶然:CS类游戏的核心机制(开枪、碰撞、计分)可以用相对简单的二维逻辑实现,远比3D物理模拟的边界条件少,LLM的代码生成胜率因此更高。此外,Blender实景合成建模测试历时一小时以上完成,AI自配音效,整体"还带点幽默感"。
Work模式制作PPT:效率重灾区
Work模式主打办公场景,测评者以科普PPT制作为例进行测试,结果近乎灾难:
- 耗时惊人:处理长达24分钟仍未完成,最终"力竭"收场
- 额度暴涨:单次任务消耗约30%的周度额度
- 速度奇慢:即便开启1.5倍速播放,进度依然迟缓
这一现象的根本原因,在于Work模式采用了智能体(Agent)式任务执行架构。与普通对话模式不同,Work模式基于ReAct(Reasoning + Acting)或类似框架运作:模型在完成任务时会反复循环"思考→调用工具→观察结果→再思考"的过程。
Agent架构、上下文窗口与注意力机制的技术瓶颈:ReAct框架由Yao等人于2022年在普林斯顿与谷歌联合发表的论文中提出,其核心创新是将思维链推理(Chain-of-Thought)与工具调用交织进行——模型在每次工具调用前先生成显式的"思考"步骤,观察工具返回结果后再进行下一轮推理,形成"思考→行动→观察"的循环。OpenAI的Work模式、Anthropic的Claude Computer Use以及Google的Project Mariner均是此类架构的产品化落地。该架构的根本瓶颈在于上下文累积:制作一份20页PPT,模型可能需要搜索资料(3-5次)、生成大纲(1次)、逐页创作内容(20次)、代码调试(5-10次),每次调用都将前序所有内容保留在上下文窗口中,最终总长度可能突破100K token。从底层来看,Transformer标准自注意力机制的计算复杂度为O(n²·d),当上下文从32K扩展至128K token时,注意力计算量理论上增长约16倍。尽管FlashAttention等算法通过IO感知的分块计算将内存访问复杂度从O(n²)降至O(n),但工程层面的质量下降问题仍存在——研究发现LLM对上下文中间部分的关注度远低于开头和结尾("Lost in the Middle"现象),导致早期设定的格式要求容易被后来的工具输出稀释,输出质量随任务进行持续下降。此外,工具调用的延迟叠加(每次HTTP请求需100-500ms)以及早期错误被后续推理当作真实前提持续放大,也使得长任务的错误传播风险显著高于单轮对话。这一现象在业界被称为"上下文窗口污染"(Context Window Pollution)。
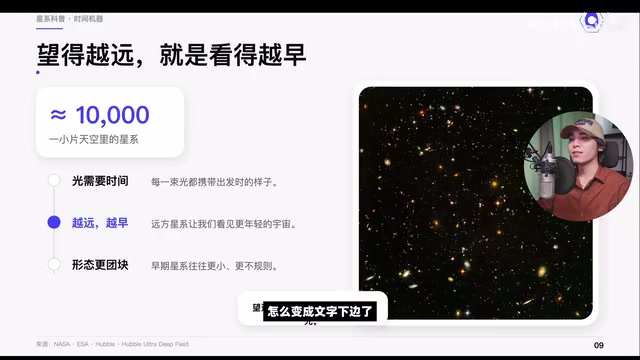
模型"习惯性发散"、频繁调用大量工具导致token消耗极高,成品还存在明显bug,例如项目符号的蓝点跑到了文字下方。测评者的明确建议是:不推荐使用该模式制作PPT;若非要用,选最低配的Luna模型即可——轻量模型推理速度更快,单次调用成本更低,在多工具调用场景下总成本反而可能更可控。
额度消耗与真实使用体验
测评过程中,测评者重置了两次额度,全部消耗于上述案例。他估算,若不重置,每周额度仅剩约20%~30%。好消息是,模型发布初期官方已连续重置两三次额度,相对"量大管饱"。
真实用例:高中生的生物学习网页
视频末尾展示了一位网友用GPT制作的高中生物选修一第二章网页,涵盖神经调节反射弧动画、知识总图、判断题与选择题等完整内容。前端虽有些许崩坏,但"切实满足了学习需求"——这也印证了AI编程在教育场景中的实用价值。
总结:有进步,但未达预期
测评者的最终结论客观中肯:
"如果单看前端,它并没有超过GPT-5.5;但综合评估额度充足、模型更聪明等因素,确实可以与上一代抗衡。"
面对社区"前端已全面超越GPT-5.5"的高调宣传,以及团队成员在X平台预热一个多月拉高的期待值,实际体验只能说是"未达预期"。GPT-5.6在编程能力和交互设计上确有进步,一键部署也是值得称道的实用亮点;但审美短板、游戏物理效果差、办公场景高消耗低效率,依然是它需要直面的现实问题。感兴趣的用户,不妨亲自上手测试后再作判断。
相关推荐

AI Agent Skill 脚本开发:何时该写与绝不能写
AI Agent Skill 开发中,脚本什么时候该写、什么时候绝对不能写?本文梳理对接外部系统、固定运算、复用脚本等必写场景,以及意图识别、规则变动、高危操作等禁写场景,附一句话决策原则。

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。