实测Opus 5.5六档努力级别:花了500美元跑完18个应用

一位创作者用近500美元、近8亿token、20多小时,让Opus 5.5在low到UltraCode六个努力级别下分别构建3D工作室场景、象棋引擎和音乐制作工具三个应用,共18次构建。结果发现成本每级几乎翻倍,UltraCode三个应用合计超300美元,却在象棋引擎锦标赛中仅排第三,从未产出最佳结果;max以不败战绩夺冠。成本结构上,96%的token是廉价的缓存读取,仅占1%的输出token却贡献了42%的费用。自测次数从low的近乎为零飙升至最高档的77至125次,是耗时激增的主因。创作者建议:low用于原型验证,high作为日常默认,max用于逻辑密集型任务,UltraCode大多数场景不值得。
一场近500美元的暴力测试
AI编程工具到底该用哪个努力级别?这个问题困扰着大多数开发者。一位YouTube创作者做了一件很多人想过但没做过的事:让Opus 5.5在六个不同的努力级别下分别构建三个完全不同的应用,总共跑完18次构建。
这次实验的灵感来自Nate Hurk的类似测试,但这位创作者想验证一个更根本的问题——应用的种类是否会影响努力级别的最佳选择。毕竟,一个3D场景、一个国际象棋引擎和一个音乐制作工具,面对的是完全不同类型的问题。
整个实验消耗了近500美元的token额度、近8亿token,耗时超过20小时。每次运行都使用全新会话、相同的prompt、不允许追问修正,而且刻意不告诉模型去测试自己的代码——是否自测本身就是被测量的指标之一。
三个应用,三种挑战
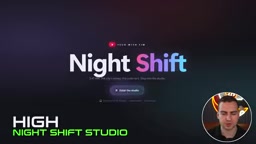
Night Shift:3D工作室场景
第一个应用是对创作者YouTube工作室的交互式3D还原,核心考验的是视觉保真度和建模精细度。从low到UltraCode,画面质量确实在提升:low级别虽然简陋但功能完整;medium增加了入场动画,但出现了奇怪的黑色遮挡;high级别开始有了进入工作室的过渡效果,灯光和细节明显改善;extra和max在视觉上趋于接近,但max反而在某些交互上不如extra——比如招牌切换功能失效了。
到了UltraCode,几乎每个物品都可以交互——播放按钮能被拨动、麦克风会晃动、屏幕上甚至显示着滚动的代码。但创作者本人的评价很直接:在night shift这个项目上,他反而更喜欢extra的效果。
Checkmate:从零手写象棋引擎
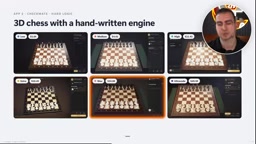
第二个应用要求Opus从零实现完整的国际象棋规则并编写AI引擎,不允许使用任何象棋库。所有级别都成功完成了任务,但真正的考验在后续的锦标赛中。
创作者自己是1700-1800分的棋手,却无法击败任何一个级别的AI。但更令人意外的是锦标赛结果:max以8胜2平不败战绩夺冠,extra以8分获得第二,而花费最高的UltraCode只排第三——两个在3小时上限时仍在调优引擎的版本,反而做出了最强的棋力。
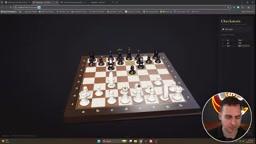
low级别甚至在排名中击败了medium,这说明努力级别和逻辑能力之间并非线性关系。
为什么"自测"会成为关键变量
高努力级别耗时暴增,主因不是生成代码变慢,而是模型被允许反复执行"生成—检验—修正"的循环。在象棋引擎这类任务里,模型可以自己编译代码、运行对局、统计胜负,并据此调整搜索深度、评估函数权重等参数。这意味着努力级别实际购买的是迭代调优的次数,而非单纯的代码量。
这也解释了实验中一个反直觉的现象:UltraCode 在 3 小时上限时仍在调优引擎,最终棋力反而不如更早收敛的 max 和 extra。调优存在边际收益递减,且更长的搜索链未必导向更优的策略——在有限时间预算下,提前定型的版本反而可能因为完成度更高而胜出。因此,自测次数多寡只能说明"投入了多少检查",并不等同于"结果一定更好"。
Beat Lab:单文件音乐工作室
第三个应用是一个完整的音乐制作工具,包含钢琴卷帘、混音器和可视化器,所有音效必须通过代码生成,不能引用外部音频文件。所有级别都成功实现了代码生成音效这一核心要求。
在Beat Lab上出现了一个有趣的反转:UltraCode虽然更贵,但运行速度反而比max和extra快得多。原因是它启动了10个不同的子代理并行处理——这是在其他两个应用中没有观察到的行为。
什么是"努力级别"(Effort Level)
在部分前沿模型的 API 与产品界面中,"努力级别"并非指模型参数量的变化,而是对模型推理预算的调节旋钮。它通常通过两个维度体现:一是允许模型在给出最终答案前进行多长时间的"思考"(即扩展推理链的长度),二是允许模型发起多少次自我验证、工具调用或子代理并行任务。级别从 low 到最高档,成本与耗时呈近似指数上升,但能力提升并非同比例——这正是本次实验要验证的核心。
需要区分几个容易混淆的概念:努力级别调节的是"花多少算力去解决同一个问题",而模型版本决定的是"用什么能力去解决";上下文缓存(cache read)则是一项降低成本的技术,它把会话中重复出现的提示词与前文缓存复用,因此单价极低。本实验中 96% 的 token 属于缓存读取,但真正决定账单的却是占比仅 1% 的输出 token。
成本曲线:每级几乎翻倍
三款应用的费用数据呈现出清晰的规律。low全部三个应用加起来不到4美元;medium约14美元;high约27美元;extra约50美元;max约82美元;UltraCode则直接跳到超过300美元。
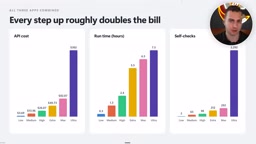
创作者还拆解了token的流向:96%的token是缓存读取——因为每次会话中模型都要重新读取之前的所有上下文。但这部分极其便宜,每百万token仅约20美分。真正烧钱的是输出token,虽然只占总量的1%,但每百万token收费20美元,最终占了总成本的约42%。
自测次数的变化同样显著:low级别几乎为零,到max和UltraCode级别时攀升至77到125次。这正是高努力级别耗时暴增的主要原因——不是模型写得更慢,而是它花了大量时间反复检查自己的输出。
缓存读取与输出 token 的成本结构
大模型的推理成本由输入、输出与缓存命中三部分构成。本实验揭示的 96% / 1% / 42% 这组数据,本质上是三档单价差异造成的:缓存读取通常每百万 token 仅约 0.2 美元,而输出 token 可达每百万 20 美元,相差约百倍。因此即便输出只占 token 总量的极小部分,也会吞掉近一半账单。
这带来一条实用的优化原则:控制输出长度比控制输入长度更省钱。在实际使用中,减少冗长的解释性文字、要求模型直接返回代码或结构化结果,往往比精简提示词更能压低成本。反之,把大段参考材料放进上下文一旦被缓存,其边际成本极低,是可以放心使用的。理解这套计价结构,有助于开发者判断"加钱提升努力级别"是否真的划算。
努力级别到底怎么选
根据这次实验的完整数据,创作者给出了自己的建议:
low用于验证想法。 能在几分钟内生成完整3D场景,费用不到1美元。对于快速原型验证,性价比无可匹敌。
high作为日常默认。 通常一小时内完成,每个应用7到11美元,会进行自测,质量足以覆盖大多数需求。
max用于逻辑密集型任务。 象棋引擎这类需要正确性保证的场景,max的自测频率和调优深度能带来实际差异。
UltraCode大多数情况下不值得。 费用是max的2到6倍,耗时显著更长,在多次测试中甚至超时。就这三个应用而言,UltraCode从未产出最佳结果。创作者建议只将它留给真正大型的多模块项目。
一个值得注意的结论是:努力级别对逻辑型任务的影响远大于视觉型任务。象棋引擎的棋力排名几乎与努力级别正相关,但视觉效果在extra之后就开始趋于平缓——花更多的钱并没有让画面变得更好。
这意味着选择努力级别时,应该根据任务的性质来判断:视觉类项目用high可能就够了,而涉及复杂逻辑的项目才值得往上加码。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。