世界模型公司为何守口如瓶:资本狂热下的信息黑箱
世界模型初创公司坐拥巨额融资却普遍对技术细节守口如瓶,折射出资本热潮下的透明度危机。
世界模型作为AI领域的新兴热点,旨在让AI系统建立对物理世界运行规律的内部理解,被视为通向通用人工智能的重要路径。然而,尽管相关初创公司获得了可观融资并享有极高市场关注度,这些公司从创始人到数据供应商却几乎一致保持沉默,拒绝披露实质性技术细节。这种保密态度背后存在多重动机:技术路线属于核心竞争壁垒、高估值下的期望管理需要、以及训练数据来源可能存在版权或合规敏感性。文章指出,这种"高投入、低透明"的组合使外界难以判断世界模型技术的真实成熟度与泡沫成分,并提醒理性观察者将透明度的缺失本身视为重要信号加以解读。
世界模型公司为何守口如瓶:资本狂热下的信息黑箱
世界模型(World Models)正成为AI领域最炙手可热的新赛道之一。这些公司手握大量资金和巨大关注度,但从创始人到他们的数据供应商,几乎没有人愿意透露他们究竟在构建什么。这种普遍的沉默本身,就折射出这个新兴领域的诸多耐人寻味之处。
什么是世界模型
世界模型是一类试图让AI系统在内部建立对物理世界运行规律理解的技术方向。与传统只处理文本或图像的模型不同,世界模型的目标是让AI能够预测环境的动态变化、模拟未来状态,从而支撑更复杂的推理、规划乃至具身智能应用。
这一概念被视为通向更通用人工智能的重要路径之一,也正因如此,它吸引了大量资本涌入。围绕世界模型的初创公司在近期获得了可观的融资,行业热度居高不下。
世界模型的概念最早可追溯至1990年代认知科学和强化学习领域的研究,核心思想是让智能体在与环境交互之前,先在内部"想象"可能发生的事情。近年来,这一概念因Yann LeCun(Meta首席AI科学家)的系统性倡导而重新进入主流视野——他在2022年的论文《A Path Towards Autonomous Machine Intelligence》中提出,世界模型是实现类人智能不可绕过的关键组件。
在技术实现上,世界模型通常需要整合视频、传感器、物理仿真等多模态数据,学习物体运动、因果关系和空间拓扑等规律,使模型能够在不执行真实动作的情况下完成"心理演练"。这与当前主流的大语言模型(LLM)有本质区别:LLM本质上是统计语言模式的压缩,而世界模型追求的是可泛化的物理直觉。正因技术难度极高、路径尚不明朗,各家公司的技术选择差异显著,也使得这一赛道更加难以从外部进行横向比较。
资本与噪音的双重堆叠
据原文描述,世界模型领域的从业者们"坐在一堆现金和大量话题热度之上"。这句话精准概括了当前的市场状态:资金充裕、关注度爆棚,但实质性的产品披露却极为稀少。
这种"高投入、低透明"的组合在新兴技术赛道中并不罕见。当一个概念被资本追捧时,估值往往先于成熟的产品而膨胀。投资者押注的更多是愿景和团队,而非可验证的技术成果。世界模型的宏大叙事——让AI真正理解世界——恰好为这种想象力提供了充足的燃料。
为何集体保持沉默
原文指出一个关键现象:无论是想采访创始人,还是接触他们的数据供应商,外界都很难获得关于这些公司真实进展的信息。这种守口如瓶的态度背后可能有多重原因。
技术竞争的敏感性是最直接的解释。世界模型仍处于早期探索阶段,任何技术路线的细节、训练数据的来源和处理方式,都可能构成竞争壁垒。在一个赢家可能通吃的赛道上,过早暴露方法论无异于为竞争对手指路。
期望管理的考量也不容忽视。当一家公司背负着高估值和高期待时,公开的每一个细节都会被放大审视。如果实际进展与外界想象存在落差,透明反而可能损害其融资叙事。因此保持神秘,某种程度上是维护估值的策略。
数据供应链的隐秘同样值得关注。原文特别提到连数据供应商都不愿透露信息,这暗示世界模型的训练可能高度依赖特定的、甚至存在合规争议的数据来源。数据的获取方式往往是这类公司最不愿公开的部分。
信息黑箱背后的行业隐忧
这种普遍的信息不透明,对整个行业而言是一把双刃剑。一方面,它保护了初创公司的技术机密和竞争地位;另一方面,它也让外界难以判断这些公司的技术究竟成熟到何种程度,泡沫成分有多大。
对于投资者、潜在客户乃至整个AI社区来说,缺乏可验证的信息意味着风险评估变得困难。当一个领域的热度远超其可公开的成果时,市场往往需要警惕估值与实质脱节的可能。
世界模型能否兑现其"让AI理解世界"的承诺,最终仍需要经得起检验的产品和成果来证明。在那一天到来之前,这些公司选择的沉默,既是策略,也是一种无声的信号。
结语
世界模型代表了AI发展的一个雄心勃勃的方向,其潜力值得期待。但当整个赛道都笼罩在保密的迷雾中时,理性的观察者更应保持审慎。资本的热情和市场的话题度固然重要,真正决定成败的,终究是那些尚未公开的技术能否落地。对于关注这一领域的人来说,透明度的缺失本身,就是当下最需要读懂的信息。
背景补充
世界模型对训练数据的要求与文本大模型有根本性差异。训练一个能理解物理世界的模型,需要海量带时间维度的视频数据、机器人交互数据乃至游戏引擎生成的合成数据。这些数据的版权归属和使用授权远比文本数据复杂——视频平台、影视公司、工业传感器的数据所有方都可能卷入授权争议。
目前已有多起针对AI公司使用未授权训练数据的诉讼,这使得数据来源成为整个行业的法律敏感地带。对于世界模型公司而言,若其训练数据来源于网络爬取的视频或未经明确授权的专有数据集,公开披露数据供应链不仅会暴露商业机密,更可能直接触发监管审查或诉讼风险。这或许正是数据供应商同样选择沉默的深层原因。
相关推荐
埃森哲成Anthropic首位嵌入式评估合作方,意味着什么?
Anthropic据称将由咨询巨头埃森哲担任首个「嵌入式评估者」,这被称为埃森哲史上风险最高的咨询业务。本文解读这一合作背后AI厂商与咨询公司的角色重构趋势。
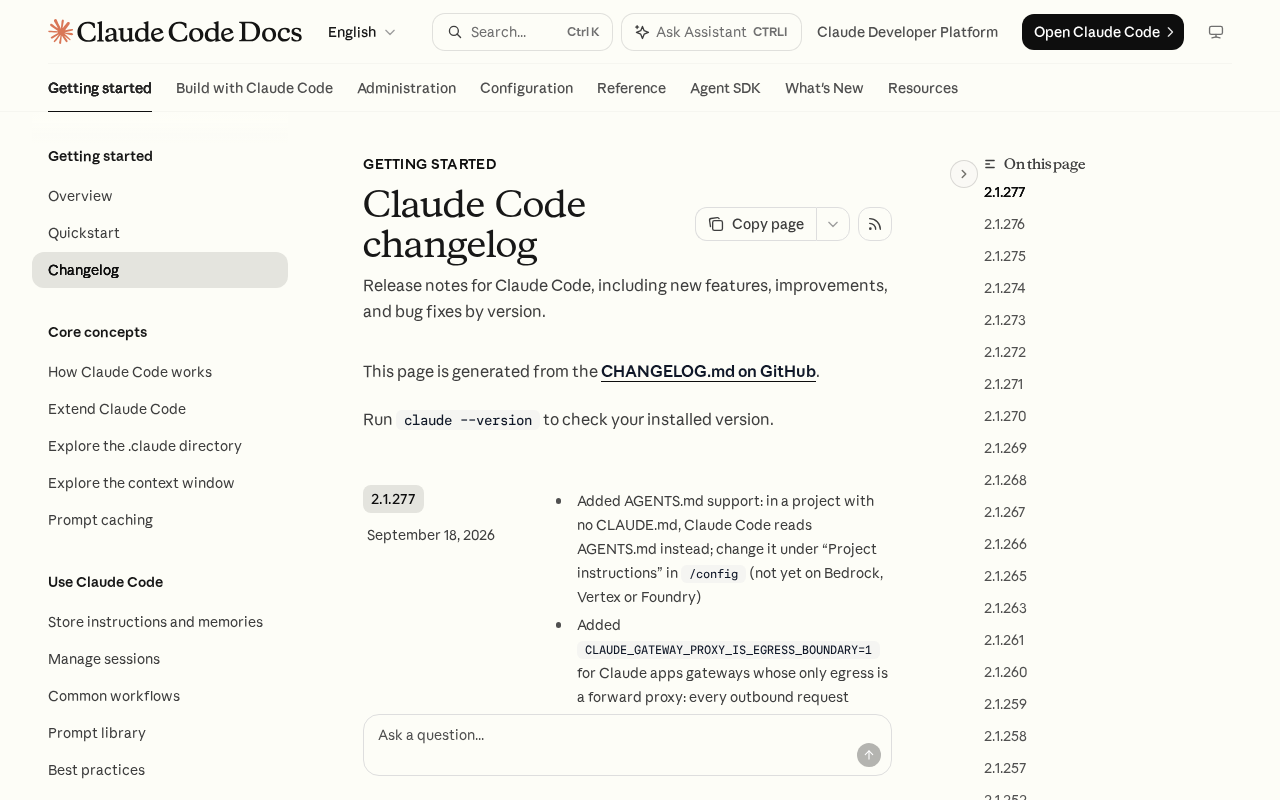
Claude Code 支持读取 AGENTS.md:AI 编程配置走向标准化
Claude Code 现已支持在缺少 CLAUDE.md 时读取 AGENTS.md 配置文件,标志着 AI 编程工具配置走向标准化。本文解析这一改动的意义、生态博弈及对开发者的实际影响。
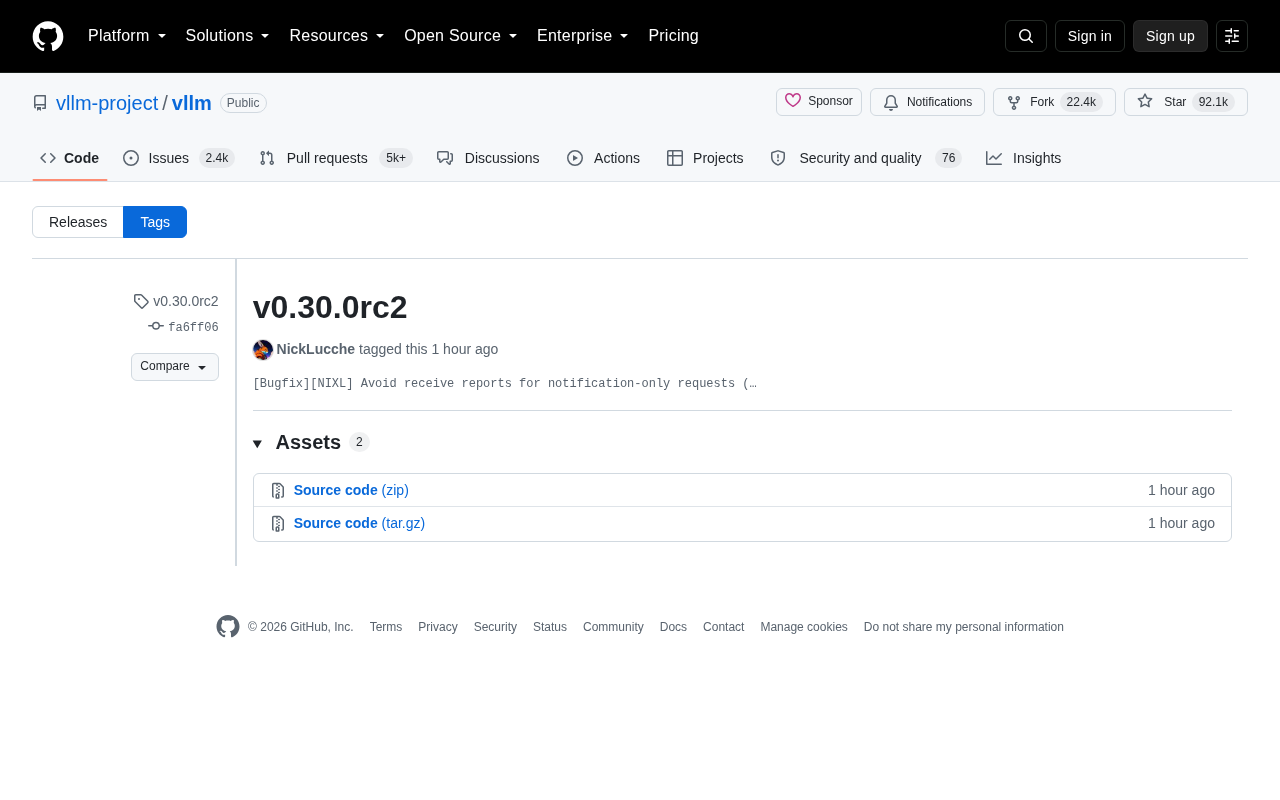
vLLM v0.30.0rc2 发布:修复NIXL通知请求处理问题
vLLM 发布 v0.30.0rc2 候选版本,核心修复 NIXL 传输层对通知类请求的处理逻辑,避免冗余接收报告。本文解读该更新内容、NIXL 作用及对分离式推理部署的影响。