vLLM v0.30.0rc2 发布:修复NIXL通知请求处理问题
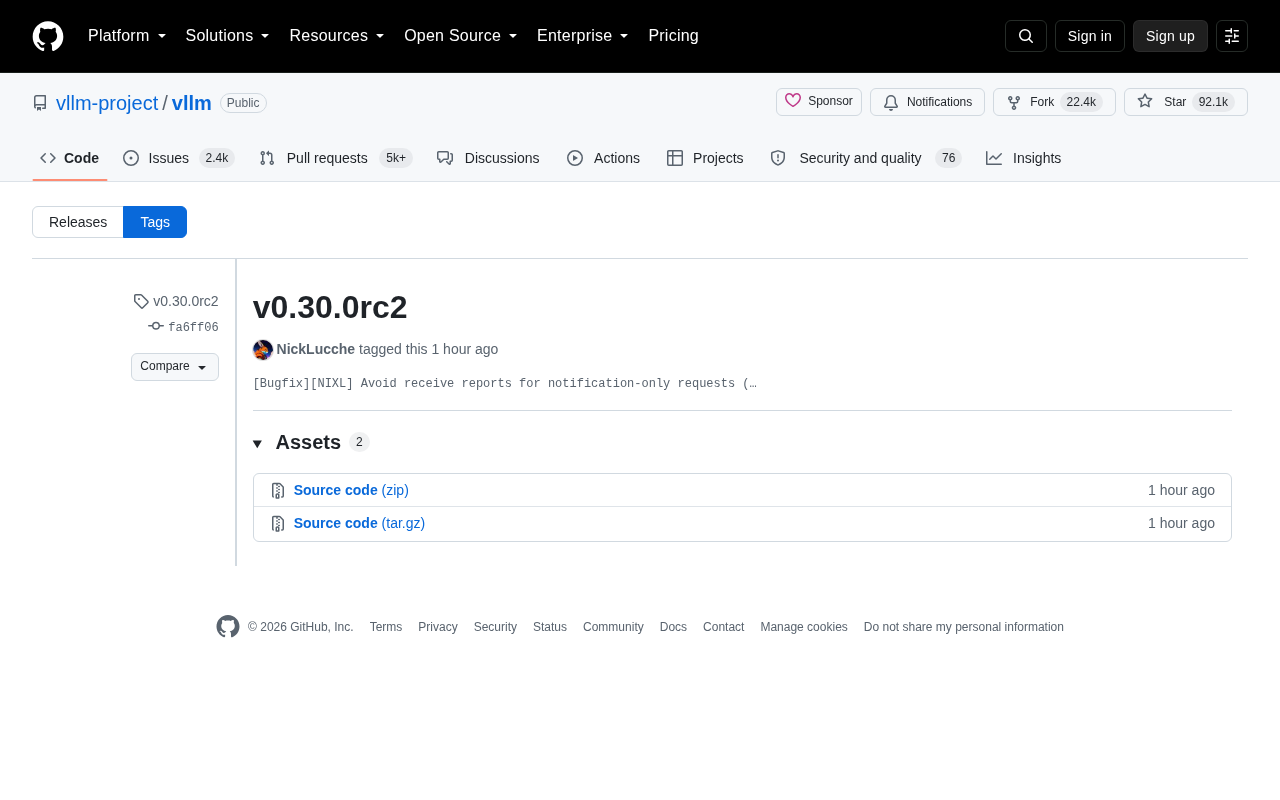
vLLM v0.30.0rc2 修复NIXL传输层对纯通知类请求的冗余接收报告问题,提升分布式推理稳定性。
vLLM 发布 v0.30.0rc2 候选版本,核心改动为修复 NIXL(NVIDIA Inference Xfer Library)传输层中的一个 Bug:在分布式推理场景下,仅用于传递信号、不涉及实际数据接收的「通知类请求」会被错误地触发完整的接收报告流程,造成资源浪费乃至潜在逻辑错误。此次修复通过跳过这些冗余报告环节,令通信路径更加精简。NIXL 主要服务于 Prefill/Decode 分离架构下的 KV cache 跨节点传输,此类底层通信优化在大规模推理集群中对吞吐量与稳定性有实际影响。作为第二个候选版本,rc2 适合在测试环境中提前验证,生产用户建议等待正式版。
vLLM v0.30.0rc2 发布:修复NIXL通知请求处理问题
vLLM 项目近日发布了 v0.30.0rc2 版本。作为业界广泛使用的大语言模型推理与服务引擎,vLLM 的每一次版本更新都受到 AI 工程社区的密切关注。此次为 0.30.0 正式版前的候选版本(Release Candidate),主要包含一项针对 NIXL 传输层的错误修复。
本次更新的核心内容
根据 GitHub 发布记录,v0.30.0rc2 由维护者 NickLucche 标记发布,对应的提交哈希为 fa6ff06。此版本的关键改动是一项 Bugfix:
[Bugfix][NIXL] Avoid receive reports for notification-only requests
简单来说,该修复针对 NIXL 传输组件中「仅用于通知的请求」进行了优化,避免这类请求触发不必要的接收报告(receive reports)。在分布式推理或 KV 缓存传输场景下,减少冗余的报告处理有助于降低通信开销、提升系统稳定性。
什么是 NIXL
NIXL(NVIDIA Inference Xfer Library)是用于加速推理数据传输的库,在 vLLM 中常被用于实现 Prefill/Decode 分离(disaggregated serving)架构下的 KV cache 跨节点传输。当推理任务被拆分到不同 GPU 或节点上执行时,NIXL 负责在这些计算单元之间高效地搬运中间状态数据。
本次修复的「notification-only requests」指的是那些只需要传递信号、不涉及实际数据接收的请求。在早期实现中,此类请求可能仍会走完整的接收报告流程,造成资源浪费甚至潜在的逻辑错误。新版本通过跳过这些无意义的报告环节,让通信路径更加精简。
Prefill/Decode 分离架构(Disaggregated Serving)是大模型推理领域的一种先进部署模式。传统推理将预填充(Prefill)阶段——处理输入 prompt、生成 KV cache——和解码(Decode)阶段——逐 token 自回归生成——放在同一组 GPU 上串行执行,导致两类工作负载互相干扰,GPU 利用率难以最优化。分离架构将这两个阶段拆分到不同的 GPU 节点上:Prefill 节点完成计算后,需要将生成的 KV cache 传输给 Decode 节点继续推理。这一跨节点的数据搬运对带宽和延迟极为敏感,也正是 NIXL 这类专用传输库发挥作用的关键环节。NIXL 底层通常利用 NVLink、InfiniBand 或 RDMA 等高速互联技术,绕过 CPU 直接在 GPU 显存之间传输数据,以最大程度降低 KV cache 迁移的延迟开销。
Release Candidate 意味着什么
rc2 中的「rc」表示 Release Candidate(发布候选版本),编号 2 说明这是 0.30.0 正式版之前的第二个候选版本。RC 版本通常已具备接近正式发布的功能完整度,主要用于在更广泛的环境中进行验证和收集反馈。
对于生产环境用户而言,RC 版本适合在测试环境中提前验证兼容性,但一般建议等待正式版发布后再上线关键业务。对于希望参与社区测试、或需要提前用到某项修复的开发者,RC 版本则是一个及时的选择。
对使用者的影响
vLLM 目前在 GitHub 上已获得超过 9 万星标,Fork 数超过 2.2 万,是最受欢迎的开源推理引擎之一。这类高频次的版本迭代和快速的 Bug 修复,正是其社区活跃度的体现。
如果你正在使用 NIXL 相关的分离式推理部署,建议关注此修复带来的行为变化,并在升级后验证 KV 传输链路是否正常。对于大多数标准部署场景,此次改动影响有限,可根据自身节奏选择是否升级到该候选版本。
KV cache(Key-Value Cache)是 Transformer 架构推理中的核心优化结构。在自回归解码过程中,每一步生成新 token 时,模型需要对所有历史 token 重新计算注意力机制中的 Key 和 Value 矩阵。KV cache 将这些已计算好的中间结果缓存起来,避免重复计算,从而大幅降低逐步生成的计算量。在分布式或分离式部署场景下,KV cache 的数据量往往相当可观(对于长上下文请求可达数 GB),因此其跨节点传输效率直接影响整个推理系统的吞吐量与端到端延迟。
小结
v0.30.0rc2 是一个聚焦稳定性的候选版本,核心是修复 NIXL 传输层对通知类请求的处理逻辑。虽然改动看似细微,但在大规模分布式推理场景中,这类底层通信优化往往对整体性能与可靠性有实际意义。感兴趣的开发者可前往 vLLM 官方 GitHub 仓库获取完整发布说明与安装包。
相关推荐
埃森哲成Anthropic首位嵌入式评估合作方,意味着什么?
Anthropic据称将由咨询巨头埃森哲担任首个「嵌入式评估者」,这被称为埃森哲史上风险最高的咨询业务。本文解读这一合作背后AI厂商与咨询公司的角色重构趋势。
Claude Code 支持读取 AGENTS.md:AI 编程配置走向标准化
Claude Code 现已支持在缺少 CLAUDE.md 时读取 AGENTS.md 配置文件,标志着 AI 编程工具配置走向标准化。本文解析这一改动的意义、生态博弈及对开发者的实际影响。
自托管日历软件怎么选?开源方案与需求要点解析
想要一款开源、自托管、支持 iCal 集成和安卓同步的日历软件?本文拆解自托管日历的核心需求、CalDAV 技术路线与选型权衡维度,帮你在开源方案中找到最适合的组合。