世界模型加持编码智能体:用百万级真实运行数据优化决策
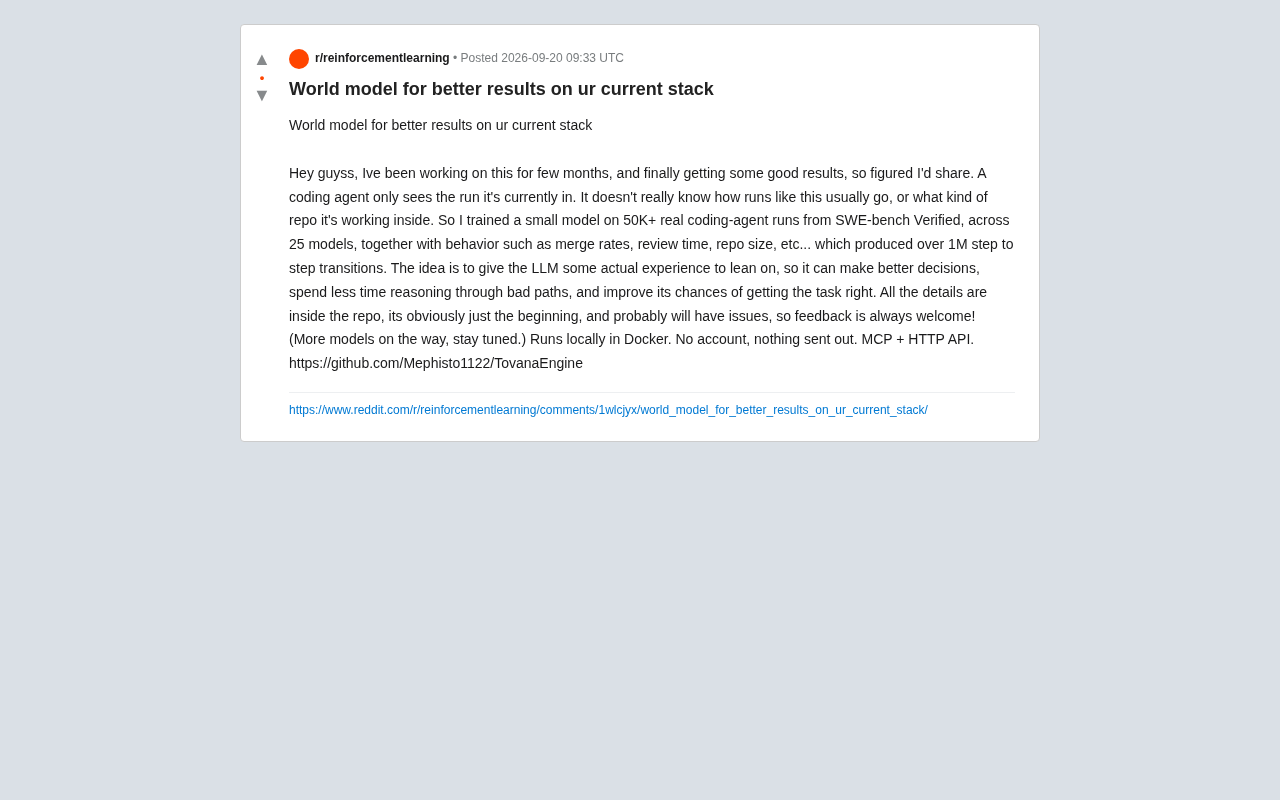
TovanaEngine用百万条历史运行数据训练轻量世界模型,为AI编码智能体补上「经验」短板。
当前AI编码智能体的核心盲区在于每次任务都「从零开始」,缺乏对历史模式的感知。TovanaEngine是一个开源项目,通过在SWE-bench Verified超5万次真实智能体运行记录上训练一个轻量世界模型,为LLM提供「事情通常如何发展」的先验知识,从而改善决策质量、减少无效推理、提升任务成功率。项目设计注重落地友好性:本地Docker运行、数据不外发,并同时支持MCP与HTTP API两种接入方式。作者坦承这仍是早期探索,基于基准数据训练的经验能否泛化到真实私有仓库、跨模型的行为规律是否存在「水土不服」等问题,仍有待社区实测验证。
编码智能体的核心盲区:只见当下,不知全局
当前的AI编码智能体存在一个被普遍忽视的局限——它只能看到自己正在执行的这一次运行(run)。它并不真正理解「这类任务通常是如何演进的」,也不清楚自己所处的代码仓库是什么类型、规模多大、以往类似操作的成功率如何。
换句话说,智能体每次都像是从零开始摸索,缺乏一种可供借鉴的「经验」。这导致它经常在错误的路径上反复推理,浪费算力和时间,最终任务成功率也受到拖累。一位Reddit开发者围绕这个问题做了数月探索,并开源了名为 TovanaEngine 的项目,尝试用「世界模型」(World Model)的思路来补上这块短板。
什么是这里说的「世界模型」
在这个语境下,世界模型并不是指那种预测视频帧、模拟物理环境的大型生成模型,而是一个专门针对「编码智能体行为」训练的小型模型。它的目标是给LLM提供一种关于「事情通常会怎么发展」的先验知识。
作者训练所依据的数据规模值得关注:基于 SWE-bench Verified 上超过 5万次真实的编码智能体运行记录,横跨 25个不同模型,并结合了合并率(merge rates)、代码审查时间(review time)、仓库规模(repo size)等行为指标,最终生成了 超过100万条step-to-step的状态转移数据。
这些逐步转移数据本质上刻画了「在某种状态下采取某个动作,接下来会发生什么」的规律。有了这套经验参照,LLM就能在决策时不再纯靠临场推理,而是借助历史模式来判断哪条路更可能成功。
SWE-bench Verified 是由 Princeton NLP 团队发布的一个基准测试集,专门用于评估 AI 系统解决真实 GitHub Issue 的能力。每个任务对应一个真实的开源仓库 Pull Request,智能体需要通过修改代码来让预设的测试用例通过。「Verified」版本是原始 SWE-bench 的子集,经过人工筛选以确保任务描述清晰、测试标准无歧义,测试结果更具可信度。这个基准目前已成为编码智能体领域最主流的能力衡量标准之一,GPT-4o、Claude 3.5 Sonnet 等主力模型均在此榜单上有公开成绩。用它积累的运行记录作为训练数据,意味着世界模型所学习的「经验」来自业界公认的、高质量的真实任务场景,而非人工构造的合成数据。
它想解决的三个实际问题
作者对这个模型的期待相当明确,可以归纳为三点:
- 更好的决策:让模型基于真实经验而非空想来选择行动路径;
- 减少无效推理:避免在明显糟糕的路径上耗费大量token和时间;
- 提升任务成功率:整体上增加一次性把任务做对的概率。
这三个目标其实指向了当前编码智能体最痛的成本与可靠性问题。推理型智能体往往因为反复试错而消耗惊人,如果能提前「预判」某些路径的收益与风险,理论上既能省钱又能提效。
工程实现:本地、私密、易集成
从落地角度看,TovanaEngine 的设计对开发者比较友好:
- 本地运行:通过 Docker 在本地跑,无需注册账号;
- 数据不外发:作者明确强调「nothing sent out」,对注重代码隐私的团队是加分项;
- 标准接口:同时提供 MCP(Model Context Protocol) 和 HTTP API 两种接入方式,意味着它可以较方便地嵌入现有的智能体工作流或编辑器插件中。
MCP 的支持尤其值得一提。随着这一协议逐渐成为智能体与外部工具/上下文交互的通用标准,围绕它构建的辅助模型更容易被生态接纳,而不必绑定某个特定的框架或厂商。
MCP(Model Context Protocol) 是由 Anthropic 于 2024 年底推出的开放协议,旨在标准化大语言模型与外部工具、数据源之间的交互方式。其设计理念类似于 USB-C 接口的「通用化」思路:开发者只需按照协议规范暴露一个 MCP Server,任何支持 MCP 的客户端(包括 Claude Desktop、Cursor、Cline 等主流 AI 编辑器)都能直接调用,无需为每个工具单独编写集成代码。随着越来越多的编辑器和智能体框架将 MCP 作为默认的工具调用标准,基于此协议构建的辅助组件天然具备跨平台复用的优势。TovanaEngine 选择支持 MCP,意味着它能以「即插即用」的方式嵌入现有开发工作流,而不是要求用户切换到特定的框架或重新搭建调用链路。
如何看待这个项目
需要清醒地认识到,这仍是一个非常早期的探索。作者本人也坦言「显然只是个开始,很可能存在各种问题」,并欢迎社区反馈,同时预告会陆续加入更多模型。
从思路上讲,这个方向切中了要害:现有的编码智能体大多把每次任务当作孤立事件处理,而真实的软件工程恰恰高度依赖「经验」和「上下文模式」。用一个轻量模型把海量历史运行的规律蒸馏出来,作为LLM的决策外挂,是一种成本相对可控的增强方案——相比重新训练或微调主力大模型,这种「旁路增强」更灵活也更易迭代。
当然,几个关键问题还有待验证:基于 SWE-bench Verified 训练出的经验能否泛化到风格迥异的真实私有仓库?跨25个模型汇总的行为规律,用在某个具体模型上是否会「水土不服」?以及在实际集成中,这个额外的模型调用带来的延迟与收益能否达到正比。这些都需要更多实测数据来回答。
对于正在搭建或优化自家编码智能体的开发者而言,这个开源项目至少提供了一个可以直接上手实验的起点。它不承诺立竿见影的效果,但把「让智能体拥有经验」这个命题,变成了一段可运行的代码。项目地址已在原文给出,感兴趣的团队不妨在本地Docker环境中试跑一番。
相关推荐

只想要一个自定义域名邮箱,为何如此艰难?
拥有一个自定义域名邮箱看似简单,实则涉及 SPF/DKIM/DMARC 配置、IP 信誉、托管服务成本等诸多难题。本文梳理自建与托管方案的权衡,并给出实用建议。

Claude意外帮用户发现燃气泄漏:AI助手的安全应用边界
一位Reddit用户借助AI助手Claude识别出家中燃气泄漏隐患,PG&E上门确认并修复。本文分析AI助手在家庭安全场景中的真实价值与使用边界,以及处理燃气泄漏的正确做法。

Gemini 4 Argon发布:谷歌重返前沿,但故事没那么简单
谷歌时隔半年发布前沿模型Gemini 4 Argon,跑分重返一线却暂不开放。本文解析其基准表现、与Sonnet 5.5的竞争,以及模型能力与产品体验之争。