什么是AI Agent?一个"替人上课"的例子讲透智能体本质
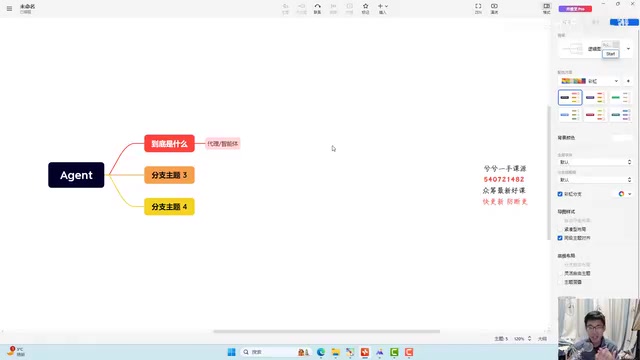
AI Agent的本质是用规则驱动大模型反复调用,而非自主智能的神秘新物种。
本文以"让室友替自己上课"为比喻,清晰拆解了AI Agent的核心逻辑:Agent并非脱离大模型的独立智能体,而是将一个复杂需求拆分为多个子任务,在每一步都调用大模型做决策的执行框架。文章最有价值的观点在于对Agent热潮的冷静纠偏——当前Agent的稳定性主要依赖人为设计的规则(即精心编写的提示),而非模型真正的自主思维能力。大模型存在幻觉、输出不稳定,因此不能神化其自主性。对入门者而言,理解Agent的关键不在于掌握算法框架,而在于培养"把复杂任务设计成清晰流程"的能力。
从"替我上课"说起:Agent到底是什么
很多人一提到AI Agent(智能体)就觉得神秘,仿佛它是一种脱离大模型、能够独立思考的新物种。但如果剥开概念的外壳,Agent其实可以用一个再普通不过的场景讲清楚。
B站UP主唐宇迪在这节课里没有打开PPT,而是用了一个生活化的例子:某天早上你起不来床,跟室友说"哥们你替我去上课吧"。室友答应了。这个看似简单的委托,背后藏着Agent的全部逻辑。
室友要真正"替你上课",需要完成一连串动作:老师点名时替你答"到";老师要交作业时帮你交上去;老师讲了重点,还得帮你记笔记;甚至更贴心一点,他推理出你中午多半在寝室睡觉或打游戏,顺手在食堂帮你把饭打回来。
你只下达了一个命令——"替我上课",但这个命令不是一步到位的,它需要被拆解成一系列子任务,每个子任务再单独执行。这就是Agent的核心:接收一个需求,把它拆分成多个流程,逐一完成。
Agent和大模型的关系:不是替代,而是深度利用
有人会把Agent和大模型对立起来,认为Agent是比大模型更高级的东西。唐宇迪明确纠正了这个误区:Agent并没有脱离大模型,恰恰相反,它是在更充分地利用大模型。
大模型的典型交互是一问一答——你问一句,它答一句,再问再答,彼此之间相对独立。而Agent不同,它的工作方式是:
- 第一步:理解你的命令
- 第二步:把命令拆分成若干子任务(第一步干什么、第二步干什么……)
- 第三步:针对每个子任务逐一执行
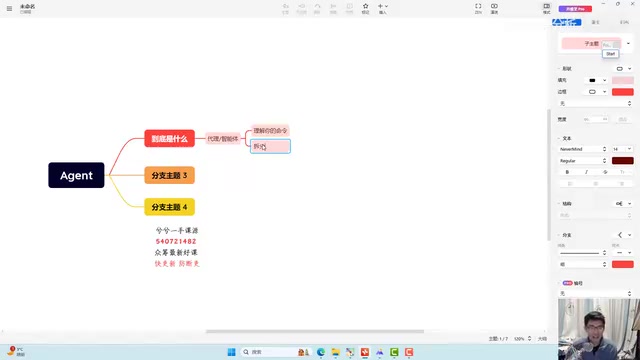
关键问题来了:Agent是怎么做到"拆分任务"的?是不是它长了脑子、真的变聪明了?答案是否定的。在Agent当中,一切拆分和决策都是靠调用大模型完成的。
比如系统先接到命令"帮唐宇迪上课",接着它把唐宇迪的基本状态、个人情况连同这条命令一起作为提示(prompt)交给大模型,大模型自动帮你把任务拆成若干子命令。到了执行环节,比如"现在老师在上课,我该做什么",它又去问大模型,得到"待会点名帮忙举手""顺便记笔记""回来路上买点吃的"这样的决策。
换句话说,Agent每做一个决策、每办一件事,都在和大模型做大量交互,反复询问"我当前的环境是什么、收到的命令是什么、该怎么完成"。
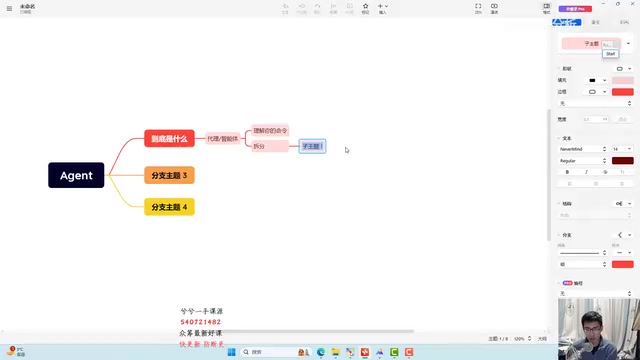
这种反复调用大模型的工作方式,在技术上通常被称为"ReAct"范式(Reasoning + Acting),即让模型在每一步同时进行推理和行动。每次调用大模型时,Agent会将当前的环境状态、历史动作记录和新的观察结果一起打包进提示,模型据此输出下一步动作——这意味着随着任务执行,提示会越来越长,token消耗也会累积放大。这也是Agent应用在成本控制上的一大挑战:一个看起来简单的目标,背后可能触发十几次甚至几十次大模型调用。
别神化Agent:真正靠谱的是"规则"
这节课最有价值的观点,是对当前Agent热潮的一次冷静提醒。
很多演讲、框架、项目都把Agent描述得神乎其神,好像它能自主分析、自主理解、自主进化。但唐宇迪直言:截至目前,Agent还达不到真正理解人类每个行为的水平。原因很直接——大模型会出现幻觉,输出并不稳定。
那么现实中的Agent靠什么保证稳定执行?答案是规则。
所谓规则,就是把关键流程"写死"。以"替我上课"为例,你把"必须帮我签到""必须帮我做这个""必须帮我做那个"明确设定好,让它按规则完美代理完成一件事。而这些规则,本质上是通过编写提示来设置的。
这里唐宇迪给出了一个很实用的思路:把任务目标、被代理人的个人信息、心理行为特征(比如"唐宇迪平时不爱上课,但考试前喜欢复习笔记")全部打包成提示,交给大模型,最终得到它在每一步该做的具体动作。
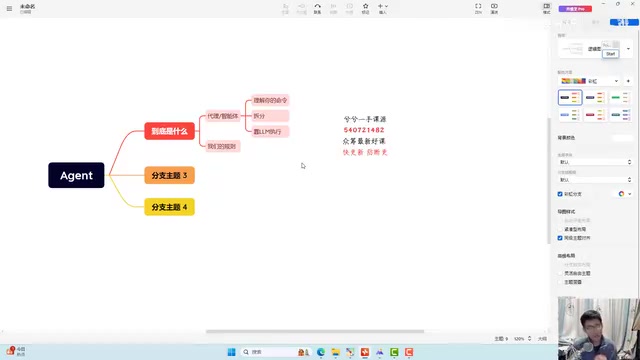
他还举了一个更贴近工程实践的类比:让Agent写代码,其实和真实软件团队一样——先有产品经理(PM)制定每一步流程,再把具体功能交给对应的程序员实现。整件事有一个完整、被设计好的流程,而不是让AI自己天马行空。目前的Agent还很难具备真正的自我思维,缺少规则约束时,结果往往很差。这正是当下Agent技术的局限所在。
大模型的"幻觉"(Hallucination)是指模型以高置信度输出事实上错误或凭空捏造的内容,根源在于大模型本质上是基于概率的文本预测系统,而非真正的知识检索或逻辑推理引擎。在单次问答中,幻觉顶多带来一次错误答案;但在Agent链式调用的场景下,一步幻觉会被后续步骤当作事实继承,错误会沿流程放大传播,最终导致整个任务失败甚至产生有害输出。这正是为什么在工程实践中,把关键判断节点"写死"成规则、而不是完全信任模型自主决策,是目前最主流也最保险的Agent设计策略。
一句话总结Agent的工作范式
把这节课的内容浓缩成一条主线,Agent的运作可以概括为:
接收需求 → 拆分成多个子任务 → 每个子任务结合你设计的规则(提示)→ 调用大模型 → 得到想要的输出
理解Agent,不需要背诵完美的定义。它是一个非常"活"的概念——你希望它帮你做什么、你怎么设计它的流程,完全可以根据自己的想法DIY。每个人眼中的智能体都可以不一样,没必要拘泥于统一的算法框架。
对于想入门Agent开发的人来说,这个认知底座非常重要:不要被"自主智能"的宣传迷惑,先学会把复杂任务拆解成清晰流程,再用提示为每一步设定好规则,让大模型在受控的框架里发挥能力。Agent的强大,来自你对流程的设计能力,而不是它凭空的"聪明"。
相关推荐

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。

SageMaker HyperPod:跨团队共享GPU集群的隔离与公平性实践
Amazon SageMaker HyperPod 推出跨团队共享GPU集群的参考架构,通过IAM Identity Center认证、Kubernetes命名空间隔离、Task Governance公平调度和成本分摊,实现算力安全共享与费用透明化。