数据增强后如何量化图像尺寸与形状变化?

用尺寸与形状两维统计指标量化裁剪缩放增强对数据集分布的影响
文章针对一位机器学习研究生被导师要求量化随机裁剪(0–90%)与随机缩放(0–20%)对图像目标影响的场景,指出核心问题是增强后的数据集分布是否仍代表原始分布,还是引入了可测量的偏差。作者建议从尺寸和形状两个维度展开:尺寸上计算边界框宽、高、面积的均值、标准差、中位数与四分位距,并绘制直方图或核密度曲线对比原始与增强分布;形状上以宽高比分布为首要指标,辅以圆形度等形状因子,并通过按原始尺寸分箱的交叉分析观察增强对小目标与大目标的不对称影响。工具层面推荐 Python 生态(scikit-image、OpenCV、pandas、matplotlib,TIFF 用 tifffile),并将流程写成可复用脚本。最后提醒记录增强参数的采样值,把参数分布与结果分布结合分析,才能完整回答增强以何种幅度、在哪个方向改变了数据。
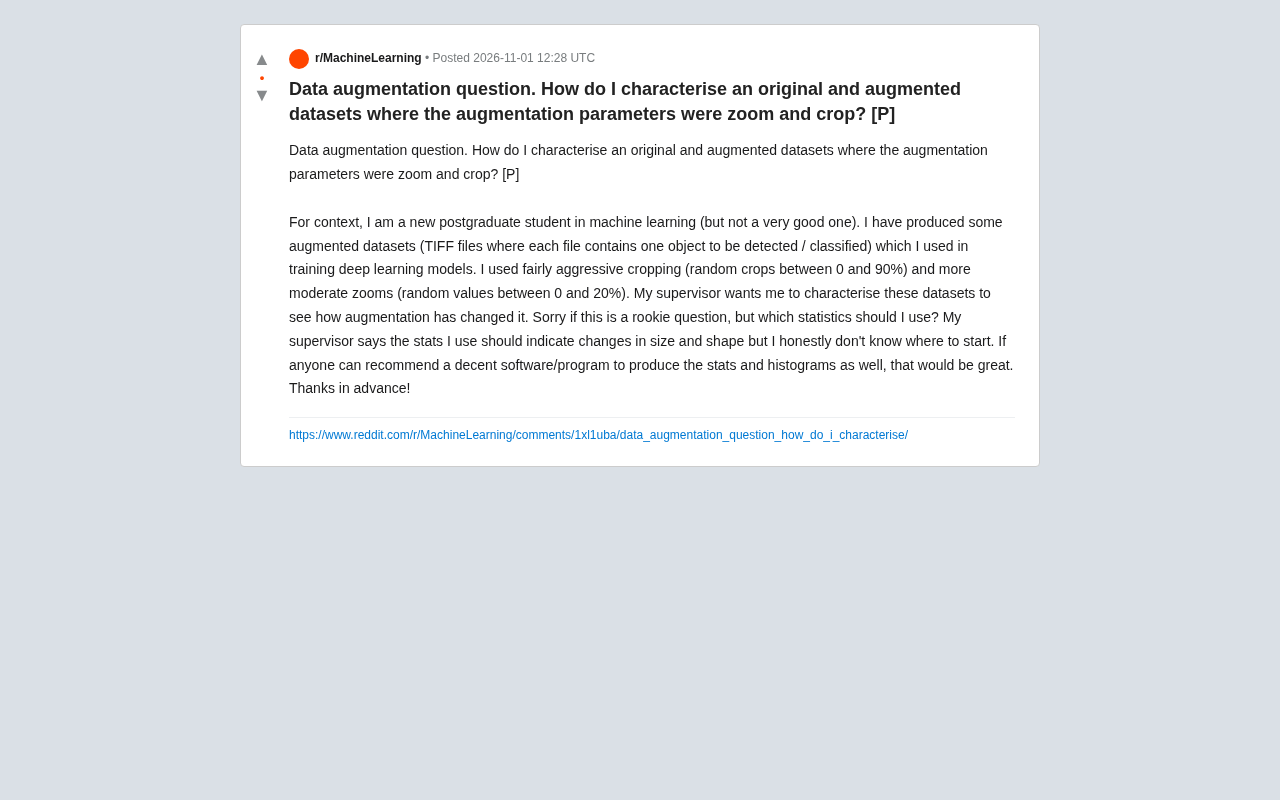
一位机器学习方向的研究生用随机裁剪(0–90%)和随机缩放(0–20%)生成了增强数据集,导师要求他量化这些增强对图像尺寸和形状的影响。这个问题在实践中有一定代表性——数据增强的效果往往凭感觉判断,缺少可解释的统计描述。
问题的本质:增强改变了什么
这位研究生的场景很具体:每个 TIFF 文件包含一个待检测或分类的目标,经过随机裁剪和缩放后,目标在图像中的占比、边界框尺寸、长宽比都可能发生系统性偏移。导师的要求其实指向一个核心问题:增强后的数据集分布是否仍然代表原始数据的真实分布,还是引入了可测量的偏差。
裁剪会直接移除边缘区域,当裁剪比例高达 90% 时,部分目标可能被部分截断或完全丢失。缩放虽然幅度温和(0–20%),但会改变目标在像素空间中的绝对尺寸。两者叠加后,增强数据集在"尺寸"和"形状"两个维度上的统计特征需要被明确刻画,否则后续模型性能的变化将难以归因。
尺寸维度的统计指标
针对尺寸变化,最直接的度量是目标边界框的宽度、高度和面积。建议对原始数据集和增强数据集分别计算这些量的均值、标准差、中位数和四分位距,并绘制分布直方图或核密度估计曲线进行对比。
如果数据集中每个文件只有一个目标,可以通过连通域分析或简单的阈值分割提取目标区域,再计算外接矩形。对于已经标注了边界框的数据,直接使用标注框即可。关键不是用多么复杂的统计量,而是让原始与增强两组分布在同一坐标系下可视对比——均值偏移反映系统性缩放,方差变化反映增强引入的随机性程度。
一个容易被忽略的点是:裁剪到 90% 时,大量样本可能只剩很小区域,面积分布会出现长尾甚至零值。这类样本应当在统计中单独标记,因为它们对检测任务的贡献与传统样本不同。
连通域分析(connected component analysis)是二值图像处理中的基础操作:将相邻的同类像素(通常是前景像素)聚合为独立区域,每个区域即为一个连通域。在目标提取场景中,先通过阈值分割得到前景掩码,再对掩码做连通域标记,即可分离出各个独立目标并计算其外接矩形(bounding box)。常用的实现包括 scikit-image 的 measure.label 与 regionprops、OpenCV 的 connectedComponentsWithStats。需要注意 4-连通与 8-连通的定义差异会影响小块区域的合并结果,对于细长或对角相邻的目标尤其敏感。
四分位距(Interquartile Range, IQR)是第三四分位数与第一四分位数之差,即数据中间 50% 的跨度。相比标准差,IQR 对极端值不敏感,因此特别适合描述裁剪后可能出现长尾甚至零值的目标面积分布。当增强导致部分样本目标几乎消失时,标准差会被这些离群值显著拉高,而 IQR 仍能稳健反映主体样本的离散程度。实践中常配合箱线图使用,箱体上下边即对应 Q1 与 Q3。
形状维度的刻画方法
形状变化比尺寸更微妙。裁剪和缩放都可能改变目标的宽高比,尤其是在目标非正方形时。宽高比(aspect ratio)的分布对比是第一步,可以直观看到增强是否让目标变得更"瘦长"或更"扁宽"。
如果需要更丰富的形状描述,可以引入形状因子(如圆形度、紧致度)或基于轮廓的矩特征。但对于导师提出的"指示尺寸和形状变化"这一要求,宽高比加上边界框尺寸的联合分布通常已经足够。更复杂的形状描述子在研究生阶段的初步分析中可能过度设计,反而增加解释成本。
交叉分析也值得做:把样本按原始尺寸分箱,观察每个箱内增强后的尺寸变化幅度,可以看出增强对小目标和大目标的影响是否对称。
圆形度(circularity)定义为 $4\pi A / P^2$,其中 $A$ 为区域面积、$P$ 为周长,取值在 0 到 1 之间,越接近 1 表示形状越接近圆。紧致度(compactness)常用 $P^2 / A$ 或其归一化形式表示,与圆形度互为倒数关系,数值越大说明形状越不规则或边界越复杂。二者都对边界噪声和分割质量较为敏感,因此在做增强前后对比时应保证分割或标注流程一致,否则测得的差异可能来自提取方式而非增强本身。
工具选择与实操建议
这位学生问到了具体软件。Python 生态是最直接的选择:用 scikit-image 或 OpenCV 做区域提取和轮廓分析,用 pandas 组织统计表,用 matplotlib 或 seaborn 出直方图和小提琴图。如果数据已有 COCO 或 YOLO 格式的标注,pycocotools 或直接解析标签文件即可拿到边界框。
TIFF 文件需要额外注意位深和通道数,读取时用 tifffile 库比通用图像库更稳妥。统计流程建议写成可复用脚本:输入原始目录和增强目录,输出对比统计表和分布图,这样导师复核或后续调整增强参数时可以直接重跑。
一个实践提醒
增强参数本身(裁剪比例、缩放因子的实际采样值)如果能在生成时记录到元数据中,后续分析会省力很多。如果当时没记录,也可以从增强前后图像的尺寸差异部分反推。无论哪种方式,把"参数分布"和"结果分布"放在一起看,才能完整回答导师的问题:增强到底以何种幅度、在哪个方向上改变了数据集。
相关推荐

MiniMax H3开源工作流:低显存也能打造呼吸感皮肤
本文介绍B站UP主分享的MiniMax H3双采样工作流,通过融合模型、破线LoRA和低显存节点,解决AI人物面部油腻问题,并让12G显存设备也能运行。包含模型搭配、双采样逻辑与参数设置详解。

手机本地大模型+ESP32:自制热量提醒器
B站UP主开源了一个热量摄入提醒器项目:手机APP用miniCPM开源模型本地拍照识别食物并估算热量,ESP32小屏幕同步数据,用绿黄红圆环展示摄入状态,可磁吸在冰箱门上随时提醒。

12GB显卡跑125B MoE?Strata三级协同引擎解析
开源C++引擎Strata让12GB-16GB家用显卡本地跑125B MoE模型,生成速度达40-95 Token/s。本文拆解其显存、内存、固态三级协同原理,说明模型选型前提、硬件配置门槛与启动方式。