双轴政策蕴涵基准DAPE:政策变迁推理新范式

DAPE双轴基准揭示大模型零样本难判政策变迁,微调后可逼近人类。
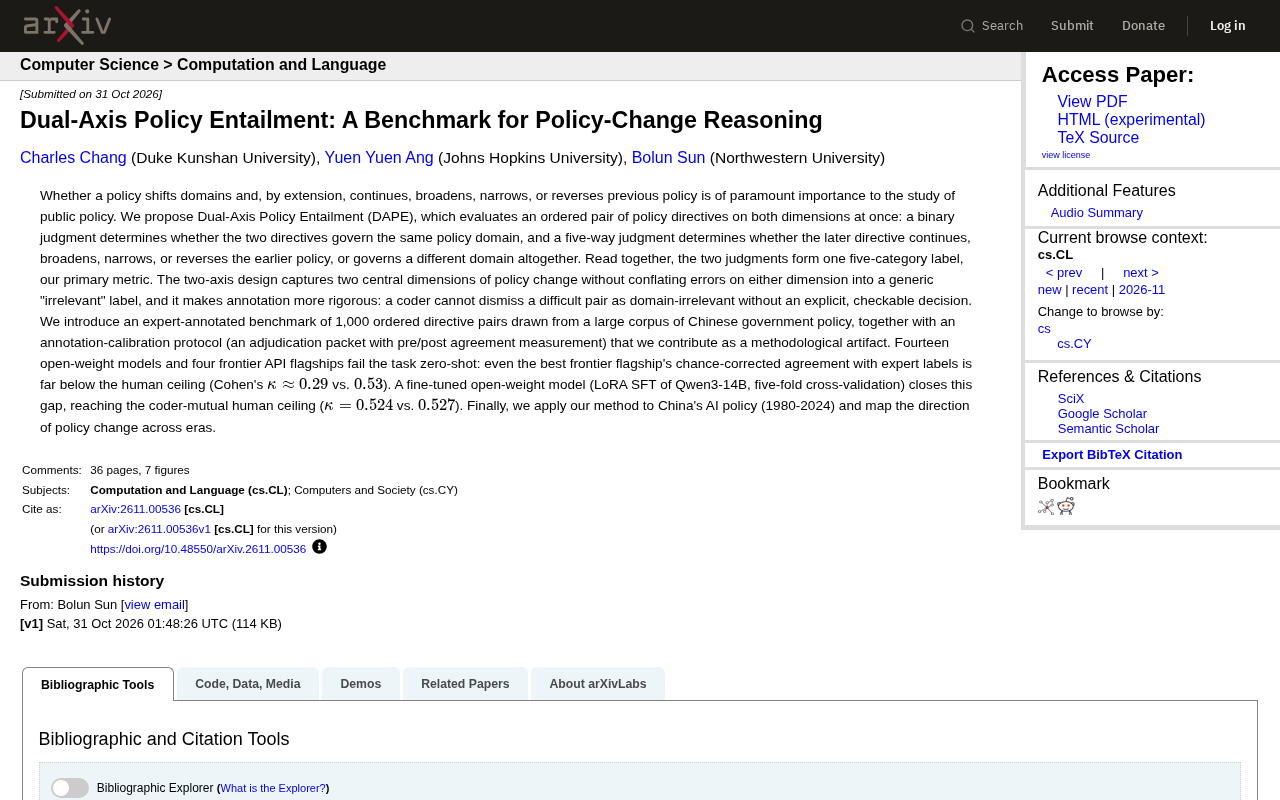
文章介绍双轴政策蕴涵基准DAPE,用于判断新政策相对旧政策是延续、拓宽、收窄、逆转还是转向不同领域。其核心是把判断拆为"是否同一政策领域"的二元决策与"变迁方向"的五元决策,合成为五类标签,避免标注者把难判政策对笼统归为不相关。研究者构建了1000个专家标注的中国政府政策对及标注校准协议。零样本测试中,14个开源模型与4个前沿API旗舰全部未通过,最佳Cohen's κ仅约0.29,远低于人类上限0.53;而用LoRA SFT微调Qwen3-14B后κ达0.524,接近人类水平。该方法还被用于绘制1980至2024年中国AI政策变迁图谱。
政策变迁推理为何需要新基准
公共政策研究中的一个核心问题是:一项新政策是延续、拓宽、收窄还是逆转了旧政策?传统方法往往依赖人工编码,但面对海量政策文本时,标注者容易将难以判断的政策对归为“不相关”,从而模糊了政策变迁的细微方向。为此,研究者提出双轴政策蕴涵(Dual-Axis Policy Entailment, DAPE) 基准,旨在同时评估政策对在“领域”和“变迁方向”两个维度上的关系。
DAPE如何工作:双轴设计与五类标签
DAPE的核心创新在于将政策对判断拆解为两个有序决策:
- 二元判断:两个政策指令是否治理同一政策领域?
- 五元判断:后一项政策是延续、拓宽、收窄、逆转前一项政策,还是转向了不同领域?
两个判断合起来形成一个五类别标签(延续、拓宽、收窄、逆转、不同领域),作为主要评估指标。这种设计避免将某一维度的错误混淆为笼统的“不相关”,同时让标注更严谨——编码者不能随意将困难的政策对标记为领域无关,而必须做出可检查的明确决策。
蕴涵(Entailment) 在此处借自自然语言推理(NLI)任务:给定前提句与假设句,判断后者是否可由前者逻辑推出。DAPE将其改造为"政策蕴涵"——把前一项政策视为前提、后一项政策视为假设,用蕴含关系刻画新政策相对于旧政策的语义位置:"延续"对应纯蕴涵,"拓宽"对应假设覆盖更广的适用范围,"收窄"则相反,"逆转"意味着语义方向相反,"不同领域"表示前提与假设不构成可比关系。这种类比的价值在于把政策变迁这种模糊的定性判断,转写为可标注、可计算的有序分类问题。
专家标注基准与校准协议
研究者构建了一个专家标注的基准,包含1000个有序政策指令对,均从中国政府的庞大政策语料中抽取。同时,他们贡献了一套标注校准协议(包含裁决包和前后一致性测量),作为方法论工具,确保标注质量可量化、可复现。
模型表现:前沿旗舰也零样本失败
在零样本设置下,14个开源权重模型和4个前沿API旗舰模型均未能通过该任务。即便是表现最好的前沿旗舰模型,其与专家标签的随机校正一致性也远低于人类上限(Cohen's κ ≈ 0.29 对比 0.53)。这意味着现有大模型在政策变迁推理上仍与人类专家存在显著差距。
Cohen's κ(Cohen's kappa) 是衡量两名标注者(或模型与专家)一致性的统计量,取值通常在0到1之间,计算时扣除了双方仅凭随机猜测也可能达成一致的部分:κ = (Po − Pe) / (1 − Pe),其中Po为观察到的实际一致率,Pe为期望的随机一致率。一般认为κ > 0.6为实质性一致,0.4–0.6为中等一致。因此文中κ ≈ 0.29与0.53的差距不只是数值高低,而意味着模型与专家的一致程度仅略高于偶然水平,与人类专家之间的中等一致存在质的鸿沟。使用随机校正指标而非原始准确率,是为了避免类别分布不均衡(如"延续"占比偏高)导致的虚高表现。
微调开源模型逼近人类水平
研究进一步表明,对开源模型进行微调可以大幅缩小差距。采用LoRA SFT对Qwen3-14B进行五折交叉验证微调后,模型达到编码者间人类上限(κ = 0.524 对比 0.527)。这一结果说明,通过针对性微调,开源模型能在专业政策推理任务上接近人类标注者的一致性水平。
LoRA(Low-Rank Adaptation,低秩适配) 是一种参数高效微调方法:冻结预训练模型的全部原始权重,在注意力等层的权重矩阵旁注入两个低秩矩阵A与B,仅训练这两个小矩阵,从而以极少的可训练参数(通常不到原模型的1%)近似完整的微调效果。SFT(Supervised Fine-Tuning,监督微调) 指用带标签的输入—输出样例以标准交叉熵损失继续训练模型。二者结合即为"LoRA SFT",优点是显存占用低、训练快、可为每个任务保存独立的轻量适配器。五折交叉验证则将1000个政策对分成五份,轮流以四份训练、一份评估,报告五次的平均κ,用以降低单次划分带来的评估波动。
应用实例:中国AI政策变迁图谱(1980-2024)
作为方法的应用,研究者将DAPE用于分析中国人工智能政策(1980-2024年),并绘制了不同时代的政策变迁方向。这展示了该基准在真实政策分析中的实用价值,也为政策研究者提供了一种可扩展的量化工具。
意义与展望
DAPE的提出不仅填补了政策变迁推理基准的空白,还通过双轴设计提升了标注的严谨性。其校准协议和微调方案为后续研究提供了可复用的方法论。尽管当前大模型零样本表现不佳,但微调后的开源模型已接近人类水平,这为政策分析自动化带来了希望。未来,该基准有望扩展到更多语言和领域,推动政策智能分析的发展。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。