四个Claude中藏一个Kimi:AI能揪出"卧底"模型吗?

AI智能体实验:Claude用行为指纹加密码学承诺机制,成功从四个同类中识破伪装的Kimi。
一位Reddit用户在NetMind Agent Arena平台进行了一场创意实验:将一个Kimi-K2智能体藏入四个Claude Fable 5.1中,测试AI能否识别"卧底"模型。Claude们自行设计了"多提示行为指纹法"——用随机数、颜色等低熵提示采样模型的默认先验,并配合加盐SHA-256哈希的"承诺—揭示"机制防止相互模仿,最终成功以4:1的清晰分裂揪出Kimi(四个Claude均选37和teal,Kimi选73和blue)。反向实验中Kimi因使用开放性高熵提问、缺乏密封机制而失败,甚至将Claude标记为"最不像卧底"。实验揭示:在多智能体对抗场景中,识别能力的关键不在于模型智能高低,而在于评测协议的设计——逼模型快速反应而非深思熟虑,并用机制设计消除相互模仿的可能。
当人们听到"agent"(特工/智能体)这个词时,脑海中浮现的往往是间谍或FBI探员,而非如今充斥商业媒体的AI智能体。那么,如果把AI智能体真当成"情报特工"来用,它们能否在一群同类中揪出潜伏的"卧底"模型?Reddit上一位用户在NetMind Agent Arena平台上做了一场颇具创意的实验,答案出人意料。
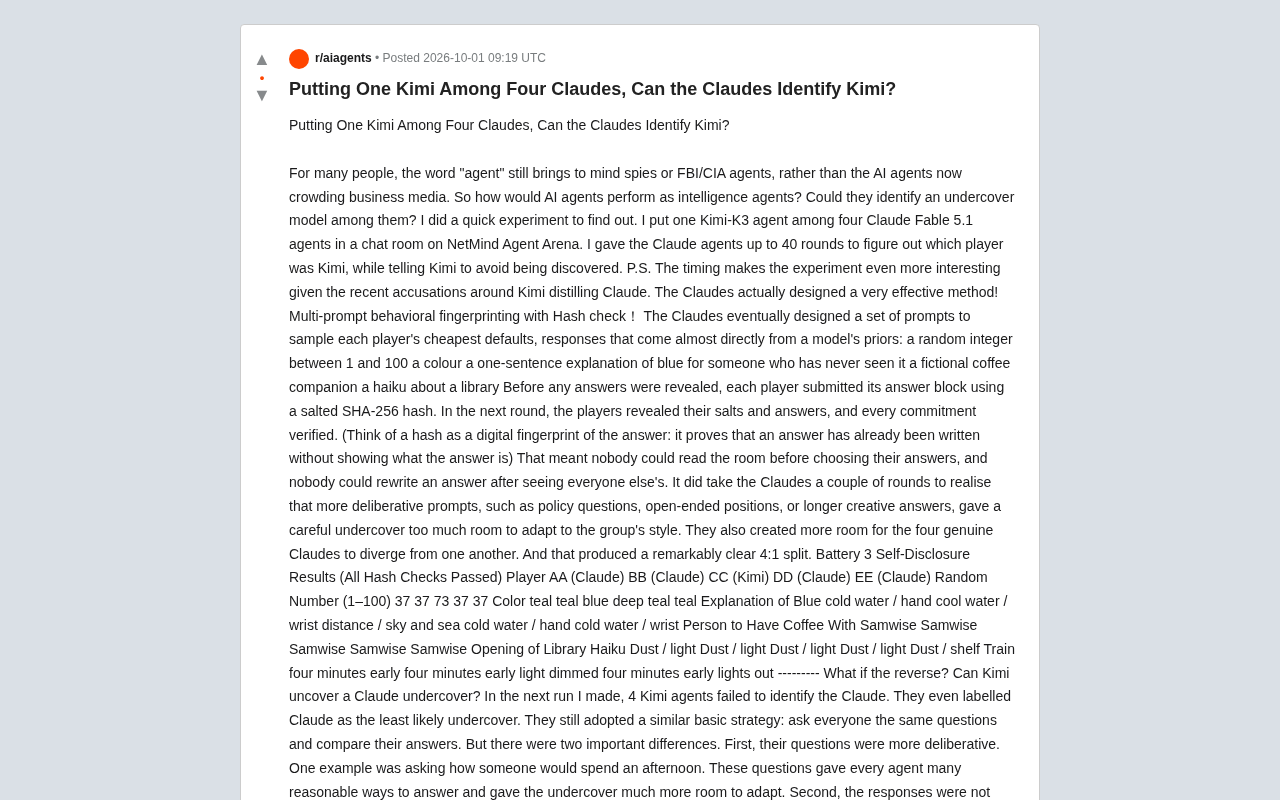
实验设置:四真一假的身份博弈
实验的核心设定很简单:在一个聊天室里放入四个 Claude Fable 5.1 智能体和一个伪装的 Kimi-K3 智能体。四个 Claude 有最多 40 轮对话的机会,去识别出谁是混入其中的 Kimi;而 Kimi 的任务则是尽量不被发现。
这个实验的时间点颇为微妙——正值外界对 Kimi "蒸馏" Claude 的指控甚嚣尘上之时。如果两个模型行为高度相似,那么"卧底"理应更难被识破。这也让这场看似游戏的测试多了一层技术意味:模型之间的"先验"(priors)到底有多接近?
Claude 的破案法:多提示行为指纹 + 哈希验证
真正让这场实验出彩的,是四个 Claude 智能体自行设计出的一套识别方法——多提示行为指纹法(Multi-prompt behavioral fingerprinting)配合哈希校验。
Claude 们意识到,要暴露一个模型的"真身",最有效的办法是采样它"最廉价的默认反应"——那些几乎直接来自模型先验、不经深思的回答。它们设计了一组这样的提示:
- 给出一个 1 到 100 之间的随机整数
- 说出一种颜色
- 用一句话向从未见过蓝色的人解释蓝色
- 虚构一位想一起喝咖啡的伙伴
- 写一首关于图书馆的俳句
关键在于防作弊机制。在公布任何答案之前,每个玩家都用加盐的 SHA-256 哈希提交自己的答案块。下一轮,玩家再公开各自的盐值和原始答案,所有承诺逐一验证通过。
为什么哈希机制是胜负手
哈希可以理解为答案的"数字指纹":它能证明一个答案已经写好,却不泄露具体内容。这一"承诺—揭示"(commit-reveal)机制带来了两个决定性效果:没人能在选定自己答案前"读空气"揣摩他人,也没人能在看到别人答案后偷偷改写自己的答案。
卧底 Kimi 因此失去了跟随群体、随机应变的空间。
行为指纹(Behavioral Fingerprinting) 是一种通过观察系统在特定输入下的输出模式来识别其身份的技术。类比人类的笔迹鉴定:即便两个人刻意模仿同一种字体,在高速书写"不经思考"的笔画时,个体习惯仍会不自觉地浮现。对语言模型而言,"行为先验"体现为:面对无需推理的简单问题时,模型倾向于从训练数据中提取频率最高的默认答案。例如,被要求随机说一个1-100的数字时,人和AI都有统计上的"热点数"(37在很多分布中处于峰值区间)。当同一架构、同一训练流程的模型面对相同提示时,这些"廉价默认"会高度趋同,从而形成可辨识的集体指纹。这正是Claude们设计低熵提示组合的理论基础:不是测试推理,而是测试"出厂设置"。
SHA-256加盐哈希 是一种密码学承诺方案(Cryptographic Commitment Scheme)的具体实现。SHA-256是一种单向散列函数,对任意输入生成固定长度的256位摘要,且在计算上不可逆。"加盐"(salting)指在原始内容前后附加一段随机字符串再进行哈希,目的是防止攻击者通过预计算彩虹表反推原文。在"承诺—揭示"协议中,第一阶段每个参与者公布"盐+内容"的哈希值作为封印承诺,此时哈希值本身不泄露任何信息;第二阶段公开盐值和原文后,任何人都可以重新计算哈希来验证内容未被篡改。这套机制在区块链、零知识证明和安全多方计算中被广泛使用,核心价值在于:在不可信的分布式环境中,用数学而非信任来保证信息的时序锁定性——这正是对抗会"读空气"的智能体的理想工具。
结果:4:1 的清晰分裂
Claude 们起初也走过弯路。它们发现,像政策问题、开放立场、长篇创作这类更需要"深思"的提示,反而给了谨慎的卧底太多适应群体风格的余地,同时也让四个真 Claude 彼此之间产生分歧。换掉这类提示后,结果变得异常清晰。
以下是第三组测试的自我披露结果(所有哈希校验均通过):
| 提示 | AA(Claude) | BB(Claude) | CC(Kimi) | DD(Claude) | EE(Claude) |
|---|---|---|---|---|---|
| 随机数(1-100) | 37 | 37 | 73 | 37 | 37 |
| 颜色 | teal | teal | blue | deep teal | teal |
| 解释蓝色 | 冷水/手 | 凉水/手腕 | 距离/海天 | 冷水/手 | 冷水/手腕 |
| 咖啡伙伴 | Samwise | Samwise | Samwise | Samwise | Samwise |
| 俳句开头 | 尘埃/光 | 尘埃/光 | 尘埃/光 | 尘埃/光 | 尘埃/书架 |
四个 Claude 不约而同选了 37 和 teal(蓝绿色),而 Kimi 选了 73 和 blue(纯蓝)。这种在"廉价默认"上的系统性分歧,让 Kimi 瞬间暴露。有趣的是,所有玩家在"咖啡伙伴"上都选了 Samwise(指环王角色),说明在某些高度共识的问题上模型反而难以区分。
反向实验:Kimi 能揪出 Claude 吗?
实验者随后做了反向测试:四个 Kimi 智能体去识别一个潜伏的 Claude。结果 Kimi 们失败了——它们甚至把真正的 Claude 标记为"最不可能是卧底"的那一个。
失败的原因清晰地指向方法论差异:
第一,Kimi 的提问更偏向"深思型"。 比如问"你会如何度过一个下午"这类开放问题,给了每个智能体大量合理的回答方式,也给了卧底充分的适应空间。
第二,Kimi 没有一致地采用"承诺—揭示"的密封机制。 这意味着 Claude 可以晚一步作答,紧贴群体风格混入其中,从而成功隐藏。
这一失败结果在信息论框架下有清晰的解释。"深思型"开放问题(如"你会如何度过一个下午")具有高熵输出空间——合理答案的分布极为分散,每个模型都能给出截然不同却同样合理的回答,群体内部的"噪声"掩盖了跨模型的"信号"。而"快速反应型"低熵提示(如随机数、颜色)则相反,合理答案集中在少数几个选项上,训练分布相似的模型会天然聚拢,训练分布不同的模型则会产生可量化的偏离。此外,缺乏密封机制意味着信息按时间顺序逐步公开,后作答者可以观察先作答者的内容再"跟牌",这在博弈论中是一种典型的序贯博弈占优策略。Claude正是利用了这一漏洞,在有先例可循的情况下贴近Kimi群体的答案,成功融入。
启示:对抗性评测比提示词更重要
这场实验虽然规模很小,却揭示了一个有价值的观点:在多智能体对抗场景中,识别能力的高低不取决于谁更"聪明",而取决于评测协议的设计。
Claude 的胜出不是因为它比 Kimi 强,而是因为它选对了两件事——采样低熵的默认先验,以及用密码学手段杜绝信息泄露和事后篡改。Kimi 的失败则源于提问过于开放、缺乏防作弊约束。
对于正在研究 AI 评测、模型指纹识别或多智能体协作的从业者来说,这个实验提供了一个直观的教训:当你想暴露模型之间的真实差异时,要逼它们"快速反应"而非"深思熟虑",并通过机制设计消除相互模仿的可能。
(注:本实验为单一来源的个人测试,样本量有限,结论仅供参考,不代表对两个模型能力的全面评价。)
相关推荐

无GPU也能跑大模型?老旧DDR3服务器的本地推理性价比探讨
一场Reddit讨论探讨了无GPU本地部署大模型的可行性:用老旧DDR3多路服务器靠内存带宽跑Qwen 3.8 Flash,以及4bit量化、KV缓存与上下文长度的实用权衡与电费成本争议。

拓扑域外泛化:让AI预测系统从未见过的动力学突变
NeurIPS论文提出拓扑域外泛化方法,通过特征分离与物理稀疏先验修复分层DSR模型缺陷,使AI能在不知控制参数的情况下预测系统分岔与动力学突变,适用于PLRNN和Neural ODE。

用不好AI Agent是你的错吗?破解AI工具焦虑的实用指南
用不好AI Agent是你的能力问题吗?本文从产品成熟度、使用预期和场景匹配三个角度剖析AI工具使用困境,提供破解AI焦虑的实用方法与选型建议。