SimPOTrans:用强化学习让离线语音翻译模型自适应同传

SimPOTrans用两阶段强化学习后训练,让离线语音翻译模型自适应为对话式同传模型。
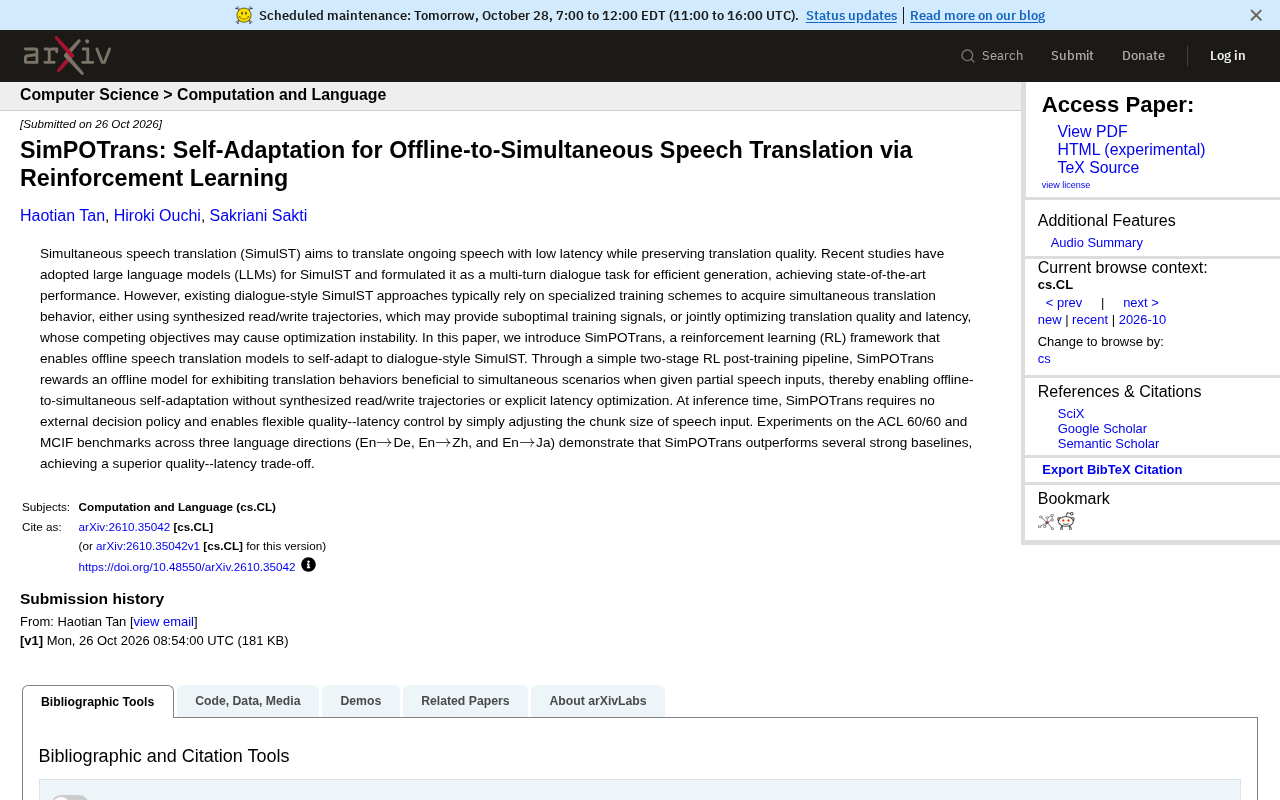
SimPOTrans 提出一种基于强化学习的后训练框架,将离线语音翻译模型自适应转化为对话式同声传译模型。针对现有对话式同传依赖合成读写轨迹或联合优化质量与延迟所导致的次优训练信号和优化不稳定问题,该方法设计两阶段 RL 流程:在模型仅接收部分语音输入时,奖励有利于同传的翻译行为,从而无需合成轨迹和显式延迟优化即可实现离线到同传的迁移。推理阶段无需外部读写决策策略,仅通过调整语音输入分块大小即可灵活控制质量—延迟权衡。在 ACL 60/60 和 MCIF 基准的英德、英中、英日三个方向上,SimPOTrans 优于多个强基线,验证了该范式的有效性。
同声传译(Simultaneous Speech Translation, SimulST)的目标是在说话人还在讲话时就开始翻译,以极低延迟输出译文,同时尽量保持翻译质量。近年来,研究者开始借助大语言模型(LLM)来做同传,把翻译过程建模成多轮对话任务,由此取得了当前最优的性能。然而,这类对话式同传方案通常依赖专门的训练策略来获得"边听边译"的行为——要么用合成出来的读写轨迹(synthesized read/write trajectories)来训练,要么联合优化翻译质量和延迟。前者提供的训练信号未必最优,后者的两个目标彼此竞争,容易导致优化不稳定。
针对这一痛点,论文提出了 SimPOTrans,一个基于强化学习(RL)的框架,让原本做离线语音翻译的模型能够自适应地转变为对话式同传模型。它的核心思路并不复杂:不需要合成读写轨迹,也不需要显式地对延迟做优化,而是通过一个简单的两阶段 RL 后训练流程,在模型只拿到部分语音输入时,奖励那些对同传场景有利的翻译行为,从而完成从离线到同传的自适应迁移。
为什么现有对话式同传方案不够好
要理解 SimPOTrans 的价值,得先看清现有方法的局限。对话式同传把翻译拆成一个个小的生成步骤,模型需要自己判断"现在读到哪、该写什么"。为了让模型学会这种节奏,常见做法是人为构造读写轨迹作为监督信号,但合成轨迹毕竟不是真实同传行为,模型学到的可能只是模仿一个并不完美的"剧本"。另一种做法是把翻译质量和延迟放在一起联合优化,可这两者天然存在张力——想翻得准往往要等更多上下文,想延迟低就得更早输出。两个目标互相拉扯,训练过程容易出现不稳定。
SimPOTrans 绕开了这两个问题。它不依赖任何合成的读写轨迹,也不把延迟当作一个显式的优化项,而是把"在同传场景下表现良好"这件事直接转化为奖励信号,交给强化学习去引导模型。
读写轨迹(read/write trajectories) 是对话式同传中的核心概念。模型在生成过程中交替执行两种动作:读取(read)更多语音输入,或写出(write)已确定的译文。一条读写轨迹就是这两个动作的序列。理想情况下,模型应在信息足够时写出高质量译文,在信息不足时继续读取。但真实同传行为难以大规模标注,因此常见做法是用启发式规则或离线模型合成轨迹作为监督信号。问题在于,合成轨迹本身可能偏离最优策略,模型模仿它相当于学习一个次优示范,从而限制了性能上限。
质量—延迟联合优化 指在训练时同时最小化翻译损失和延迟指标(如平均滞后词数或计算感知延迟)。由于两者天然冲突——等待更多上下文能提升质量但增加延迟——联合优化常需在损失函数中手工平衡权重,容易导致训练震荡或陷入某一目标的局部最优。SimPOTrans 的动机正是绕开这种显式权衡。
两阶段 RL 后训练:让离线模型自己学会同传
SimPOTrans 的整个流程可以概括为"离线模型 + 两阶段强化学习后训练"。第一阶段,模型在部分语音输入的条件下被引导去产生有利于同传的翻译行为;第二阶段进一步强化这种自适应能力。整个过程中,模型不需要外部给定的读写决策策略,也不需要显式的延迟惩罚项,而是通过奖励机制自发地学会在信息不完整时如何输出。
这种设计的巧妙之处在于它把"什么时候该翻"的决策内化到了模型自身。传统方案往往需要一个外部的决策策略来决定读多少、写多少,而 SimPOTrans 在推理阶段完全不需要这样的外部策略,模型自己就能处理流式输入。
强化学习后训练(RL post-training) 指在已有监督预训练模型的基础上,用强化学习目标进一步调整参数。与监督微调不同,它不要求逐词标注的正确输出,而是定义奖励函数,让模型通过采样和策略梯度(如 REINFORCE 或 PPO)最大化期望奖励。在 SimPOTrans 中,奖励设计针对“模型只拿到部分语音输入”这一条件:当输入不完整时,那些提前输出合理译文、避免 hallucination 或不当等待的行为会获得更高奖励。两阶段流程中,第一阶段先让模型适应部分输入条件,第二阶段在此基础上进一步强化同传行为,使离线模型逐步获得流式处理能力,而无需人工构造读写决策标签。
推理阶段的质量—延迟灵活控制
SimPOTrans 在推理时提供了一个很实用的调节手段:只需调整语音输入的分块大小(chunk size),就能在翻译质量和延迟之间做灵活权衡。分块越小,模型越早开始翻译,延迟越低,但可用上下文越少;分块越大,上下文越充分,质量更有保障,但延迟相应上升。这种"一个旋钮调到底"的设计,对实际部署相当友好——同一个模型可以按场景需求在不同工作点上运行,而不必为每个延迟档位单独训练模型。
分块大小(chunk size) 是流式语音翻译中的关键推理超参数。语音输入被切分为固定长度的块,模型每收到一块就决定是否输出译文。分块越小,模型越早获得输出机会,延迟更低,但每步可见的声学上下文更少,译文质量可能下降;分块越大,上下文更充分,质量提升但首词输出更晚。SimPOTrans 之所以能仅靠调整分块大小来控制权衡,是因为其 RL 后训练已让模型学会在信息不完整时做出合理决策,因此推理时无需额外的读写策略网络或延迟惩罚项,同一套参数即可覆盖多个延迟档位。
实验结果:三个语言方向上的质量—延迟权衡
论文在 ACL 60/60 和 MCIF 两个基准上,针对三个语言方向(英语→德语、英语→中文、英语→日语)进行了实验。结果显示,SimPOTrans 优于多个强基线,在质量—延迟权衡上取得了更优的表现。这说明通过强化学习让离线模型自适应同传,是一条可行且有效的路径,而且不需要依赖合成轨迹或显式延迟优化这些容易出问题的环节。
从更广的视角看,这项工作提供了一个有启发的思路:与其费劲地为同传构造专门的训练信号,不如把"什么行为对同传有利"定义成奖励,让模型自己在强化学习中摸索出来。对于希望把现有离线翻译模型快速改造成流式同传能力的团队来说,这种后训练范式降低了门槛,也避免了联合优化带来的不稳定性。
当然,目前的结果集中在三个语言方向和两个基准上,方法在更多语言、更多场景下的泛化能力还有待进一步验证。但就解决"离线到同传自适应"这一核心问题而言,SimPOTrans 给出了一条简洁而有效的路线。
相关推荐
思科高管:不用AI就守不住安全,漏洞利用窗口仅八九分钟
思科安全负责人 Jeetu Patel 指出,漏洞公布到被利用仅八九分钟、平均补丁周期约 45 天、仅 20% 漏洞被修补,攻防速度差已让静态安全策略失效。他主张安全控制与策略必须智能体化、动态化,并以 OpenAI 作为底层基础支撑这一转向。
Jev AI的校准概率:输出0.8意味着80%正确率
Jev AI 的核心特性是校准概率:输出0.8意味着约80%的正确率。这种可测量的置信度让开发者能在真实代码库中自信使用 Jev,并为阈值设定和工程决策提供可解释的依据。
30行Python自建MCP服务器并接入Claude Code
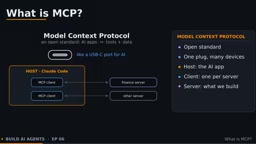
用约30行Python把财务工具封装成MCP服务器,并通过stdio传输接入Claude Code。本文拆解MCP的三种角色与Tools、Resources、Prompts三类能力,讲解装饰器与类型提示的用法、MCP Inspector自测流程,以及claude mcp add的命令格式与作用域设置。