slopsieve:AI代码泛滥时代的diff质量检测工具
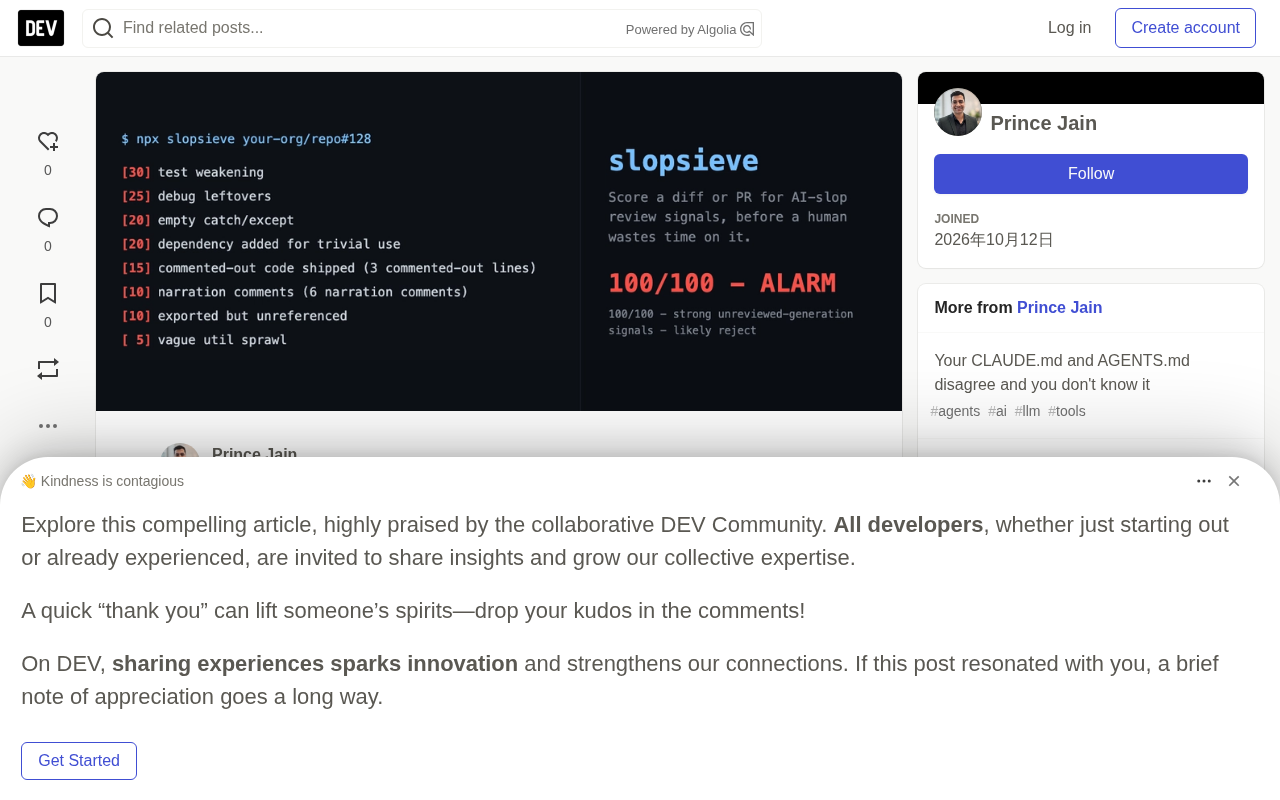
slopsieve 是一款评估 diff 卫生状况的零依赖 Node CLI,用 12 项加权检测帮助开源维护者过滤 AI 垃圾补丁。
面对 cURL 取消 bug bounty、Godot 被低质量 PR 淹没等 AI 垃圾代码困扰开源生态的现实,slopsieve 提供了一种务实的应对方式。它是一款零依赖 Node CLI 工具,解析 unified diff,运行 12 项加权检查,对测试弱化、调试残留、空 catch 块、琐碎依赖、注释代码、死导出等问题打分,并输出具体文件与行号。工具支持 --fail-at 作为 CI 门禁、--json 供其他工具消费。作者强调它并非 AI 检测器,人类和 LLM 都可能写出高分或低分 diff,它只评估可量化的卫生信号。开发中暴露的正则误匹配 bug 也说明规则型检测的边界条件远比想象复杂。
当代码审查被AI垃圾淹没
开源维护者正面临一个新问题。cURL因为不堪AI生成的垃圾补丁骚扰,直接取消了bug bounty项目。Godot项目被大量低质量PR淹没。GitHub甚至开始讨论给PR加"终止开关"。这些案例指向同一个痛点:代码看起来没问题,直到你真正去读它。
一个疲惫的深夜审阅者需要在凌晨一点快速判断一个diff的质量。slopsieve就是为这个场景设计的工具。
slopsieve是什么
slopsieve是一个零依赖的Node CLI工具,对diff或PR进行评分,检测12个代码卫生信号。它的设计目标不是判断代码是否由AI生成,而是评估diff的卫生状况。
使用方式很直接:
$ npx slopsieve fixtures/slop.patch

SLOP SCORE: 100/100 - ALARM
4 files · +37 -8 lines

FLAGS
  [30] test weakening        tests/cart.test.js:24 it.skip(...)
  [25] debug leftovers       src/cart.js:25 console.log("checking qty", qty)
  [20] empty catch/except    src/utils.js:12 } catch (e) {}
  [20] trivial dependency    package.json:17 adds 'is-odd'
  [15] commented-out code    3 commented-out lines
  [10] narration comments    6 narration comments
  [10] dead exports          'isQuantityOdd' referenced nowhere in this diff
  [ 5] vague util sprawl     src/utils.js created
输出结果清晰地标注了每个问题所在的文件和行号。
unified diff 是版本控制系统中描述代码变更的标准格式,也是 slopsieve 唯一需要解析的输入。它由一系列“hunk”(代码块)组成,每个 hunk 以 @@ -旧起始行,旧行数 +新起始行,新行数 @@ 作为头部,随后是上下文行(前缀空格)、删除行(前缀 -)和新增行(前缀 +)。这种格式的好处是与 Git、GitHub PR、git diff 输出天然兼容,工具只需处理纯文本,不必连接任何 API 或仓库。对 slopsieve 而言,加权检测的关键在于“变更意图”而非最终文件内容:一段被删除的 assert 是否意味着测试被削弱,一个新增的 console.log 是否只是调试残留,都必须在 diff 的增删行中判断。因此它的检测范围天然受限于 diff 本身,发生在变更之外的调用方、未触及的测试文件或历史上下文都不会进入评分。
12项加权检测机制
slopsieve解析unified diff格式,运行12项加权检查。从示例输出可以看到几类典型问题:
测试弱化(权重30) —— 检测it.skip、被删除的断言等操作。这是权重最高的信号,因为跳过测试往往意味着代码没有真正通过验证。
调试残留(权重25) —— 捕捉console.log、debugger语句等。示例中console.log("checking qty", qty)被准确标记。
空catch块(权重20) —— 吞掉异常的catch (e) {}模式。
琐碎依赖(权重20) —— 引入如is-odd这类可以用一行代码替代的npm包。
注释掉的代码、叙述性注释、死导出、工具函数蔓延 —— 覆盖了代码审查中常见的其他卫生问题。
工具支持--fail-at参数将其变为CI门禁,--json输出可供其他工具消费。CI集成后,可以在合并前自动拦截低质量diff。
加权评分的设计逻辑值得单独说明。每类问题并非简单计一票,而是按照它对审查者注意力的消耗和对代码质量的破坏程度赋予权重:测试弱化 30 分、调试残留 25 分、空 catch 与琐碎依赖各 20 分,依此类推。最终 slop 分数是所有命中项的得分之和,达到阈值即触发 ALARM。这种线性可加模型的好处是透明——维护者能立刻看出是哪一项把分数推高,而不是面对一个黑箱判断。它也为 CI 门禁提供了可调参数:通过 --fail-at 指定容忍上限,团队可以根据自身标准决定“多少分算不可接受”。需要留意的是,权重是主观设定的启发式,并非经过统计校准的概率值,因此应把它理解为排序和提示工具,而非精确质量度量。
一个暴露工具自身bug的故事
作者分享了一个自嘲的细节:debug残留检测的正则表达式dd\s*\((用于匹配Laravel的dump函数)意外匹配到了isQuantityOdd(,因为字符串"dd("隐藏在"Odd("中。
这个bug导致工具对测试fixture完全误判。修复方式是添加单词边界,测试fixture也保留下来确保回归不会重现。这个细节展示了规则型检测工具的典型陷阱:正则匹配的边界条件远比想象中复杂。
单词边界(word boundary) 在正则表达式中写作 \b,用于断言某个位置的一侧是单词字符(字母、数字或下划线)、另一侧不是,从而避免子串误匹配。作者原本用 dd\s*\( 匹配 Laravel 的 dump 或 dd() 调试调用,但该模式并不要求 dd 前面是非单词字符,于是标识符 isQuantityOdd 中的末尾 dd( 被当成了 Laravel 调试函数。修复方式是在模式前加上单词边界,使其只在 dd 本身是完整标识符时匹配。这个案例揭示了规则型静态检测的典型脆弱性:模式越短越容易误报,越具体则覆盖越窄。它同时说明为什么这类工具通常需要配套的测试 fixture——只有把曾经出错的样本固化进回归测试,才能防止相似边界条件在后续改动中再次翻车。
不是AI检测器
作者明确了一个重要边界:slopsieve不是AI检测器。人类可以写出100/100的垃圾diff,LLM也可以写出0/100的干净代码。
这种定位是务实的。与其试图判断代码来源(这在技术上不可靠),不如聚焦于可量化的卫生信号。README中列出了启发式规则的盲区:两行catch块、diff之外的调用方、其他语言的注释模式等。
对代码审查生态的影响
slopsieve回应的是一个真实且正在恶化的生态问题。开源维护者的时间被低质量贡献消耗,而AI工具降低了生成看似合理代码的门槛。
规则型检测有天然局限,但它提供了一种零成本的第一道过滤。对于维护者来说,在人工审查之前先用工具筛掉明显问题,可以显著降低认知负担。npx slopsieve owner/repo#123这种即用方式,几乎不增加任何采用成本。
这类工具的长期价值可能不在于规则本身,而在于推动社区对"什么构成高质量diff"形成共识标准。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。