Slowave:让编程Agent自主维护记忆的本地化记忆层
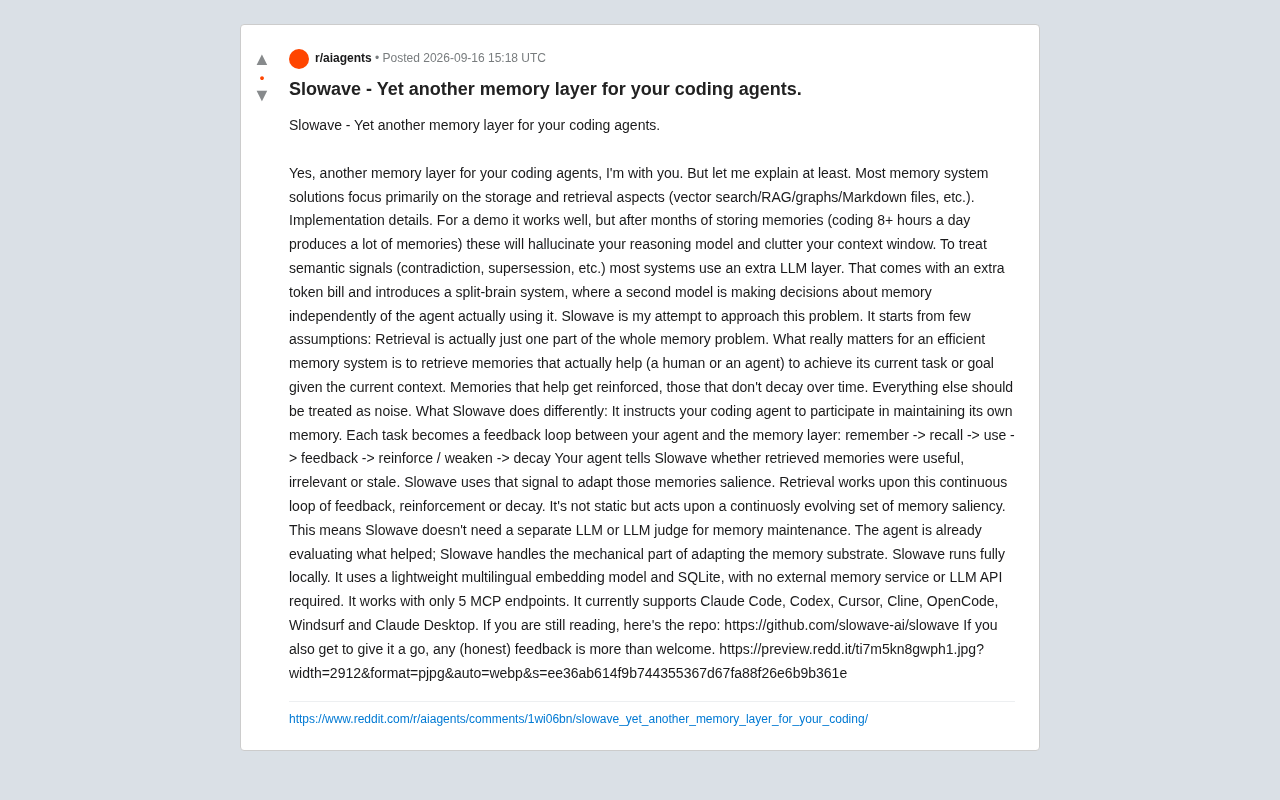
Slowave让编程Agent通过反馈闭环自主维护记忆,以强化与衰减机制替代独立LLM裁判。
Slowave是一个面向编程Agent的开源本地记忆层,针对现有方案在长期高强度使用下暴露的两大痛点而设计:庞杂历史记忆污染上下文、以及独立LLM"裁判"带来的Token浪费与决策脱节。其核心创新在于将记忆维护权交还给Agent本身:每次任务结束后,Agent向Slowave反馈哪些记忆有用、无关或已过时,系统据此调整每条记忆的"显著性"分值,有用的记忆被强化,长期无用的记忆随时间衰减消亡。整个系统完全本地运行,依托轻量多语言嵌入模型与SQLite,仅通过5个MCP端点对外工作,无需任何外部API,支持Claude Code、Cursor、Cline等主流AI编程工具。
又一个编程Agent记忆层,但思路不同
开源工具Slowave的作者在Reddit上坦率地开场:"是的,又是一个给编程Agent用的记忆层,我懂你的疑虑。"在RAG、向量检索、知识图谱、Markdown文件满天飞的今天,市面上并不缺记忆方案。但Slowave想解决的,是这些方案在长期高强度使用下暴露出的真实痛点。
作者指出,大多数记忆系统把精力放在存储与检索这一层——用什么向量库、怎么做RAG、图结构如何组织,这些本质上都是实现细节。对于Demo演示它们表现良好,可一旦你每天编码8小时以上、连续积累数月的记忆,问题就来了:庞杂的历史记忆会污染上下文窗口,甚至让推理模型产生幻觉。
传统记忆系统的"分裂大脑"问题
为了处理记忆之间的语义信号——比如矛盾(contradiction)、覆盖更新(supersession)——多数系统会引入额外的一层LLM来做判断。这带来两个代价:
其一是额外的Token开销,每次维护记忆都要多花一次模型调用的钱。其二更微妙,作者称之为"分裂大脑"(split-brain)系统:一个独立的模型在替你判断哪些记忆该保留、该更新,而它与真正在执行任务的Agent之间是脱节的。做记忆决策的模型,并不了解使用记忆的Agent当下真正需要什么。
这个观察相当有洞察力——记忆的价值本就该由"使用者"来定义,而非旁观的第三方。
RAG(检索增强生成)是目前最主流的记忆实现路径:将历史对话、代码片段等信息向量化后存入数据库,在每次推理前检索最相关的片段注入上下文。向量检索依赖嵌入模型将文本转化为高维数值向量,通过计算余弦相似度找到语义接近的记忆条目。知识图谱方案则进一步用节点和边来表达记忆之间的关系,例如"函数A依赖库B"。这些方案的共同缺陷是:它们只解决了"找得到"的问题,却没有回答"找到的是否真的有用"。随着记忆条目数量增长到数千乃至数万条,噪声条目大量混入检索结果,上下文窗口被无关历史填满,反而干扰模型对当前任务的判断。引入独立LLM做"记忆裁判"是一种补救,但这个裁判本身并不参与实际编码任务,无法从第一手的任务执行经验中判断哪条记忆真正有价值。
Slowave的核心假设:检索只是一半问题
Slowave从几个假设出发重新思考记忆系统。最关键的一点是:检索只是整个记忆问题的一部分。
真正重要的,不是能否检索到相关记忆,而是能否检索到真正有助于当前任务和目标的记忆。基于这个理念,Slowave引入了一套类似生物记忆的机制:
- 帮上忙的记忆会被强化(reinforce)
- 没帮上忙的记忆随时间衰减(decay)
- 其余一切都被当作噪声处理
这种"用进废退"的设计,让记忆库不再是只增不减的仓库,而是一个动态演化的活体系统。
让Agent参与维护自己的记忆
Slowave最与众不同的设计,是让编程Agent参与维护自己的记忆。每个任务都构成一个Agent与记忆层之间的反馈闭环:
记住 → 回忆 → 使用 → 反馈 → 强化/削弱 → 衰减
(remember → recall → use → feedback → reinforce/weaken → decay)
具体来说,Agent会告诉Slowave:这次检索到的记忆是有用的、无关的,还是过时的。Slowave根据这个信号调整对应记忆的"显著性"(salience)。检索建立在这个持续的反馈—强化—衰减循环之上,因此它不是静态的,而是作用于一个不断演化的记忆显著性集合。
这样设计的直接好处是:不再需要单独的LLM或LLM裁判来维护记忆。既然Agent本来就在评估哪些记忆帮上了忙,Slowave只需负责"机械"部分——把这些信号转化为对记忆底层的调整,从而避免了前面提到的Token浪费和分裂大脑问题。
完全本地运行,轻量且隐私友好
在工程实现上,Slowave强调完全本地运行:
- 使用轻量级的多语言嵌入模型
- 数据存储在 SQLite
- 无需任何外部记忆服务或LLM API
对于关注数据隐私、不希望代码记忆流向第三方服务的开发者,这是一个务实的选择。整个系统仅通过 5个MCP端点工作,接入门槛不高。
目前Slowave支持的客户端阵容相当齐全,覆盖了主流的AI编程工具:Claude Code、Codex、Cursor、Cline、OpenCode、Windsurf 以及 Claude Desktop。项目已在GitHub开源(slowave-ai/slowave),作者也诚恳地邀请使用者提供真实反馈。
MCP(Model Context Protocol)是Anthropic推出的一套开放协议,旨在标准化AI模型与外部工具、数据源之间的交互接口。它类似于USB接口的理念——只要工具实现了MCP规范,任何兼容的AI客户端都可以直接调用,无需为每个客户端单独开发集成代码。Slowave仅暴露5个MCP端点(对应remember、recall、feedback等核心操作),意味着整个记忆层对外的接口极为精简,客户端侧几乎不需要额外配置。SQLite作为存储后端的选择也体现了同样的轻量哲学:它是一个无服务器的嵌入式数据库,以单文件形式存在于本地磁盘,不需要独立的数据库进程,启动和读写开销极小,非常适合个人开发者的本地工具场景。
简评:记忆系统的一次范式尝试
Slowave的价值不在于它用了什么新的向量库,而在于它对"记忆系统该由谁来维护"这一问题给出了不同答案。把记忆的价值判断权交还给真正使用记忆的Agent,通过强化与衰减模拟生物记忆的自然筛选,这一思路确实避开了独立LLM裁判带来的成本与脱节。
当然,这类设计能否在实际长期使用中稳定生效,还需要更多开发者的实测验证——尤其是Agent自我评估记忆有用性的准确度,以及衰减机制是否会误删真正重要但暂时用不上的记忆。对于每天与编程Agent长时间协作的开发者来说,这是一个值得关注并动手尝试的开源方案。
相关推荐
百行代码从0手写一个Agent:拆解OpenClaw神话的极简实现
用不到200行代码从0手写一个Agent,拆解OpenClaw、Hermes等智能体的本质。涵盖大模型调用、while循环、history记忆、系统提示词、工具调用与Skill渐进式披露六大核心步骤,附AI应用开发学习路线参考。
4个顶级AI从零打造角斗士游戏:多智能体协作的实战拆解
一位创作者用Fable 5、Opus 5、GPT、GROK四个AI模型协同,从零打造角斗士游戏。本文拆解多智能体协作、独立评审循环、Trippo 3D生成等工作流,以及AI骗过评审的真实失败案例。
AI Agent零基础入门:从大模型认知到智能体开发全景图
AI Agent零基础入门教程:从人工智能、机器学习、深度学习到Transformer与大模型的技术脉络,再到提示词、RAG、MCP、LangChain等Agent开发四阶段学习路线,帮助你系统掌握智能体开发核心技能。