SmallCoder实测:零API成本的本地AI编程智能体

SmallCoder是专为本地小模型优化的开源编程智能体,通过计划机制和压缩优化解决上下文窗口瓶颈。
SmallCoder 是一款专为本地开源模型设计的编程智能体工具,填补了 Claude Code 等主流工具忽视本地小模型场景的空白。其核心针对的问题是:现有工具系统提示词过重(约34,000 Token),在128K窗口的本地模型上开销过大;且配置繁琐,无法自动识别 Ollama/LM Studio 上的模型。SmallCoder 通过精简系统提示词、优化工具集、引入任务计划机制(在每次上下文压缩后让智能体重新查阅待办清单以保持方向感),显著提升了本地小模型的实际可用性。工具支持终端与网页两种界面、三级权限控制,推荐搭配 Qwen3 模型使用,复杂项目建议采用「大模型规划、小模型执行」的分工策略。
为什么现有工具不适合本地模型
在编程智能体领域,Claude Code、OpenCode、DeepSeek广告 Harness 等工具已经相当成熟,但它们有一个被长期忽视的问题——几乎都是为云端旗舰模型设计的,并没有针对免费的本地开源模型做优化。
这个矛盾在上下文窗口上体现得最明显。像 Qwen3 这类开放权重模型,即使硬件允许,上下文窗口也往往只有 128K 到 256K Token。而在 Claude Code 这类工具里跑本地模型时,工具本身在你还没输入任何指令前就已经占用了约 34,000 个 Token。如果你的整个上下文只有 128K,光是系统开销就吃掉了近四分之一的空间,这对小模型来说是致命的。
更现实的痛点是配置成本。想把本地模型塞进这些工具,往往需要大量技术设置。原作者的诉求很朴素:开一个新对话、勾选模型,工具就应该自动检测机器上通过 Ollama 或 LM Studio 部署的所有模型,无需额外配置,开箱即用。SmallCoder 就是在这个需求下诞生的——开源、免费,并且从系统提示词、工具集到压缩机制,全部围绕本地模型重新优化。
上下文窗口(Context Window)是指模型在单次推理中能够同时处理的最大 Token 数量,包括输入的提示词、历史对话、工具输出以及模型生成的内容。Token 并非直接等同于字符或单词,中文通常每个字对应 1-2 个 Token,英文单词则大致 1 个单词对应 1-1.5 个 Token。当累计内容超出窗口上限时,工具通常会触发「压缩」操作——丢弃或摘要较早的对话内容——这可能导致模型「遗忘」任务背景,进而产生错误或重复劳动。系统提示词(System Prompt)是在正式对话开始前注入的指令集,用于定义模型的角色、可用工具清单和行为规则,通常由工具框架自动填充,用户不可见。Claude Code 等工具为支持丰富功能而配置了庞大的系统提示词,这在上下文空间本就有限的本地小模型上会造成显著的资源浪费。
安装与模型准备
SmallCoder 的安装几乎没有门槛。打开终端(PowerShell 也可以),运行一行命令即可:
npm install -g smallcoder@latest
加上 @latest 标签是为了确保始终安装最新版本。
真正需要准备的是本地模型。目前有两个主流选择:Ollama 和 LM Studio。以 Ollama 为例,访问官网下载对应操作系统的安装包,安装后即可浏览大量可选模型。
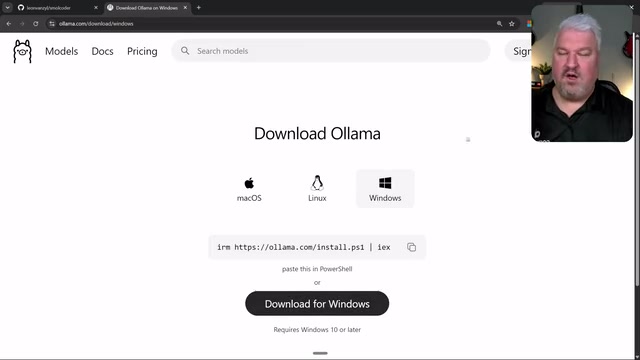
作者推荐 Qwen3 作为编程任务的免费模型首选——模型本身约 18GB,需要大约 16GB 显存(Mac 上则是统一内存)。下载只需运行 ollama pull 模型名,再用 ollama run 模型名 验证是否正常工作。首次加载会稍慢,因为模型要载入内存,之后发送一条消息就能看到推理过程和响应。
这里有个容易被忽略的细节:Ollama 会根据机器的 VRAM 使用情况动态分配上下文窗口。所以即便模型标称支持 256K,实际可用可能只有 131K——录屏软件等后台程序占用显存时,这个数字还会进一步缩水。
两种使用方式:终端与网页视图
SmallCoder 提供终端和网页两种界面。终端模式下,建议在具体项目文件夹里打开,运行 small 命令即可进入界面。通过 /model 选择模型时,它会自动检测 Ollama 和 LM Studio 上运行的模型,无论是跑在 Docker 容器还是直接运行在本机都能识别。
权限控制是值得关注的设计。按住 Shift 再按 Tab 可以在三种模式间切换:只读模式下智能体只能读取文件;编辑模式下可以改文件但运行命令需经许可;绕过模式(bypass)下则可自由改文件和执行命令。这种分级权限对本地自动化场景很实用。
网页版用 small --web 启动,会生成一个独立 URL。
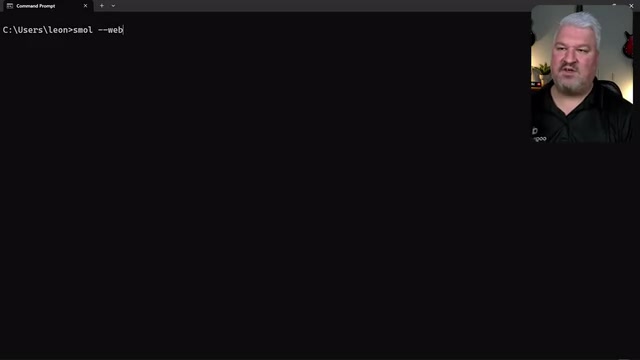
体验上和 Claude Desktop、ChatGPT 应用非常相似,左侧边栏能看到所有项目和会话。网页视图还能实时查看上下文窗口占用——作者演示时显示约 1% 用量,窗口大小 131,000 Token,并可随时调整模型和推理强度(effort)。
Ollama 和 LM Studio 都通过在本地启动兼容 OpenAI API 格式的 HTTP 服务来暴露模型能力——Ollama 默认监听 http://localhost:11434,LM Studio 默认监听 http://localhost:1234。SmallCoder 正是通过自动探测这两个端口来实现「无需配置即可识别本地模型」的体验。Docker 容器场景下,端口映射规则不变,因此同样可以被识别。这种基于标准 API 协议的设计也意味着,理论上任何兼容 OpenAI 接口的本地推理后端(如 llama.cpp 的服务模式、vLLM 等)都可以接入,只需将服务地址指向对应端口即可。
核心优化:计划机制与压缩后不迷路
SmallCoder 最值得称道的是它针对小模型上下文有限这一先天短板做的工程优化。
智能体启动任务时会生成一份计划(plan),这点和 Claude Code 类似,但 SmallCoder 的计划承担了额外职责。由于本地模型上下文窗口小,压缩会频繁触发;每次压缩后,智能体会重新查看这份计划,确认已完成的任务并勾掉,再明确下一步要做什么。这个「待办清单」机制让智能体在反复压缩后仍能保持正轨,不会因为上下文被截断而失忆。
作者用一个多人井字棋游戏做了首次测试——指令只是「创建一个在浏览器里运行的多人井字棋游戏」。
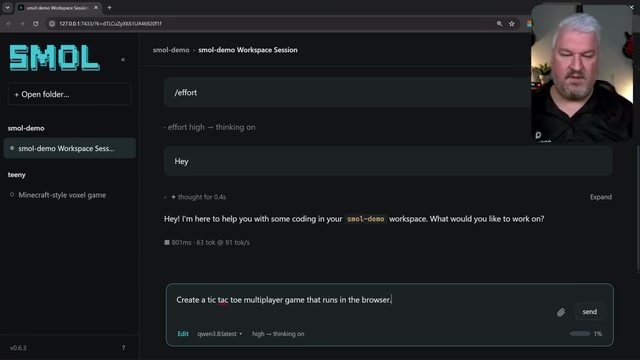
智能体很快完成了代码,并在获得编辑模式许可后启动了开发服务器。由于 SmallCoder 没有内置浏览器引擎但提供了内置浏览器视图,作者直接把本地 URL 粘进去就看到了可运行的游戏,整个过程快得「优化得太离谱」。
上下文压缩(Context Compression)是编程智能体在长任务中维持连续性的关键机制。常见的压缩策略包括:直接截断最早的对话轮次、用小模型对历史内容生成摘要后替换原始文本,或仅保留工具调用的输入输出而丢弃中间推理过程。压缩不可避免地会造成信息损失,尤其危险的是丢失「已尝试过什么方案」「当前处于哪个子任务」等状态信息,导致模型在压缩后走回头路或重复出错。SmallCoder 的计划机制本质上是一种外部状态持久化——将任务进度写入一份独立文档而非完全依赖对话历史,使得压缩后模型仍可通过读取计划文件快速恢复上下文,而无需在有限的 Token 空间中保留完整的历史对话。
复杂项目的正确打开方式
小模型做局部改动没问题,但从零规划一个复杂项目往往力不从心。作者给出的经验法则很务实:用一个更聪明的模型(哪怕是免费版的 ChatGPT)做初始规划,生成清晰的规格说明,再把规格交给本地小模型去执行。
他以一个 Minecraft 克隆项目(Voxel Mini)演示了这套流程:先让大模型生成一份使用 HTML/CSS/JavaScript、基于 Three.js、包含基础 AI 动物和简单合成系统的规格,再把规格完整粘贴进 SmallCoder。
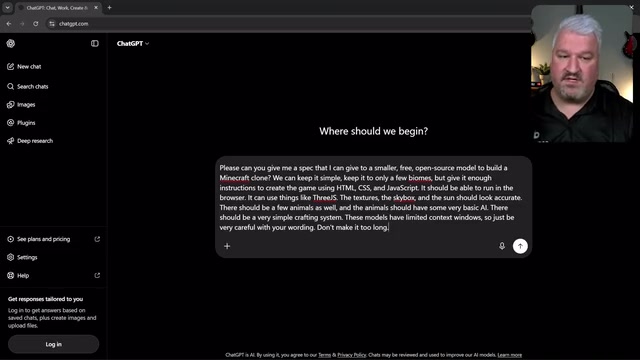
关键点在于措辞——小模型上下文有限,规格必须清晰但不能冗长。整个构建过程持续了约 20 分钟且全程无中断。作者特别强调,用过本地模型的人都知道它们容易崩溃、需要人工「唤醒」,而 SmallCoder 能保证智能体一直工作到完成,无需重启或多次催促。
完成后游戏出现纹理缺失的 bug。作者的解决方式颇具参考价值:截图记录问题,直接把截图拖进 SmallCoder 并说明缺陷。这里需要注意,视觉功能依赖模型本身支持——Qwen3 同时支持视觉、工具调用和思考标签,因此只要确保所用模型具备工具、视觉能力即可。刷新后纹理问题修复,整个世界、动物和基础交互都正常运行。
小结
对于希望完全本地、离线、零 API 成本运行编程智能体的开发者,SmallCoder 填补了一个真实存在的空白。它的价值不在于让本地模型变得像 Claude 一样强——作者也坦承小模型永远达不到旗舰模型的水平——而在于通过系统提示、工具集、压缩与计划机制的针对性优化,把本地小模型的实际可用性拉到了一个值得一试的水平。「大模型规划 + 小模型执行」的分工策略,配合反复迭代截图纠错,是在本地环境里压榨这些模型潜力的现实路径。
相关推荐
走进Anthropic分子生物学实验室:Claude如何成为科研协作者
Anthropic公开其分子生物学实验室,展示Claude如何作为科研协作者辅助蛋白质研究。本文解读AI在充满不确定性的生物学中扮演的角色,以及AI for Science趋势下的理性期待。
AI数据中心为何如此耗电?从GPU发热到核电站的能源困局
AI数据中心为何如此耗电?本文解析服务器机房运作、GPU散热难题、集成光子学节能方案,以及到2028年美国数据中心用电或相当于八个纽约市的能源困局与破局思路。
规范驱动开发:用Spec管住AI编程助手的失控
DeepLearning.AI与JetBrains合作的规范驱动开发(SDD)课程详解:如何用宪法与功能开发循环掌控AI编程助手,消除上下文衰减、降低认知债,覆盖绿地与棕地项目,并用技能、SpecKit、ACP等标准自动化工作流。