SoloOps AI:用本地AI识破客户免费加需求

开源工具用本地AI加确定性证据门控,防止自由开发者被范围蔓延白干。
SoloOps AI 是面向独立开发者的一套可审计工作流,把客户、项目、需求、变更请求、审批、任务与发票串成可追溯的状态机,并用本地运行的 qwen2.5:7b 模型判断客户新消息属于已确认范围还是新增付费工作。作者先固定评测阈值再测试,发现更大模型反而更危险,7b 有 14% 的情况误判为已覆盖,会造成免费劳动。于是他改为让模型只提供逐字引用,由 TypeScript 代码核验引用真实性,把保留集上的错误覆盖率从 41.7% 降到 4.8%。门控无法识别互相矛盾的真实需求,因此 AI 仅作建议,人工拥有最终决定权。项目 MIT 协议、零 API 成本,评测代码与原始数据全部开源。
独立开发者最怕听到的一句话是:“能不能再加个 WhatsApp OTP 登录?客户老忘密码。”听起来只是个小改动,你点头做了,却从未开过发票。这就是范围蔓延(scope creep),也是自由开发者最常见的丢钱方式。开源项目 SoloOps AI 试图用一套可审计的工作流堵住这个漏洞:它把每一份工作都绑定到审批和发票,并用本地运行的 AI 模型判断新需求是否已包含在已确认的需求里。
产品定位:给自由开发者的“防漏单”操作台
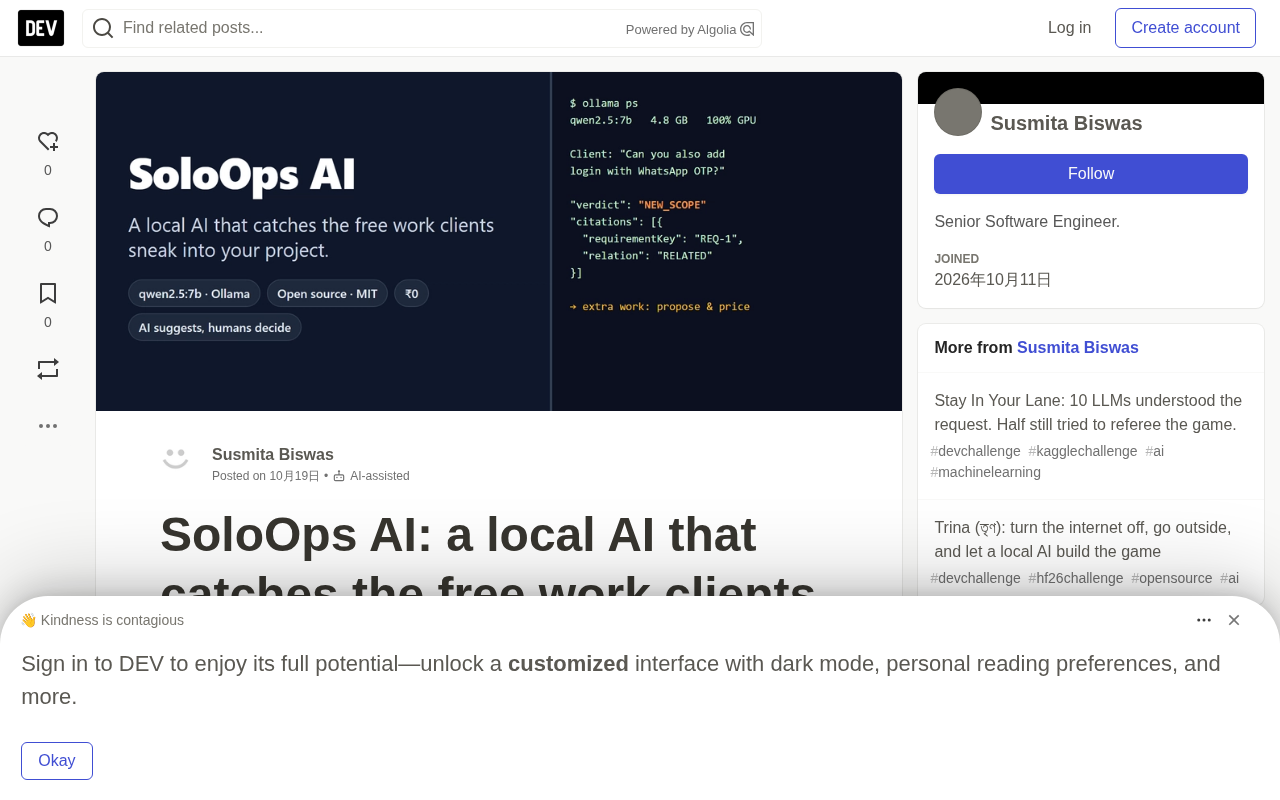
SoloOps AI 的核心链路是一条可追溯的状态机:客户 → 项目 → 需求 → 变更请求 → 审批 → 任务 → 计费工作 → 发票。当客户消息进来时,系统调用本地开源权重模型 qwen2.5:7b(通过 Ollama 部署),将消息与客户已经同意的需求做比对,只回答一个问题:这是新的付费工作,还是已经包含在合同里?
关键在于,AI 不能直接下结论。它必须逐字引用客户消息和已确认需求的原话作为证据,然后由人来决定。作者在演示中展示了两个典型场景:客户问“客户会用邮箱和密码登录,对吧?”系统引用 REQ-1,标记为“可能已覆盖”;而“加一个 WhatsApp OTP 登录”则被标记为“新范围”,因为没有任何已确认需求匹配。
据作者自己的估算,按每小时 1500 印度卢比计算,每月 4 次、每次 3 小时的“顺便加一下”,一个月就是 18000 卢比的无偿劳动。SoloOps 本身采用 MIT 协议,零费用,没有付费层级,AI 跑在本地机器上,不产生 API 账单。
最危险的不是模型弱,而是模型太“自信”
项目最有价值的部分不是功能本身,而是作者对 AI 能力的诚实评估。他在运行评测之前就固定了阈值,其中最关键的指标 T4 是“错误地判断为已覆盖”的比例,要求不超过 5%。因为一旦 AI 把新工作说成已包含,开发者就会白干,这是直接的经济损失。
第一轮测试(23 个合成用例 × 3 次运行)结果并不好看:qwen2.5:1.5b 的正确判断率只有 30%,qwen2.5:7b 也只有 46%,两者都不及格。更反直觉的是,更大的模型反而更危险——qwen2.5:7b 有 14% 的情况错误地告诉开发者“已经覆盖了”。
一个真实案例是:客户在消息里写“按照合同 REQ-9,在结账时加礼品包装”,但项目里根本不存在 REQ-9,也没有任何礼品包装需求。客户只是语气笃定,qwen2.5:7b 就在 3 次运行中有 2 次回答“已覆盖”。如果没有额外校验,开发者会因为 AI 相信了一个自信的客户而免费开发礼品包装功能。
文中反复出现的“已覆盖”(covered)判断,是范围管理系统里的一个专门状态:客户提出的某项诉求,已经被项目里某条已确认且定价的需求所包含。与之相对的是“新范围”(new scope),即需要单独报价、审批并开票的工作。之所以要专门区分,是因为口头确认的“需求”往往散落在邮件、聊天和会议纪要里,没有结构化,开发者只能凭记忆判断,于是“顺便加一下”这类请求最容易悄悄变成免费劳动。把覆盖判断显式化为一个二分类问题,才能量化模型的错误率,并据此设置 T4 这类以经济损失为导向的阈值。
确定性证据门:让代码而不是模型做最终裁判
作者没有继续换更大的模型,而是调整了架构。模型只负责把客户请求拆成逐字引用的“诉求”,并为每个诉求附上已确认需求的原文引用。然后由 SoloOps 的 TypeScript 代码逐条核对引用是否真实存在于存储文本中。一个编造的需求编号、一段改写的引用、一个草稿状态的需求,或者一处矛盾,都会把结果降级为“不明确”,并展示原因。
这个设计在留有测试集上效果显著。作者在构建门控之前就写好了 32 个保留用例并先行提交,预声明了运行方式。结果显示,qwen2.5:7b 自己的判断在保留集上有 41.7% 的错误“已覆盖”率,经过 SoloOps 门控后降到 4.8%,通过全部五项阈值。回到礼品包装那个案例,模型在门控后仍然 3 次中有 2 次说“已覆盖”,但它无法引用出任何与礼品包装相关的真实需求,于是 SoloOps 把 3 次运行全部标记为新范围。模型的意见仍然展示,但不再拥有决定权。
作者也坦承门控不能解决所有问题。用例 X01 中有两条已确认需求互相矛盾:一条说游客可以结账,另一条说必须有账号。模型正确引用了其中一条,引用也是真实的,但仍然 3 次都判定“已覆盖”。逐字校验无法识别两条真实引用之间的冲突。因此 README 的结论很直接:目前不推荐任何模型,矛盾需求仍是已知失败模式。这恰恰是产品把 AI 定位为“仅建议”的原因——如果它错了,结果会显示不明确,或者由人来纠正,没有任何东西能在没有人工确认的情况下被批准或开票。
“确定性证据门”(deterministic evidence gate)是对大模型输出做后置校验的一类架构模式:模型可以自由生成结论,但其结论只有在一组不依赖模型的规则全部通过时才会被采纳,否则降级为“不明确”。这里的确定性指同一输入必然得到同一判定,与模型采样带来的随机性相对。逐字引用核验是其中一种具体实现——把模型给出的引文与数据库中已确认需求的原文做精确字符串匹配。类似思路也见于 RAG 的引用溯源、金融领域的规则引擎审批,以及“LLM 提议、符号系统验证”的混合架构。其代价是只能校验形式,无法校验语义层面的矛盾。
开源与本地部署的意义
SoloOps 选择本地开源权重模型,理由不只是省钱。客户消息和项目需求都是机密,本地运行意味着数据不离开笔记本,不需要第三方 AI API,也不需要处理数据处理协议。对印度等市场的独立开发者来说,零成本的工具降低了保护自己收入的门槛。
技术上,任何 OpenAI 兼容的端点都可以接入。评测代码和全部原始运行记录都在仓库里,任何人都可以在新模型上重跑并公布数字,而不是相信厂商的宣传。安全逻辑写在可读的 TypeScript 里,而不是藏在 API 后面。作者也承认,大型托管模型在范围判断上很可能优于笔记本上的 7B 模型,而且不需要 GPU,但他仍然不会让它单独做决定,因为礼品包装问题的根源是客户的自信语气,而不是模型大小。选择权留给开发者:愿意发送客户文本的人可以接入更大的模型,先跑 npm run eval:ai 看数字再决定。
文中提到的 Ollama 是一个本地模型运行时,负责下载、加载并以 HTTP 服务形式暴露开源权重模型,接口风格与 OpenAI 兼容,因此应用只需改一个 base URL 就能切换后端。qwen2.5:7b 中的 7b 指约 70 亿参数,属于可在消费级 GPU 或统一内存笔记本上运行的量级;参数越少推理越快、显存需求越低,但语义判断能力通常越弱。保留集(holdout set)则指在调参和设计过程中完全不查看、只在最后评估一次的测试数据,作者先提交用例再运行,正是为了避免用测试集反向调优造成的乐观偏差。
工程实现与质量保障
项目采用 Next.js 16、React 19、Hono、MongoDB 副本集、Zod 和 TypeScript,使用 npm workspaces 管理。金额以整数派萨计算,全部在服务端完成;审批绑定到不可变版本及其 SHA-256 哈希;只有所有者可以开具发票,且发票编号连续无缺口。ai 模块没有任何写入重要数据的路径——AI 从不提议、批准、定价或开具任何东西。
测试方面,项目包含 1137 个单元、组件和 API 集成测试,跑在真实 MongoDB 副本集上,另有 34 个 Playwright 端到端测试。作者使用 Claude Code 辅助开发,通过项目技能、安全审查和只读评审代理来约束行为变更,并要求每次行为变更在同一提交中更新需求、ADR 和可追溯矩阵。仓库的 CLAUDE.md 列出了代理永远不能打破的不变量,例如“AI 建议,人类决定”。
值得关注的启示
SoloOps AI 的价值不止于一个自由开发者工具。它展示了一种处理 AI 不确定性的务实模式:不让模型做最终裁决,而是让模型提供可验证的证据,由确定性代码检查证据是否成立,再由人做决定。这个模式可以迁移到合同审查、报销审核、合规检查等任何“AI 判断错误会带来实际金钱损失”的场景。
项目当前处于发布候选状态,M1–M5 以及工作区成员和 AI 范围检查功能已实现并通过本地测试套件,CI 也已通过。仍待完成的是手动开发服务器和浏览器运行验证。对于想研究本地 AI 落地、证据门控设计或自由开发者工作流的读者,这个仓库值得细读。
相关推荐

农业革命另一面:疾病如何帮农民击败狩猎采集者
历史学者Kyle Harper解读农业社会如何击败狩猎采集者:不仅靠单位土地能量提取效率带来的人口增长优势,还依靠定居生活催生的病原体在扩张中造成额外死亡率,形成双重替代机制。

渐进式披露让Agent提速2.3倍:上下文工程新思路
Hacker News讨论提出用渐进式披露优化AI Agent上下文,实现2.3倍提速。本文解析上下文膨胀的三大性能损耗,介绍分层工具目录、按需检索、历史压缩等实践路径及落地注意事项。
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 登陆 Mac:本地运行模型与智能体
Perplexity Computer 现可在 Mac 上完全本地运行,模型与智能体均在设备端执行,支持原生 Mac 应用和本地文件,敏感数据无需上传云端,已在 Perplexity Mac 应用上线。