Sonar-MoE:反向传播中更新专家,省下20%显存

Sonar-MoE 在反向传播中即时更新专家并释放梯度,省显存约两成且提速。
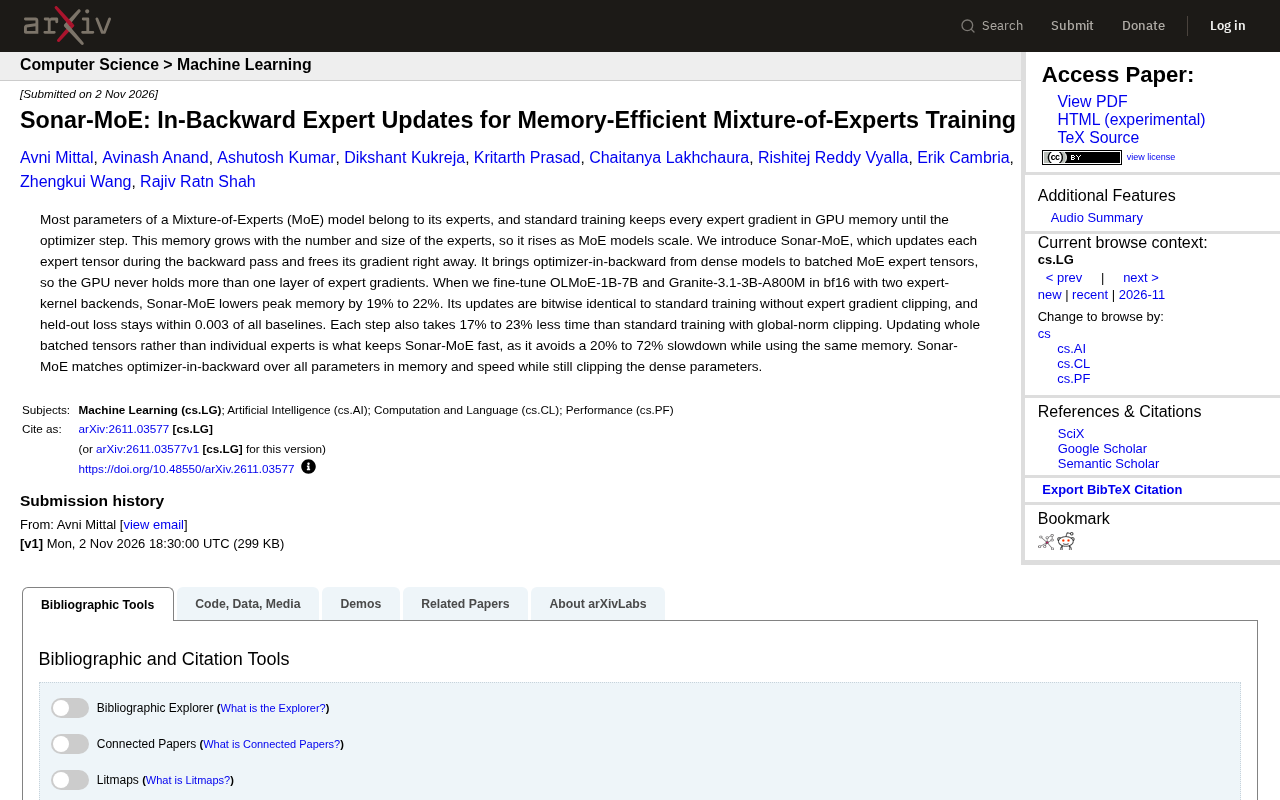
Sonar-MoE 针对 MoE 训练中专家参数梯度常驻 GPU 导致的显存瓶颈,提出将 optimizer-in-backward 策略迁移到批量化的专家张量上:每算完一个专家张量的梯度就立即更新并释放,GPU 上最多只保留一层专家梯度。在 OLMoE-1B-7B 和 Granite-3.1-3B-A800M 上,峰值显存降低 19%-22%,且无专家梯度裁剪时更新与标准训练逐位一致,留出集损失差距在 0.003 以内。速度反而比带全局范数裁剪的标准训练快 17%-23%。论文还指出逐个专家更新会导致 20%-72% 的减速且不省更多显存,因此批量更新是保速度的关键;稠密参数仍保留常规裁剪流程,兼顾了训练稳定性。
训练混合专家(MoE)模型时,显存瓶颈往往不在注意力层,而在专家参数上。标准做法要把所有专家的梯度囤在GPU里,等反向传播结束才统一更新,专家越多、越大,这块显存就越吓人。最近一篇关于 Sonar-MoE 的工作提出了一种更省显存的思路:在反向传播过程中直接更新专家张量,更新完立刻释放梯度。
显存省在哪:把优化器搬进反向传播
MoE 模型的大部分参数集中在专家网络中,而标准训练会为每个专家保留完整的梯度副本,直到优化器步骤才释放。这意味着显存占用随专家数量和单个专家尺寸线性增长。
Sonar-MoE 的核心做法是把“在反向传播中更新”(optimizer-in-backward)从稠密模型迁移到批量化的 MoE 专家张量上。每计算完一个专家张量的梯度,就立即执行更新并释放该梯度,GPU 上最多只保留一层专家的梯度。这种逐层释放的策略,把峰值显存压了下来。
混合专家(MoE)模型的核心结构是将传统 Transformer 中的单个前馈网络(FFN)替换为多个并行的“专家”网络,并通过一个轻量的路由器(router)为每个 token 选择激活其中少数几个专家。以 OLMoE-1B-7B 为例,模型总参数量约 70 亿,但每个 token 只激活约 10 亿参数,因此推理和训练的计算量接近一个小模型,而容量却接近一个大模型。代价在于显存:所有专家的参数、梯度、优化器状态都必须常驻 GPU,即使每次前向只用到其中一部分。专家数量越多、单个专家越宽,这部分开销就越显著,这也正是 MoE 训练显存瓶颈集中在专家侧而非注意力侧的原因。
**optimizer-in-backward(反向传播中更新)**是一种将参数更新提前到反向传播阶段执行的训练策略。标准训练流程是:前向计算损失,反向逐层计算梯度并全部保留,待整个反向传播结束后再由优化器统一执行一次参数更新。optimizer-in-backward 则反其道而行:某一层(或某个张量)的梯度一旦算完,就立即用优化器更新对应参数,然后立刻释放这份梯度,不必等到整个反向传播结束。由于优化器状态(如 Adam 的一阶、二阶矩)本身仍需常驻,省下的是梯度副本这块显存。该思路此前多用于稠密模型,Sonar-MoE 将其扩展到批量化的 MoE 专家张量上,使“算完即更新、更新即释放”的流水线适用于专家参数。
实测数据:显存降两成,速度不降反升
研究者在两个模型上验证了 Sonar-MoE 的效果:OLMoE-1B-7B 和 Granite-3.1-3B-A800M,均使用 bf16 精度,并搭配两种专家核后端。
结果显示,峰值显存降低了 19% 到 22%。这个幅度不算激进,但对于显存吃紧的 MoE 微调场景,已经足以让原本跑不动的配置变得可行。
更关键的是正确性:在没有专家梯度裁剪的情况下,Sonar-MoE 的更新与标准训练逐位一致(bitwise identical),留出集损失与所有基线的差距保持在 0.003 以内。也就是说,省显存没有以牺牲模型质量为代价。
速度方面,每个训练步比带全局范数裁剪的标准训练还快了 17% 到 23%。这有些反直觉——通常省显存的方案会拖慢训练,但 Sonar-MoE 因为提前释放梯度、减少了显存搬运和峰值压力,反而在时间上占了便宜。
**“逐位一致”(bitwise identical)**指两次训练在相同输入、相同随机种子下产生的参数更新和中间结果在二进制层面完全相同,而不仅仅是数值接近。在浮点训练中,运算顺序的改变、归约方式的不同都可能引入微小误差,因此能做到逐位一致,说明 Sonar-MoE 的反向传播内更新在数学上等价于标准训练,只是执行时机和内存释放策略不同。文中“在没有专家梯度裁剪的情况下逐位一致”,提示当引入梯度裁剪时,由于裁剪依赖全局梯度范数、需要跨张量聚合信息,逐位一致性不再成立,但留出集损失差距仍控制在 0.003 以内,说明实际影响可忽略。
为什么不是逐个专家更新
一个自然的疑问是:既然要省显存,为什么不干脆每个专家单独更新、单独释放?
论文给出了明确答案:逐个专家更新会导致 20% 到 72% 的减速,而显存占用并没有比批量更新更低。Sonar-MoE 选择更新整个批量张量,正是为了保住速度。这个设计取舍说明,在 MoE 训练里,“批量”本身就是性能的关键,拆得太细反而得不偿失。
与全参数 optimizer-in-backward 的对比
Sonar-MoE 只对专家参数做反向传播内更新,稠密参数仍然保留常规的梯度裁剪流程。实验表明,它在显存和速度上与“对所有参数做 optimizer-in-backward”的方案持平,同时还能对稠密参数正常执行裁剪。这意味着它没有为了省显存而放弃训练稳定性所需的手段。
对于需要在有限GPU上微调大MoE模型的研究者和工程团队,这类“在反向传播中即时更新”的思路提供了一个不改变模型结构、不牺牲收敛质量的显存优化选项。随着 MoE 架构在大模型中的普及,训练侧的显存效率问题会越来越受关注,Sonar-MoE 的做法值得纳入工具箱。
**全局范数裁剪(global norm clipping)**是训练大模型时常用的稳定性手段:先计算所有参数梯度的全局 L2 范数,若超过预设阈值,则将所有梯度按同一比例缩放,从而限制单步更新的幅度、防止梯度爆炸。它的一个关键约束是必须在所有梯度都算完之后才能执行,因为需要先聚合出全局范数。这与“算完即释放”的 optimizer-in-backward 存在天然冲突。Sonar-MoE 的折中在于:只对专家参数做反向内更新(专家侧不做裁剪),而稠密参数仍保留完整的梯度收集与全局范数裁剪流程,从而在不放弃训练稳定手段的前提下,仍拿到了大部分显存收益。
相关推荐
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。