Spark-X2.6-1.7B 发布:端侧智能体模型支持百万级上下文
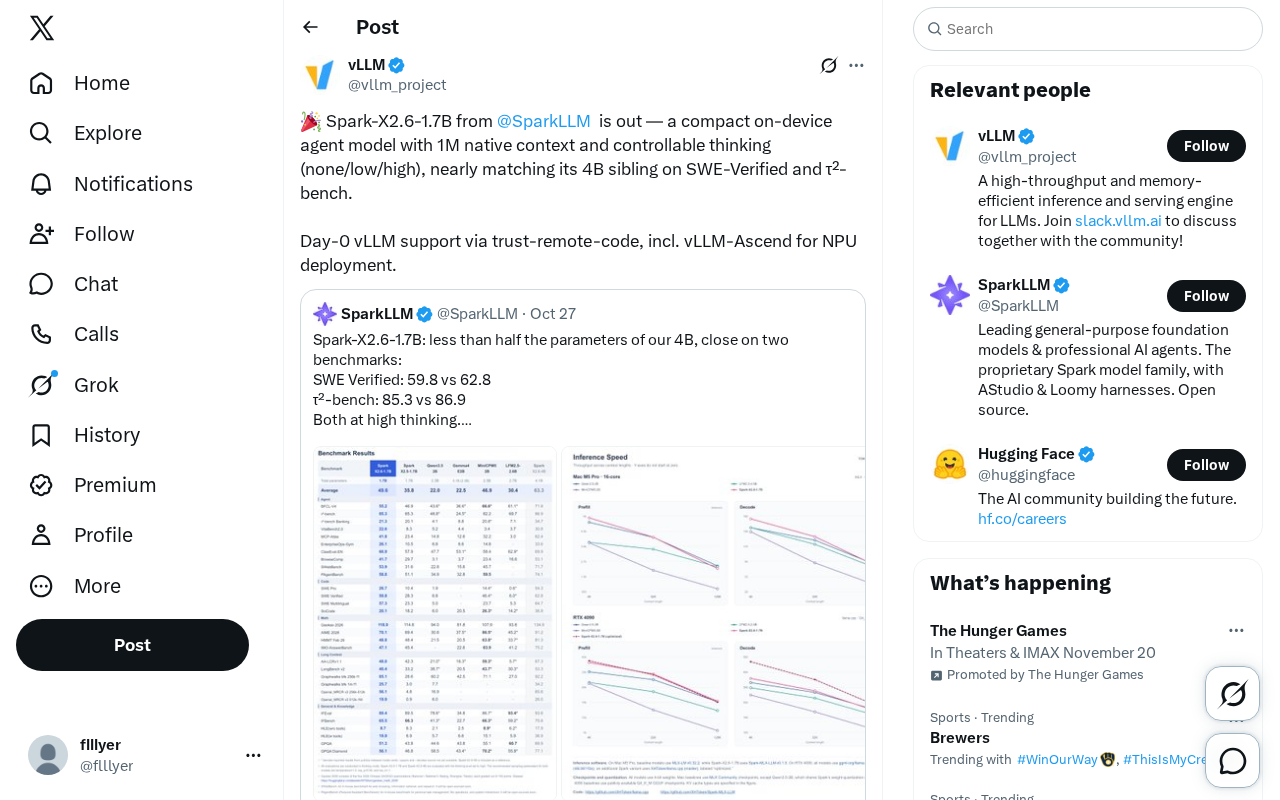
SparkLLM 发布 1.7B 端侧智能体模型,支持 1M 上下文与可控思考。
SparkLLM 推出专为端侧设计的紧凑型智能体模型 Spark-X2.6-1.7B,核心亮点是原生支持 1M 上下文长度与 none/low/high 三档可控思考模式,可根据任务复杂度动态分配推理算力。官方称其在 SWE-Verified 和 τ²-bench 上几乎追平 4B 同门模型。该模型发布首日即获 vLLM 支持(通过 trust-remote-code 加载),并兼容 vLLM-Ascend,可部署于 NPU 平台。文章认为其组合在端侧赛道具有差异化,但也指出官方尚未公布详细基准分数、内存占用与延迟等关键指标,1M 上下文的实际有效利用率仍待社区验证。
端侧智能体新选择:Spark-X2.6-1.7B 亮相
知名模型系列 SparkLLM 近日推出了全新成员 Spark-X2.6-1.7B。这是一款专为端侧设备设计的紧凑型智能体模型,最大的亮点在于原生支持 1M(百万级)上下文长度,并且具备可控思考能力。据官方推特账号 @SparkLLM 发布的信息,该模型在 SWE-Verified 和 τ²-bench 两项基准测试中,表现几乎追平了其 4B 参数的同门兄弟。
对于端侧部署而言,1.7B 的参数量意味着模型可以较为轻松地运行在手机、平板或边缘计算设备上,而 1M 上下文的支持则让智能体能够处理长文档、多轮复杂任务或大规模代码库分析,这在以往通常需要云端大模型才能实现。
SWE-Verified 与 τ²-bench 是什么
SWE-Verified 是 SWE-bench 的筛选子集,专门评估模型在真实 GitHub 仓库中定位缺陷、修改代码并让测试通过的能力,被视为衡量代码智能体实用性的重要标尺。τ²-bench 则聚焦工具调用与多轮交互下的推理,考察模型能否在模拟的客服、业务系统中遵循约束、正确调用 API 并完成用户目标。两者共同强调“多步执行 + 环境反馈”,与传统单轮问答基准差异明显,因此常被用来判断模型是否具备真正的智能体能力。
可控思考模式:按需分配算力
Spark-X2.6-1.7B 引入了“可控思考”机制,允许用户在三种模式间切换:none(无思考)、low(低强度思考)和 high(高强度思考)。这种设计让模型能够根据任务复杂度动态调整推理深度。对于简单的指令跟随或信息查询,可以关闭思考以降低延迟;而对于需要多步推理的编程或规划任务,则可以开启高强度思考来提升准确性。
这种灵活性在端侧场景中尤为实用——用户不必为简单任务付出不必要的算力代价,同时在复杂任务上也能获得接近更大模型的推理能力。官方宣称该模型在 SWE-Verified(软件工程任务)和 τ²-bench(工具使用与推理)上几乎匹配 4B 版本的表现,说明其思考机制有效地弥补了参数量的差距。
部署友好:Day-0 支持 vLLM 与 NPU
Spark-X2.6-1.7B 在发布首日即获得 vLLM 支持,通过 trust-remote-code 方式即可加载。更值得关注的是,它同时支持 vLLM-Ascend,这意味着模型可以部署在基于 NPU 的硬件平台上,为端侧和边缘计算设备提供了更多选择。
对于开发者而言,Day-0 的推理框架支持大幅降低了尝试门槛。vLLM 作为当前主流的高效推理引擎,其生态的快速适配有助于模型在真实场景中快速落地。而 NPU 的支持则进一步拓宽了硬件兼容性,尤其适合对功耗和成本敏感的端侧设备。
vLLM、trust-remote-code 与 vLLM-Ascend
vLLM 是当前主流的高吞吐推理引擎,核心是 PagedAttention 与连续批处理,能显著提升长上下文场景下的显存利用率和并发效率。trust-remote-code 是 Hugging Face transformers 的一个加载选项,允许执行模型仓库中自带的建模代码,从而支持尚未合入主干的新架构;代价是需信任模型来源。vLLM-Ascend 则是 vLLM 面向华为昇腾 NPU 的后端适配,使模型可在非 GPU 的国产加速卡上运行,这对功耗敏感、供应链多元化的端侧与边缘部署具有实际意义。
端侧智能体的竞争新变量
将 1M 上下文、可控思考与 1.7B 的紧凑尺寸结合在一起,Spark-X2.6-1.7B 在端侧智能体赛道中形成了一个有差异化的组合。当前端侧模型往往在上下文长度或推理能力上做出妥协,而 SparkLLM 试图证明小模型也能拥有长上下文和可调节的推理深度。
不过,需要客观看待的是,官方目前仅给出了“几乎匹配 4B 兄弟”的定性描述,尚未公布详细的基准测试分数和实际端侧运行时的内存占用、延迟等关键指标。这些数据对于评估模型在真实设备上的可用性至关重要。此外,1M 上下文在 1.7B 模型上的实际有效利用率(如长文档中的信息检索精度)也有待社区验证。
无论如何,Spark-X2.6-1.7B 的发布为端侧 AI 应用提供了新的可能性,尤其是对于需要处理长上下文且对隐私和离线运行有要求的场景,值得开发者保持关注。
长上下文的“有效利用率”为何重要
原生支持 1M 上下文只说明模型在架构与位置编码上能接受如此长的输入,并不等于它能在其中稳定检索信息。业界常用“大海捞针”(Needle-in-a-Haystack)等测试衡量长上下文的有效利用率:把关键信息埋在长文本不同位置,考察模型能否准确召回。小参数模型在极长上下文下往往出现注意力稀释、中段信息丢失等问题。因此,评估 1.7B 模型的 1M 上下文时,除标称长度外,还应关注检索精度随长度衰减的曲线以及实际显存/内存占用。
相关推荐
Ollama本地部署指南:零基础跑通开源大模型
Ollama本地部署教程:介绍Ollama是什么、为什么选择它,以及如何下载安装、运行开源大模型,并利用API进行个性化开发,适合零基础用户。
n8n:GitHub 187K星的开源自动化神器,把重复工作变工作流
n8n 是一款 GitHub 187K 星的开源可视化工作流自动化引擎,支持 400+ 节点、Webhook/定时/轮询触发,可自托管保障数据安全,还能接入 AI Agent 打造 AI 工作流。本文介绍其核心概念、典型场景与避坑指南。
n8n自托管实战:Docker+PostgreSQL+Caddy部署指南
手把手教你用 Docker Compose 部署 n8n 自托管实例,搭配 PostgreSQL 和 Caddy 自动 HTTPS,含环境变量避坑、网站巡检飞书告警流程、备份升级回滚要点。