UniEvo-VL:自蒸馏训练如何让多模态模型自我进化

UniEvo-VL 探索用自蒸馏训练让多模态模型自我迭代进化,以计算换取昂贵的图文标注数据。
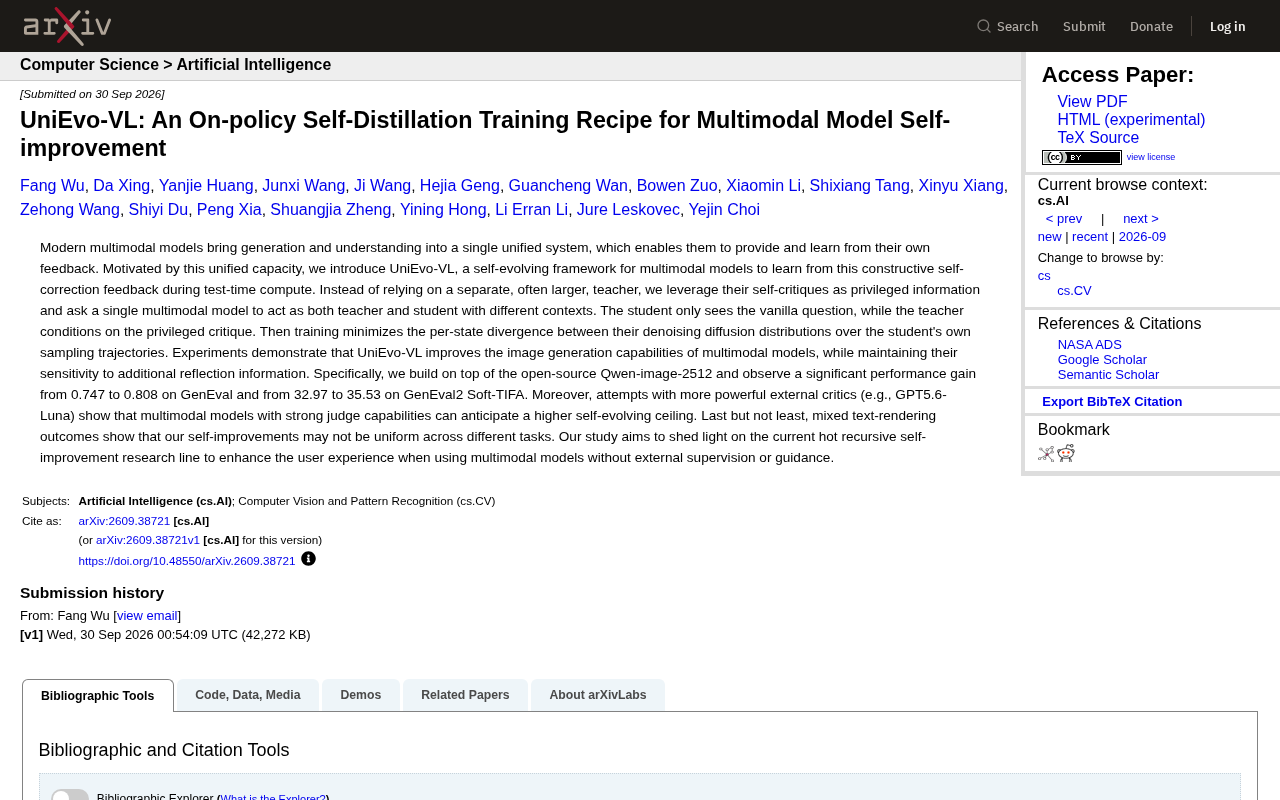
UniEvo-VL 是一个尚处于早期披露阶段的视觉语言模型项目,其核心思路是通过自蒸馏(Self-Distillation)训练使模型实现自我改进,从而降低对高成本人工标注图文数据的依赖。自蒸馏的关键机制包括:对同一输入在不同增强下施加输出一致性约束、用模型自身高置信度输出生成伪标签、以及利用 EMA 权重平滑版本作为稳定的教师信号。多模态领域的数据标注成本尤为高昂,使这条"用计算换数据"的路径具有现实吸引力。但该方案也面临错误累积、提升饱和等公认风险,如何可靠地筛选自监督信号是决定其能否成立的关键。目前项目公开信息有限,技术价值有待完整论文与基准测试验证。
当多模态模型开始"自我教学"
在大型视觉语言模型(VLM)的训练链条中,高质量标注数据始终是最昂贵的瓶颈。一个名为 UniEvo-VL 的项目提出了一条新思路:让模型通过自蒸馏(Self-Distillation)训练实现自我改进,减少对外部监督信号的依赖。
需要说明的是,该项目目前仅在 Hacker News 上以简短条目的形式出现,公开信息非常有限,尚未附带完整的技术论文或评测数据。本文基于其核心命题展开,对自蒸馏训练这一技术路线进行背景解读,而非对 UniEvo-VL 本身的完整评测。
自蒸馏训练到底在做什么
传统的知识蒸馏(Knowledge Distillation)通常需要一个更大、更强的"教师模型"来指导"学生模型"。而自蒸馏的核心区别在于:教师和学生可以是同一个模型,或是模型自身在不同训练阶段、不同视角下产生的输出。
核心机制
在多模态场景中,自蒸馏往往采用以下几种做法:
- 输出一致性约束:让模型对同一图文输入在不同增强(裁剪、遮挡、改写)下保持一致的预测,从而提升鲁棒性。
- 自生成伪标签:模型先对无标注数据生成答案,再将高置信度的输出作为训练目标反馈给自身。
- 跨阶段蒸馏:用模型早期或经过平滑(如 EMA 权重)的版本作为教师,稳定训练过程。
这种方式的吸引力在于,它绕开了对海量人工标注的依赖,理论上能够在模型已有能力的基础上"滚雪球"式地提升性能。
EMA(指数移动平均,Exponential Moving Average)权重平滑是跨阶段蒸馏中的常见技术手段。其原理是将教师模型的参数设为学生模型历史权重的加权平均,而非直接复制某一时刻的快照。这种做法能有效抑制训练噪声,使教师模型输出更加稳定。DINO、MoCo v3 等自监督视觉表征学习方法均大量采用了 EMA 教师机制,并在实践中证明了其对防止训练崩塌的显著作用。在多模态场景下,由于图文对齐本身引入了额外的不确定性,稳定的教师信号尤为重要,EMA 机制因此成为自蒸馏框架中不可或缺的设计选择。
为什么多模态模型需要这条路
视觉语言模型的训练数据不仅要有图像,还要有与之对齐的文本描述或问答对。相比纯文本数据,高质量的图文配对数据获取成本更高,噪声也更大。
自我改进式训练之所以在多模态领域受到关注,原因有三:
- 数据扩展成本高:人工标注图文对的边际成本居高不下,自蒸馏提供了一种用计算换数据的替代方案。
- 模型能力已有积累:当基础模型足够强时,其自生成的高置信度输出本身就具备一定的教学价值。
- 缓解模态对齐难题:通过一致性约束,模型可以在不引入新标注的情况下强化图文之间的语义对齐。
不过,这条路径也存在公认的风险——如果模型自身的错误被反复强化,可能导致"错误累积"甚至性能崩塌。如何筛选可信的自监督信号,是这类方法能否成立的关键。
错误累积(Error Accumulation)问题在自监督与半监督学习领域有系统性研究积累。当模型将自身生成的错误预测当作训练目标时,这些错误会在迭代中被不断放大,最终导致模型性能持续下滑,即所谓的"模型崩塌"(Model Collapse)。大型语言模型领域的研究(如 2024 年 Nature 上的相关论文)已表明,反复用模型自身输出进行微调会系统性地丢失原始数据分布的尾部信息。应对这一风险的常见策略包括:设置置信度阈值过滤低质量伪标签、混入一定比例的真实标注数据作为锚点,以及引入奖励模型或验证器对自生成内容进行二次筛选。这也是判断 UniEvo-VL 技术方案是否成熟的核心观察维度之一。
技术路线的潜力与局限
自我改进(Self-Improvement)已经成为大模型领域的热门方向,从语言模型的自我博弈、自我奖励,到如今向多模态的延伸,背后是同一个诉求:减少对外部监督的依赖,让模型具备持续进化的能力。
UniEvo-VL 把"自蒸馏"与"自我改进"结合在视觉语言模型上,命名本身(Uni + Evo,统一 + 进化)也暗示了其设计目标——构建一个能够自主演进的统一多模态框架。
但从目前公开的信息看,仍有几个关键问题有待验证:
- 自蒸馏带来的提升是否可持续,还是会在若干轮迭代后饱和?
- 相比直接扩充高质量数据,计算成本是否真的更划算?
- 在复杂推理类多模态任务上,自生成信号的质量能否支撑起训练?
这些问题的答案,需要等待项目公开更完整的技术细节和基准测试结果。
自我改进在纯语言模型领域已有若干具体实现可供参照。DeepMind 的 Self-Play Fine-Tuning(SPIN)让模型区分自身生成文本与人类文本,从而持续提升输出质量;Meta 的 Self-Rewarding Language Models 则让模型同时承担生成与评判两个角色,通过自我打分的奖励信号进行迭代训练。这些方案的共同前提是:模型的判别能力(识别好坏)需要领先于其生成能力,否则自我评判本身就缺乏可靠性。向多模态迁移时,这一前提更难满足——视觉理解的评判标准远比文本流畅度更难形式化,这也是 UniEvo-VL 所面临的深层挑战。
结语:一个值得跟踪的方向
尽管当前素材有限,UniEvo-VL 所代表的自蒸馏自我改进路线,确实切中了多模态模型发展的核心痛点。对于关注前沿研究的从业者而言,这是一个值得持续跟踪的技术信号。真正的判断标准,仍要落在它公开的实验数据与可复现的代码之上。
相关推荐

Cursor AI编程工具保姆级教程:下载、模式与模型选择全解析
Cursor AI编程工具保姆级教程:从下载安装、界面布局到Agent/Ask/Manual三种模式解析,以及GPT、Claude大模型选择建议,帮你快速上手这款强大的AI代码编辑器。

Cursor Projects深度解读:云端代理会终结Claude Code吗
Cursor Projects通过云端代理解决上下文衰减问题,支持多代理并行、完整开发闭环和真实软件交付。本文解读其工作机制、实测观察,并分析它能否真正挑战Claude Code与ChatGPT Codex。

Cursor创始人深度对话:代码之死与"品味"的崛起
Cursor创始人Michael Truell深度对话:解析AI编程的真实瓶颈、"vibe coding"为何在专业开发中行不通,以及为什么"品味"将成为未来工程师唯一不可替代的能力。附AnySphere从CAD到90亿估值的创业历程。