Spec-Kit 实现阶段如何让 AI Agent 全自动跑完任务?

Spec-Kit 分阶段停顿源于小模型能力不足与保守客户端配置,并非框架缺陷
一位开发者在使用 GitHub Spec-Kit 规范驱动开发工具链时,发现 AI Agent 在执行 implement 阶段仍频繁停下询问是否继续下一 Phase,与预期的「全自动」执行相差甚远。文章分析指出,这一现象是本地 9B 级别小模型 agentic 能力有限、加上 opencode 客户端保守策略共同导致的结果,并非 Spec-Kit 的设计缺陷——分阶段确认本身是规范驱动开发的「安全检查点」设计。对比 Google Antigravity 能「一跑到底」的体验,核心差距在于云端强力模型与激进调度策略的组合。提升自主程度的有效路径包括升级模型、调整客户端自动批准配置,以及在 constitution 中显式声明连续执行意图,但根本解法仍是提升底层模型能力。
问题背景:Spec-Kit 流程为何会中途停下
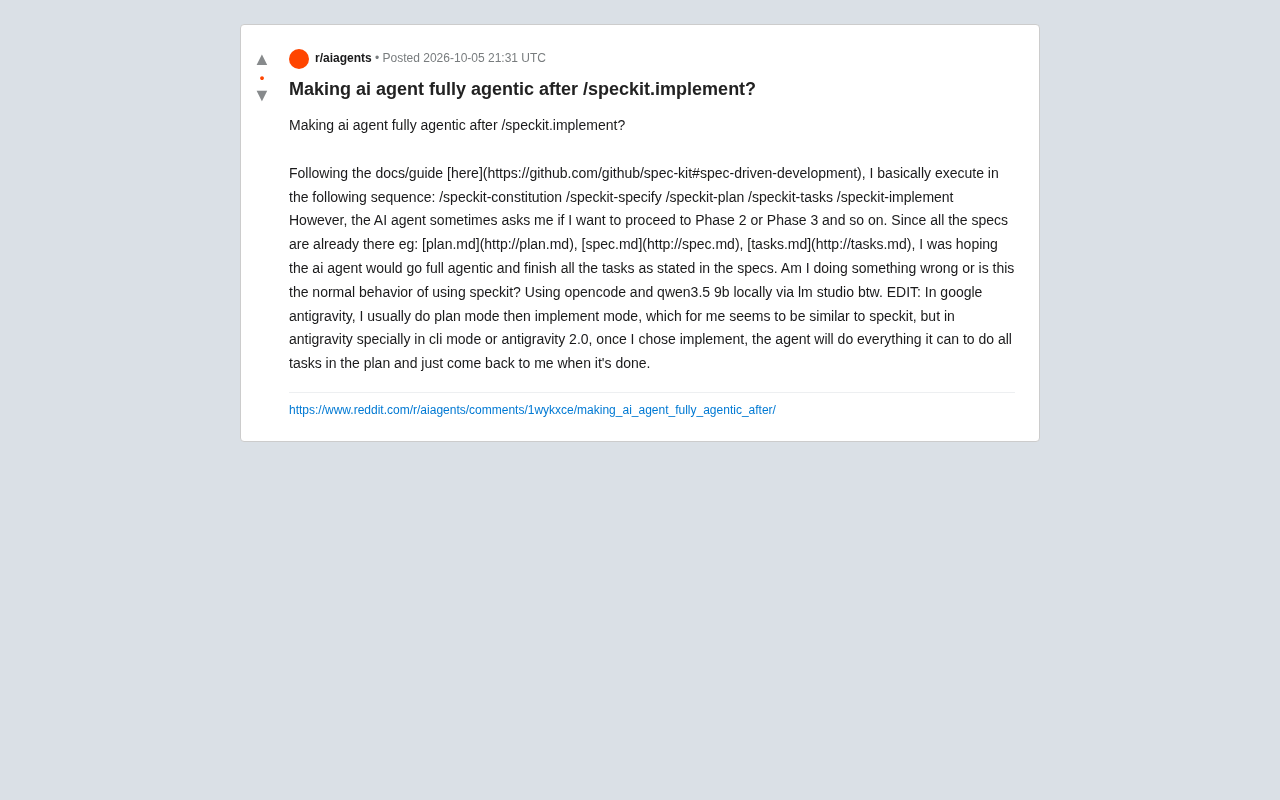
在使用 GitHub 的 Spec-Kit(规范驱动开发工具链)时,一位 Reddit 开发者遇到了一个常见的困惑:按照官方文档,他依次执行了 /speckit.constitution、/speckit.specify、/speckit.plan、/speckit.tasks、/speckit.implement 这一整套命令,理论上所有规范文件(spec.md、plan.md、tasks.md)都已生成完毕,AI Agent 应该可以「全自动」把任务清单一次性跑完。
但实际情况是,当执行到 implement 阶段时,AI Agent 仍然会不断停下来询问「是否要继续进入 Phase 2 / Phase 3」。这与他期望的「完全自主代理」(fully agentic)行为存在落差。该开发者的环境是:通过 LM Studio 在本地运行 Qwen 模型,搭配 opencode 作为客户端。
这是正常行为吗:规范驱动开发的「人机确认」设计
从 Spec-Kit 的设计哲学来看,这种分阶段确认并不完全是 bug,而更接近一种有意为之的「安全闸门」。规范驱动开发(Spec-Driven Development)的核心价值在于:先把需求、计划、任务拆解成人类可审阅的文档,再由 AI 按文档执行。阶段之间的停顿,本质上是给开发者一个「检查点」,确认上一阶段产出无误后再推进。
不过这位开发者的诉求也很合理——既然所有规范都已经落盘,为什么不能一口气执行到底?这里的关键变量其实有两个:
1. 模型本身的 Agent 能力
他使用的是本地部署的小参数量模型(帖子中提到 Qwen,约 9B 级别)。小模型在长链条、多步骤的自主任务执行上,往往缺乏足够的「坚持力」和上下文保持能力,更倾向于频繁回头向用户确认,而不是自信地连续执行多个 Phase。这不是 Spec-Kit 的问题,而是模型 agentic 能力的天花板。
所谓 "agentic 能力",指模型在无需人类逐步干预的情况下,自主规划、调用工具、执行多步骤任务并处理中间错误的综合能力。这一能力与模型参数规模、训练数据中的指令遵循样本、以及强化学习对齐方式密切相关。9B 级别的小模型受限于上下文窗口的有效利用率和多步推理的稳定性,在面对跨越多个「Phase」的长链任务时,容易出现「目标漂移」——即随着对话轮次增加,模型逐渐遗忘或弱化原始目标,转而以寻求人类确认来「规避风险」。相比之下,70B 以上的大参数模型或经过专门 agentic 微调的模型(如 Claude 系列、GPT-4o)在维持长任务连贯性上表现明显更好。因此,频繁的阶段确认往往不是提示词或工具的问题,而是模型自身置信度不足的外在表现。
2. 客户端/运行环境的代理策略
不同的 Agent 运行环境对「自主执行」的默认策略差异很大。opencode 搭配本地模型时,往往更保守。
对比参照:Antigravity 的「implement 模式」体验
帖子作者补充了一个很有价值的对比。他在 Google Antigravity 中的工作流是「plan 模式 → implement 模式」,这在结构上与 Spec-Kit 的 plan/implement 非常相似。但体验差异明显:
在 Antigravity 中,尤其是 CLI 模式或 Antigravity 2.0,一旦选择 implement 模式,Agent 就会竭尽所能完成计划中的所有任务,直到全部做完才回来找我。
这个对比揭示了一个重要结论:相同的「规范 → 实现」范式,最终的自主程度高度依赖底层 Agent 框架和模型的组合,而非范式本身。 Antigravity 之所以能「一跑到底」,很可能得益于更强的云端模型和更激进的自主执行调度策略。
Google Antigravity(现更名为 Jules)是 Google 推出的异步 AI 编程代理,与 GitHub Copilot Workspace 类似,其设计目标是在云端后台自主完成一个完整的编程任务——开发者提交任务后可以离开,等代理完成后再回来审查。这与 opencode + 本地模型的架构有根本差异:Antigravity 运行在 Google 的基础设施上,底层调用的是经过专门 agentic 优化的强力云端模型,调度系统也被设计为默认「跑完整个计划再汇报」,而非逐步确认。这种架构差异解释了为何同样是「plan → implement」范式,Antigravity 能做到「一跑到底」,而本地小模型驱动的工具链则倾向于保守的逐步确认策略。
如何让 Spec-Kit 更接近「全自动」
基于这个案例,想要在 Spec-Kit 中获得更连贯的自主执行体验,可以从几个方向着手:
- 升级模型:用能力更强的模型(无论是更大的本地模型还是云端 API)替换 9B 级别的小模型,agentic 行为通常会显著改善。小模型频繁确认,很大程度是「不自信」的表现。
- 调整运行环境配置:检查 opencode 或所用客户端是否有「自动批准」「连续执行」类的设置项,很多工具允许降低人工确认的频率。
- 在 prompt / constitution 中明确意图:在
/speckit.constitution或任务描述中显式声明「无需逐 Phase 确认,连续执行所有任务直至完成」,有时能引导 Agent 减少中途打断。 - 接受分阶段确认的合理性:对于重要项目,分阶段审阅其实能降低 AI 跑偏导致大规模返工的风险。追求「全自动」与保证「可控性」之间需要权衡。
在 /speckit.constitution 中明确意图的做法,本质上是通过系统级提示词(system prompt)来重新设定 Agent 的默认行为边界。Spec-Kit 的 constitution 文件相当于一份「项目宪法」,定义了 AI 在整个开发过程中应遵守的规则和行为准则。在其中加入类似「执行 implement 阶段时,无需在 Phase 之间寻求用户确认,除非遇到不可解决的歧义或阻塞性错误,否则连续推进所有任务直至全部完成」的指令,可以覆盖模型默认的保守策略。但需注意,这类覆写指令对能力较弱的小模型效果有限——模型可能在前几步遵守,随后随着上下文加深而「忘记」这条规则,这是小模型指令遵循能力的固有局限。
小结
这位开发者遇到的「Agent 中途停下询问」现象,是本地小模型 + 保守客户端配置的组合结果,而非 Spec-Kit 的设计缺陷。规范驱动开发的分阶段确认本身有其价值。若想复刻 Antigravity 那种「选择 implement 后一跑到底」的体验,核心在于提升模型能力和调整运行环境的自主策略,而不是单纯修改命令序列。
对于正在探索 AI 辅助编程工作流的开发者来说,这个案例也提醒我们:工具范式趋同的当下,真正决定体验的往往是模型与 Agent 框架的底层能力。
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。