SpeCal:用隐藏状态谱校准无监督RLVR奖励

SpeCal 用隐藏状态谱从组级和 rollout 级双层校准无监督 RLVR 的优势值。
无监督 RLVR 让模型从自身多次采样中推导奖励,从而绕开标准答案,但自生成监督的可靠性在组间和组内差异很大,仅看解码结果与奖励统计难以判断学习结构是否可靠。论文提出 SpeCal,转而利用隐藏状态谱这一互补视角:组级将谱质量与作用于有效秩的高斯带通门结合,筛选表示变化充分且有效维度处于偏好区间的采样组;rollout 级在留一谱子空间中测量每个回答的条件支撑度,主导方向数由组有效秩决定。两层信号最终用于校准原始奖励诱导的优势值,而不重新定义无标签奖励,因而易于与现有流程结合,为挖掘无标签推理数据提供了一条轻量路径。
无监督强化学习可验证奖励(RLVR)让大模型在没有标准答案的情况下也能自我提升推理能力,但自生成奖励的可靠性参差不齐。一篇新论文提出 SpeCal,从隐藏状态谱中提取信号,对奖励优势进行双层校准,为无监督 RLVR 提供了一条不修改奖励定义、只修正学习信号的思路。
无监督 RLVR 的瓶颈:奖励从哪来,又是否可靠
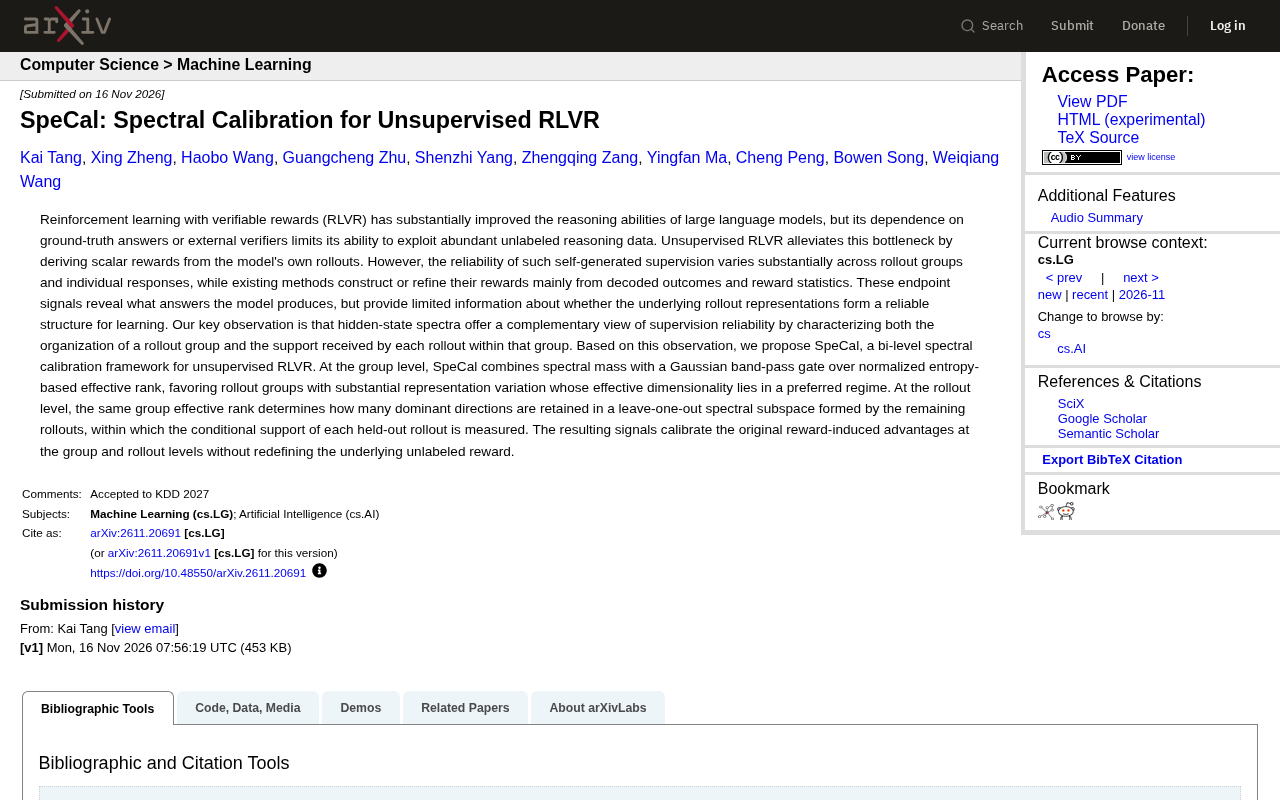
RLVR 通过可验证的奖励信号显著提升了大语言模型的推理表现,但它高度依赖标准答案或外部验证器,这让大量无标签推理数据无法被利用。无监督 RLVR 的思路是让模型从自己的多次采样(rollout)中推导标量奖励,从而绕开外部验证。
问题在于,这种自生成监督的可靠性在不同采样组之间、以及组内不同回答之间差异很大。现有方法主要从解码结果和奖励统计量出发来构造或精炼奖励——这些端点信号能告诉我们模型"答了什么",却很难说明模型内部的 rollout 表示是否形成了可靠的学习结构。
RLVR(Reinforcement Learning with Verifiable Rewards,可验证奖励强化学习) 是一类用可程序化验证的奖励信号(如数学题的最终答案匹配、代码的单元测试通过)来优化语言模型推理能力的训练范式。与传统 RLHF 依赖人类偏好模型不同,RLVR 的奖励是确定性的、可自动判定的,因此训练信号噪声更低、更易规模化。典型实现如 GRPO 等方法,对同一 prompt 采样多个回答,根据验证器给出的对错直接构造优势值,跳过价值网络。其局限也恰在此:每个样本都需要标准答案或可执行验证器,数学与代码之外的大量开放式推理数据无法直接使用,这正是无监督 RLVR 试图突破的边界。
核心观察:隐藏状态谱是另一重视角
论文的关键观察是:隐藏状态谱能够刻画一个 rollout 组的组织方式,以及组内每个 rollout 获得的支撑程度,从而为监督可靠性提供互补视角。换句话说,与其只看最终答案对不对,不如看模型在生成过程中形成的表示结构是否"站得住脚"。
这构成了 SpeCal 的设计基础——一个面向无监督 RLVR 的双层谱校准框架。
隐藏状态谱(hidden-state spectrum) 指对一组 rollout 在某一层(或若干层)的隐藏状态矩阵做奇异值分解(SVD)后得到的奇异值分布。矩阵的每一行对应一个 rollout 的表示向量,奇异值大小反映该组表示在多少个正交方向上有显著变化,奇异值谱的衰减速度则刻画表示是否集中在少数主导方向上。有效秩(effective rank) 是这一谱的标量概括,通常由归一化奇异值的信息熵取指数得到:值接近总维度说明表示分散、多样;值很低则说明表示高度共线、采样缺乏结构差异。相比奖励分数这种单点标量,谱统计量携带了组内表示几何的整体信息,因而能作为奖励可靠性的独立旁证。
组级校准:谱质量与高斯带通门
在组级别,SpeCal 将谱质量与一个高斯带通门结合,后者作用于基于归一化熵的有效秩。该机制倾向于选择那些表示变化充分、且有效维度落在偏好区间内的 rollout 组。
这一设计背后的直觉是:一个组如果表示变化太少,说明采样缺乏多样性;如果有效维度偏离合理区间,则可能意味着结构噪声过大。带通门的作用正是把组级可靠性约束在一个"甜点区"。
高斯带通门(Gaussian band-pass gate) 借自信号处理中的带通滤波思想:只让落在某个中心区间内的信号通过,过高或过低都被衰减。在这里,输入是组有效秩(经归一化熵换算),门函数以某个偏好中心 μ 和带宽 σ 构造高斯权重,有效秩过低的组(表示变化不足、采样冗余)和过高的组(结构噪声大、表示发散)都会被降权,只有落在"甜点区"的组获得接近 1 的门控系数。谱质量则是对奇异值谱整体形状的打分,用于衡量该组表示是否具有清晰的主导结构。二者相乘得到组级可靠性权重,再作用于该组的优势值,实现不改变奖励定义前提下的软筛选。
rollout 级校准:留一谱子空间中的条件支撑
在 rollout 级别,同一个组有效秩决定了在由其余 rollout 构成的留一谱子空间中保留多少个主导方向。每个被留出的 rollout 在该子空间内测量其条件支撑度。
这样做的意义在于:一个回答是否可靠,不只看它自身的奖励分数,还要看它相对于同组其他回答所形成的表示结构是否获得了足够支撑。两个层面得到的信号最终用于校准由原始奖励诱导的优势值,而不重新定义底层的无标签奖励。
留一谱子空间(leave-one-out spectral subspace) 是一种交叉验证式的几何构造:对某个 rollout 组,先剔除待评估的那一个 rollout,用其余 rollout 的隐藏状态做 SVD,取前 k 个右奇异向量张成一个子空间,k 由该组的有效秩决定。随后把被留出的 rollout 表示投影到该子空间,用投影能量占其总能量的比例(或投影残差)衡量它与同组其他样本共享结构的程度,即条件支撑度。支撑度高说明该回答的表示与组内主流结构一致,其奖励更可能可信;支撑度低则可能是表示离群或侥幸答对。留一设计避免了被评估样本自身抬高子空间、造成自我支撑的偏差。
不重定义奖励,只校准学习信号
SpeCal 的一个值得注意的设计选择是"校准而非替换"。它保留了原有的无监督奖励定义,只是在组级和 rollout 级对优势进行修正。这种解耦让方法更容易与现有无监督 RLVR 流程结合,也降低了引入新偏差的风险。
从更广的视角看,这项工作提示:自生成监督的可靠性问题,或许不必只在答案层面求解,模型内部表示的结构信息同样可以成为校准依据。对于希望挖掘无标签推理数据的团队,这提供了一条值得关注的轻量路径。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。