SQL Agent模式选择层实测:Opus竟输给Sonnet,投票机制零收益
schemagate 作者用 BIRD 与 Spider 2.0 实测 SQL Agent 选表层,发现四大反直觉结论。
开源项目 schemagate 的作者公布了其 SQL Agent 模式选择层在 BIRD 与 Spider 2.0 上的基准结果:BIRD dev 集执行准确率 77.1%,Spider 2.0-lite 的 SQLite 子集达 71.9%,而 BigQuery 子集仅 45.9%。测试揭示四个反直觉发现:更大的 Opus 在 Spider 2.0 上反而输给 Sonnet,说明模型选型必须基于自有数据实测;多候选投票加裁判在调参集上有约 +3 分提升,但在留出集上收益为零且成本高达 5.5 倍;BigQuery 的 366 张日期分片表会占满选表槽位导致模型拒答,折叠为通配符表可解决;外部基准还暴露出 WITH RECURSIVE 被误判为越权访问的真实 bug。作者强调先拆分数据再调参、用外部基准检验自家逻辑的评测纪律。
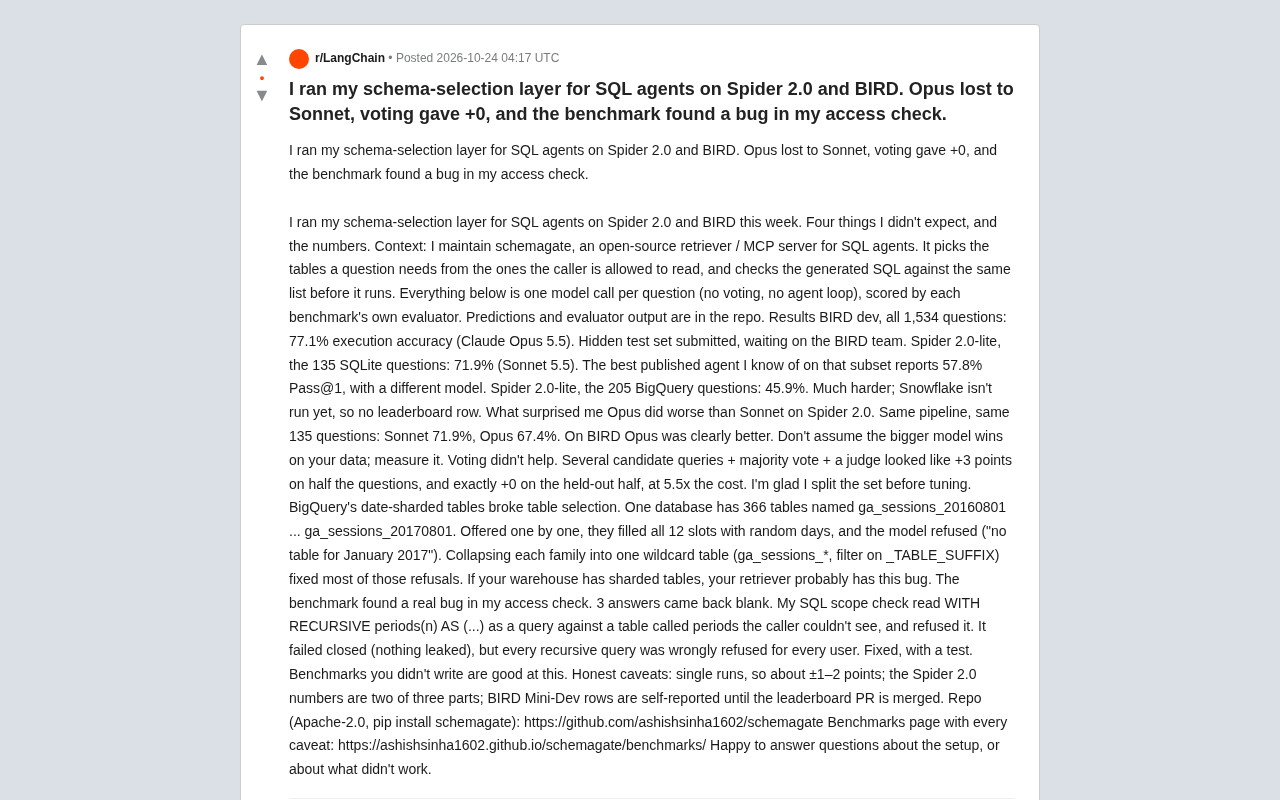
开源项目 schemagate 的作者在 Reddit 上分享了一组颇具反直觉意味的基准测试结果:他为自己开发的 SQL Agent 模式选择层在 BIRD 和 Spider 2.0 上跑分,发现更大的模型不一定更好,而看似稳妥的投票机制在留出集上收益为零。
schemagate 是一个面向 SQL Agent 的开源检索器与 MCP 服务器。它的职责很明确:从调用方有权读取的表集合中,挑出回答问题所需的表,并在生成的 SQL 执行前用同一份表清单做校验。换句话说,它同时承担"选表"和"权限守门"两个角色。作者强调,所有结果都是每题一次模型调用,没有投票,没有 Agent 循环,由各基准自带的评估器打分。
基准测试结果:数字与留白
BIRD dev 集全部 1534 道题上,Claude Opus 5.5 取得了 77.1% 的执行准确率;隐藏测试集已提交,正在等待 BIRD 团队的结果。Spider 2.0-lite 的 135 道 SQLite 题上,Sonnet 5.5 达到 71.9%——作者提到,他所知该子集上表现最好的公开 Agent 报告的是 57.8% Pass@1,且使用的是不同模型。而 205 道 BigQuery 题的正确率只有 45.9%,难度明显更高;Snowflake 部分尚未运行,因此还没有排行榜记录。
这些数字构成了一条清晰但陡峭的难度曲线:SQLite 上的表现可以接近实用,BigQuery 上则还有明显差距。作者也坦承了方法学上的局限:单次运行意味着约 ±1–2 分的波动,Spider 2.0 的数字只覆盖三个部分中的两个,BIRD Mini-Dev 的行在排行榜 PR 合并前属于自报数据。
BIRD(BIg Bench for LaRge-scale Database Grounded Text-to-SQL Evaluation)是当前 Text-to-SQL 领域最具影响力的公开基准之一,其 dev 集包含 1534 道跨多个数据库的自然语言问句,配套人工标注的 SQL 与执行结果,评估时通常以执行准确率(Execution Accuracy)为准,即生成的 SQL 在真实数据库上执行后结果与标准答案一致的比例。Spider 2.0 则是 Spider 系列的第二代,专门面向企业级真实数据仓库场景,覆盖 BigQuery、Snowflake、SQLite 等多种方言,题目更长、模式更复杂,被认为是比初代 Spider 显著更难的基准。BIRD 和 Spider 2.0 常被同时使用,正是因为前者偏学术标准库、后者偏生产环境方言,两者的分数不能直接横向比较。
反直觉发现一:Opus 在 Spider 2.0 上输给 Sonnet
同一套流水线、同样的 135 道题,Sonnet 拿到 71.9%,Opus 只有 67.4%。但在 BIRD 上,Opus 的表现明显更好。这种交叉结果直接打破了"模型越大越好"的默认假设。
作者的建议很直接:不要假设更大的模型会在你的数据上获胜,去测。这一现象背后可能的原因是,模式选择任务对模型的"指令遵循与格式稳定性"要求高于纯粹推理能力,不同模型在特定任务分布上的偏好差异会被放大。对正在选型的团队来说,这意味着模型选择必须以自己的数据分布为准,而非排行榜名次。
所谓“模式选择(schema selection / schema linking)”是 Text-to-SQL 流水线中的前置环节:数据库可能包含成百上千张表,而单次提示的上下文窗口和成本有限,必须先从全部表中检索出与问题相关的子集,再交给模型生成 SQL。这一环节的准确率直接决定后续上限——漏选表就必然答错,多选表则会挤占上下文并引入干扰。因此选表本质上是一个检索与排序任务,而非纯推理任务,对模型的指令遵循、输出格式稳定性、对长清单的注意力分配都更敏感。这也解释了为何不同模型在模式选择上的相对优势可能与它们在通用推理榜单上的排名不一致。
反直觉发现二:投票机制在留出集上收益为零
多候选查询加多数投票再加一个裁判模型的组合,在半数题目上看起来有约 +3 分的提升,但在留出的一半题目上收益恰好是 0,而成本是单次调用的 5.5 倍。
作者对此的庆幸值得记录:"我很高兴在调参之前就把数据集拆开了。"如果只看调参集,这个方案会被误判为有效。投票机制在 SQL 生成上的失效,提示了一个更普遍的问题——当多个候选的错误是相关的而非独立的,多数投票无法抵消偏差,只会放大成本。
自洽性投票(self-consistency)与多数投票是 LLM 推理中常用的提效手段:对同一问题采样多条推理路径或候选答案,取出现频率最高者,其理论前提是各条路径的错误相互独立,因而正确答案更可能被“投票选出”。但当候选由同一模型、同一提示、同一上下文生成时,错误往往高度相关——模型会系统性地在同一个环节出错,例如都误读了同一张表的含义,此时投票只会重复同一个错误。SQL 生成尤其如此,因为错误常源于对模式的理解偏差而非随机波动,这种偏差在多次采样中稳定复现,多数投票自然无法抵消。
反直觉发现三:BigQuery 的日期分片表击穿了选表逻辑
某个数据库里有 366 张名为 ga_sessions_20160801 到 ga_sessions_20170801 的表。逐张提供给模型时,它们占满了全部 12 个槽位,且是随机日期,模型直接拒绝回答:"没有 2017 年 1 月的表"。
解决方式是把每个表族折叠成一张通配符表(ga_sessions_*,通过 _TABLE_SUFFIX 过滤),大多数拒绝随即消失。作者提醒:如果你的数仓存在分片表,你的检索器很可能也有这个 bug。这是一个在真实生产环境中高频出现、却在基准测试中容易被忽略的陷阱。
日期分片表(date-sharded tables)是 BigQuery 等数仓中的常见模式:由于早期单表有大小与查询成本限制,按天或按月建表(如 ga_sessions_YYYYMMDD)成为惯例。这类表在元数据中表现为大量结构相同、仅名字不同的独立表,对检索器极不友好——它们会平铺在候选列表中互相挤占名额,且表名中的日期容易被模型当作语义信息解读。BigQuery 提供的通配符表语法(ga_sessions_* 配合伪列 _TABLE_SUFFIX 做过滤)可以把整个表族当作一张逻辑表查询,既减少元数据噪音,也降低扫描成本。检索器若不做表族识别与折叠,就会在分片表密集的库上系统性失效。
反直觉发现四:基准测试找出了权限校验的真实 bug
有 3 个答案返回空白。追查后发现,SQL 作用域检查把 WITH RECURSIVE periods(n) AS (...) 中的 periods 误读为一张调用方无权访问的表,于是拒绝执行。它失败时是关闭的(没有数据泄漏),但所有用户的每一条递归查询都被错误拒绝。该问题已修复并补上了测试。
作者的评价是:你没亲手写的基准测试,恰恰擅长发现这类问题。这条经验的普适性超出了 SQL 领域——权限校验的"失败即关闭"虽然安全,但静默拒绝会掩盖功能缺陷,需要专门的测试用例来暴露。
所有权衡之下,schemagate 以 Apache-2.0 协议开源,可通过 pip install schemagate 安装,基准测试页面列出了全部注意事项。对构建 SQL Agent 的团队而言,这组结果的真正价值不在分数本身,而在于它演示了一套可复用的评测纪律:先拆分数据再调参,用外部基准检验自家逻辑,以及对外部模型的默认优势保持怀疑。
相关推荐

OpenAI新模型Bel曝光:10万亿参数,或成AGI基座
Reddit爆料称OpenAI新模型Bel即将问世,总参数超10万亿,或作为GPT-6之后的基础模型甚至AGI门槛基座。本文拆解爆料关键信息并评估可信度。

Claude Fable 5/5.1报错事件:30分钟故障复盘
Claude Fable 5与Fable 5.1出现错误率升高的服务故障,官方状态页显示影响约35分钟,从Investigating到Resolved仅用37分钟。本文还原故障时间线,分析对其他Claude模型的波及范围,并给出开发者重试、多模型路由与监控告警的应对建议。
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1 开源权重模型深度实测:3万亿参数MoE架构、100万token上下文,3D渲染惊艳但空间推理与事实准确性存短板。基准逼近Opus 5.5,每任务成本仅2.11美元,开源前沿的真实水位全解析。