Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1以3万亿参数MoE架构逼近闭源旗舰,实测渲染惊艳但空间推理仍有短板。
月之暗面发布的 Kimi K3.1 Pro 以 2.8 万亿总参数、1040 亿激活参数的 MoE 架构和 100 万 token 上下文,成为开源权重模型中规模最大的选手之一,权重可下载自托管。科技博主 Matthew Berman 实测显示:3D 魔方渲染完整实现光影、控制与算法求解,堪称最佳之一;但 iPhone 建模形态失真、攀岩绳结任务彻底失败,暴露渲染质量与空间推理、事实准确性是两套能力。官方基准逼近 Opus 5.5(Terminal Bench 65.7 对 66.4,GDP Val 1846 对 1866 ELO),智能指数排名第四,每任务成本仅 2.11 美元,性价比突出。但实测体感与纸面分数存在落差,输出风格与 Claude 高度相似也引发蒸馏疑问。结论是:它是高性价比的开放权重选项,而非闭源旗舰的替代品。
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
月之暗面(Moonshot AI)发布的 Kimi K3.1 以 3 万亿总参数、1040 亿激活参数的 MoE 架构,成为开源权重模型领域迄今规模最大的选手之一。科技博主 Matthew Berman 在深度实测后给出了一个耐人寻味的判断:"它是一台很棒的模型,但离 Opus 5.5 和 GPT 6.1 Sol 还有距离"——而正是这种"接近但不等于"的定位,勾勒出开源模型当前的真实水位。
模型规格:开源阵营的参数怪兽
Kimi K3.1 Pro 的核心参数颇具冲击力:2.8 万亿总参数、1040 亿激活参数,采用混合专家(MoE)架构,意味着每次推理只调动一小部分参数。上下文窗口达到 100 万 token,原生支持多模态输入(图像已确认,视频与音频大概率支持)。官方博客强调其在完整项目级编码(Unreal、Unity、Godot 引擎游戏开发)、Blender 与 FreeCAD 参数化 3D 建模、以及金融建模任务上的能力提升,并声称幻觉率下降 65%。
真正让开源社区兴奋的是可获得性:模型权重可下载、可部署在自有数据中心、也可直接通过 Kimi 平台调用。在闭源模型持续拉高能力上限的背景下,一个接近前沿水平的开放权重选项,本身就有战略价值。
混合专家架构(MoE) 是一种将模型拆分为多个“专家”子网络、每次推理只激活其中一小部分的稀疏架构。总参数代表模型容量上限,激活参数则决定单次前向计算的实际开销。以 Kimi K3.1 为例,2.8 万亿总参数对应约 1040 亿激活参数,意味着推理时仅约 3.7% 的权重参与计算,从而在维持大容量知识存储的同时把算力成本压到与中型稠密模型相当的水平。MoE 的代价是显存占用高(需容纳全部专家)、路由策略设计复杂,且不同专家可能出现训练不均衡。这也是“总参数”与“激活参数”必须分开宣传的原因——两者衡量的是完全不同的东西。
实测表现:亮点与短板并存
3D 渲染:意外的高分项
Berman 用经典的"3D 魔方"测试开场,原本以为这个测试已经失去区分度,结果发现开源权重模型普遍无法通过——色块消失、旋转逻辑错乱、甚至突然自动复原。Kimi K3.1 不仅完整渲染出带光照反射的 3D 魔方,还实现了键盘控制、计时器、撤销重置、转速调节,以及一套真正基于算法(而非逆向回放)的自动求解流程,最终以彩带动画收尾。Berman 的评价是:"绝对通过,而且是最好的之一。"
这一表现与官方宣称的 3D 渲染能力吻合,也与 Opus 5.5、GPT 6.1 Sol 近期在 3D 建模上的进步形成有趣的"能力收敛"现象。相比之下,Meta 的 Muse Wonder Full 在此项明显偏弱,Meta AI 负责人 Alexander Wang 甚至公开承认"我们忘了把它做好 3D 建模"。
3D 建模精度:渲染好看,细节失真
在"用 WebGL 渲染 iPhone Duo"的任务中,Kimi 用了 28 分 45 秒完成,金属边缘反射、摄像头模组光泽都处理得不错,但产品形态完全不对——Apple logo 变形、缺少标志性的中缝设计。即便模型确实发起了网络搜索,准确性依然欠奉。这暴露了一个典型问题:渲染质量与事实准确性是两套能力,前者可以靠视觉先验"猜"得很好看,后者需要真正的知识 grounding。
空间推理:绳结测试的滑铁卢
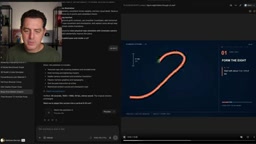
Berman 设计的新测试颇具巧思:让模型在 Blender 中建模一个系在攀岩安全带上的保护绳结(belaying knot)。这个任务同时考察电脑控制、网络搜索、空间推理和物理交互理解。结果失败了——绳结的总体形状接近八字结,但没有真正打结,也没有连接到安全带上,人形建模同样粗糙。
改用动效图解的任务中,Kimi 首版 5 分半钟产出了 28 秒 1080p 视频,但绳索的上下穿插关系完全无法辨认。即使用更详细的提示词要求"让绳子有质感、有连续镜头运动",第二版依然无法解决绳结的遮挡关系。作为对比,GPT 6.1 Sol 在中等推理强度下产出的 54 秒动效,能清晰展示绳索的上穿下绕,"如果手边有绳子,我完全可以照着打出来"。
空间推理 在 multimodal 模型中通常指理解物体三维位置、朝向、遮挡与拓扑关系的能力,它与二维图像识别是不同层次的问题。绳结建模这类任务之所以困难,是因为它同时要求:从文字描述推断绳子的连续路径、保证路径不自交且交替上下穿插(即真正的拓扑打结)、再通过代码接口在 3D 软件中精确执行。当前模型往往能生成“看起来像绳结”的表面形态,却在遮挡顺序和连接关系上出错——这说明视觉先验可以拟合外观,但缺少对物理与几何约束的显式建模。这也是 3D 渲染得分高、空间推理得分低这一落差的根源。
游戏与网页:及格线上的开放权重
48 分钟生成的 Fall Guys 克隆游戏"Bean Blitz"包含 12 个动画角色、旋转横杆、滑动门、弹跳板、检查点、计时器、音效、触屏控制等完整功能。但配色偏粉彩、碰撞检测不准、画面闪烁明显。网站重设计任务则"看起来像 AI 设计"——品牌色和字体对了,间距问题不少。
基准数据:纸面成绩与体感的落差
官方公布的基准显示 Kimi K3.1 Pro 已逼近顶级闭源模型:Terminal Bench 上以 65.7 分仅次于 Opus 5.5 的 66.4;GDP Val 真实知识工作评测中 1846 ELO 紧咬 Opus 5.5 的 1866;OS World 电脑操控测试 79.6 分与 Opus、Fable 同档;Artificial Analysis 智能指数 55 分,位列 Opus 5.5、Sonnet 5.5、Muse Wonderful 之后排名第四,但领先 Fable 5.1、GPT-6 Astra Max 和 Argon。
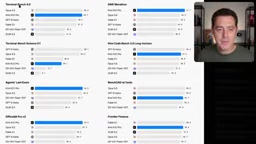
成本效率是另一个亮点:每智能任务成本仅 2.11 美元,远低于 Fable 5.1 的 7.63 美元和 Muse Wonder Max 的 4.54 美元。定价方面,标准速度输入 2 美元/百万 token、输出 10 美元/百万 token,高速版价格翻倍但速度快 2-3 倍,缓存输入价格保持 0.2 美元不变。
但 Berman 的实测体感与纸面数据存在明确落差:"从这些初步测试就能看出,它很好,但没到 Opus 5.5 和 GPT 6.1 Sol 的水平。"这一观察引出一个无法回避的疑问——考虑到 Kimi 模型此前曾被质疑存在蒸馏行为,且其输出中频繁出现与 Claude 家族相似的"眉题文本"(eyebrow text)设计习惯,基准分数与真实体验的错位值得持续观察。
蒸馏(distillation) 指用一个强教师模型的输出(logits 或生成的文本)来训练学生模型,使学生以更低成本逼近教师能力。它在工业界是常规做法,但若未披露、且学生模型与教师模型的输出分布高度重合,就会引发“基准分数是否真实反映独立能力”的质疑。判断线索通常包括:输出格式与措辞习惯高度相似(如特定的标题式小标签)、在教师模型特有题型上异常出色、以及自身训练数据披露不透明。对开源权重模型而言,蒸馏争议直接关系到其“可复现前沿能力”的叙事是否成立,因此基准分数需要结合独立实测而非榜单排名来评估。
开源前沿的意义与边界
Kimi K3.1 的价值不在于超越闭源旗舰,而在于把"接近前沿"的能力装进了可下载、可自托管的权重文件里。3 万亿参数的规模、百万级上下文、多模态输入,加上极具竞争力的推理成本,让它成为开源阵营一次扎实的向上突破。
但实测也划出了清晰边界:视觉渲染可以惊艳,空间推理和事实准确性仍有明显短板;基准分数可以逼近,复杂任务的完成度仍有差距。官方博客中那些令人印象深刻的演示——FreeCAD 涡扇发动机爆炸图、Blender 大教堂结构、NVIDIA 财务模型——证明模型上限存在,但普通用户能否稳定复现,是另一回事。
对开发者而言,Kimi K3.1 是一个高性价比的开放权重选项;对开源生态而言,它是一次明确的能力宣言。至于"开源是否真的回来了",答案取决于你用它做什么——渲染一个魔方,它足够惊艳;打一个绳结,它还差得远。
相关推荐

OpenAI新模型Bel曝光:10万亿参数,或成AGI基座
Reddit爆料称OpenAI新模型Bel即将问世,总参数超10万亿,或作为GPT-6之后的基础模型甚至AGI门槛基座。本文拆解爆料关键信息并评估可信度。

Claude Fable 5/5.1报错事件:30分钟故障复盘
Claude Fable 5与Fable 5.1出现错误率升高的服务故障,官方状态页显示影响约35分钟,从Investigating到Resolved仅用37分钟。本文还原故障时间线,分析对其他Claude模型的波及范围,并给出开发者重试、多模型路由与监控告警的应对建议。
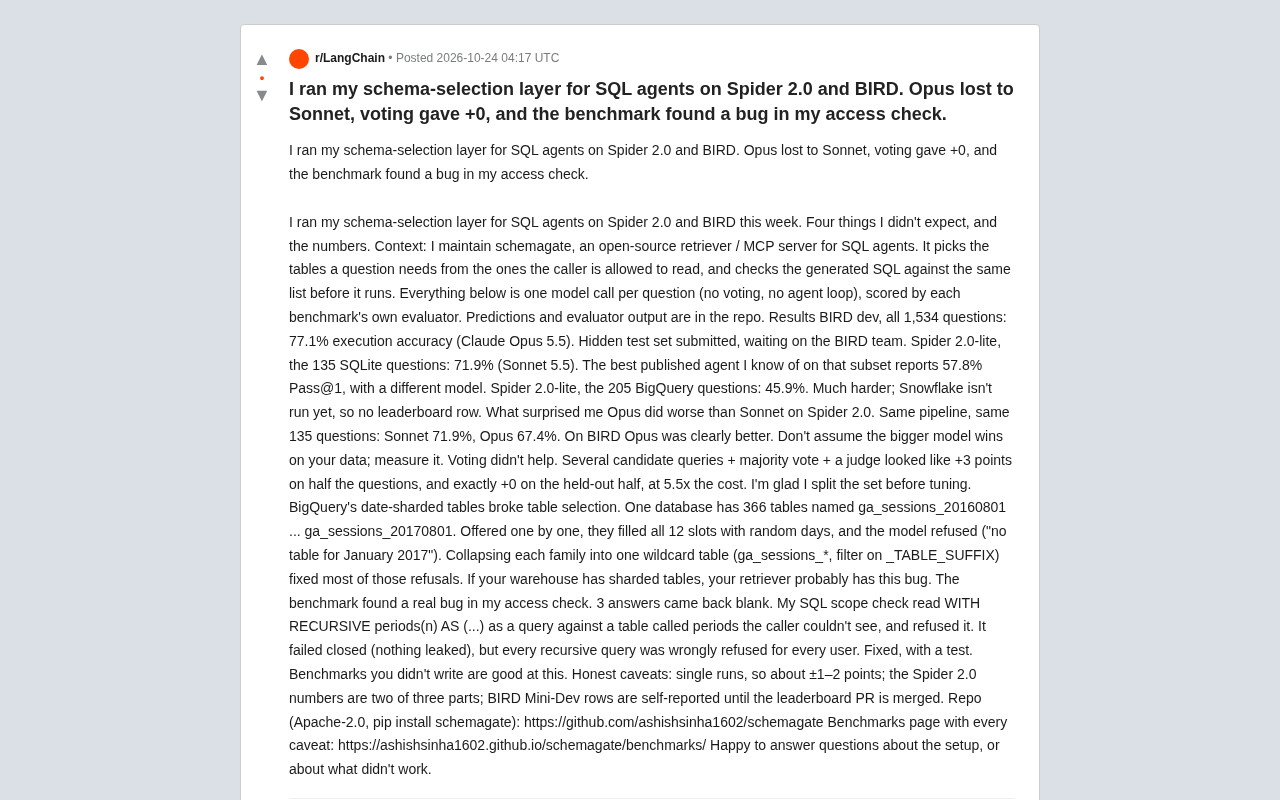
SQL Agent模式选择层实测:Opus竟输给Sonnet,投票机制零收益
开源项目 schemagate 在 BIRD 与 Spider 2.0 上实测 SQL Agent 模式选择层:Opus 在 Spider 2.0 上输给 Sonnet,投票机制留出集收益为零,BigQuery 分片表击穿选表逻辑,基准测试还暴露了权限校验 bug。