Strata本地部署Qwen3 Next 125B:消费级显卡跑大模型实战指南

Strata项目通过三级存储调度让消费级显卡本地运行Qwen3 Next 125B大模型。
Strata是一个开源项目,核心思路是将Qwen3 Next 125B大模型量化后,利用硬盘、内存、显存的三级存储分层调度来运行——大部分MoE专家权重放在内存中,显存仅承载约700个活跃专家,从而将显存门槛压低到6-12GB。项目通过安装脚本自动检测硬件、推荐量化版本并生成启动配置,模型文件约60GB是最耗时的环节。实测64K上下文时生成速度约90 token/秒,256K时降至60 token/秒。主要局限是并发能力弱,适合单人单对话的深度使用场景。项目上线五天即突破万星,为想在本地部署百亿级参数模型又不愿高价购置专业硬件的用户提供了可行方案。
Strata项目:让消费级显卡跑起125B大模型
近期在开源社区窜红的 Strata 项目,核心思路很简单:把千问 Qwen3 Next 125B 大模型量化后,通过巧妙的内存调度,让普通消费级显卡也能本地运行百亿级参数模型。这个项目上线仅五天左右,GitHub 星标就从八千多一路涨到一万以上,热度上升速度相当可观。
对大多数人来说,125B 参数的模型意味着要么租用昂贵的云算力,要么购置动辄上万元的专业显卡。Strata 想解决的正是这个痛点——不用花大价钱买顶级硬件,也能体验到接近大模型的能力。UP主在本地 127.0.0.1:8080 端口跑起模型后,让它写俄罗斯方块和贪吃蛇游戏,结果都能正常运行,直观验证了项目的可用性。

技术原理:吃内存而非吃显存
Strata 最关键的设计思路,是把硬盘(固态)、内存、显存三级存储充分调度利用,而重心落在内存上。Qwen3 Next 125B 采用 MoE(专家混合)架构,拥有两万多个专家模块。Strata 的做法是将绝大部分专家权重放在内存中,显存只负责容纳最多约 700 个专家(不到 1GB)。
这带来一个反直觉的特点:项目对显存要求不高,对内存要求反而更严格。因为权重数据量大,内存不足会导致加载失败或运行缓慢。UP主实测建议至少 12GB 显存起步,内存则建议 32GB 以上;社区中也有人反馈 6GB 显存勉强能跑(主要用于跑代码的轻量版本)。显存越大,模型的思考速度和长上下文处理能力就越强。
引擎部分用 C++ 编写,通过 Python 脚本调用配置。项目还集成了 MTP 投机解码(speculative decoding)来提升生成速度,其解码器权重仅 800 多兆(约 0.71GB,Q2 两位量化),属于作者自行抓取训练形成的轻量组件。
MoE(Mixture of Experts,专家混合)架构是近年大模型常用的稀疏激活设计:模型内部有大量"专家"子网络,但每次推理只激活其中一小部分,而非让所有参数都参与计算。这意味着模型的"总参数量"虽然巨大(125B),但单次推理实际用到的参数量远小于此,理论上可以大幅降低计算量。Strata正是利用了这一特性——既然每次只需调用少数专家,就可以把绝大多数专家权重放在内存甚至硬盘中待命,只在需要时才将对应权重调入显存计算,从而将对显存的需求压缩到极低水平。
MTP投机解码(Speculative Decoding)是一种加速生成的技术:用一个小型草稿模型(draft model)快速"猜"出后续若干token,再交给主模型一次性验证,批量接受正确的猜测结果,从而减少主模型的调用次数、提升整体吞吐速度。Strata集成的MTP解码器权重仅约0.71GB,作为轻量辅助组件,在几乎不增加显存占用的前提下有效改善了生成速度。
模型版本与硬件适配
Strata 提供了多个量化版本供选择,包括 Q2、RQ2、RQ3SS 等,另外还有专门用于写代码的 code 版本。选择哪个版本,主要看你的内存容量:
- 约 36GB 内存:建议装 Q2 版本
- 64GB 以上(权重大于 43GB):可选更高精度版本
- 代码专用需求:选择 code 版本
值得提醒的是,如果你是 32GB 内存配置下载较大模型,必须扩大虚拟内存——UP主建议把虚拟内存写到 40GB 甚至更大(例如额外再加 4GB 冗余),否则加载时会直接报错。
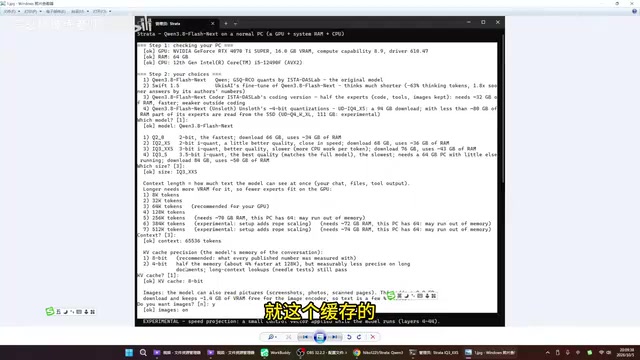
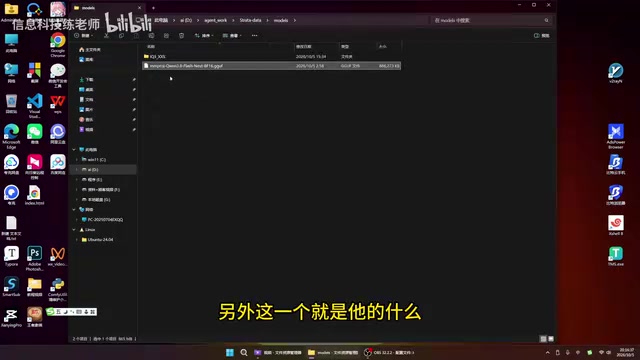
模型文件本身约 60GB,这也是整个安装过程中最耗时的环节。部分带视觉能力的版本还需要额外下载视觉模型,并在安装时启用图片读取选项(默认关闭,开启会额外占用约 1.4GB 显存)。
Q2、RQ2、RQ3SS等命名代表不同的量化精度方案。量化(Quantization)是指将模型权重从原始的16位或32位浮点数压缩为更低位数的整数表示,以大幅缩减模型体积和内存占用。Q2即2位量化,压缩率最高但精度损失也最大;RQ2、RQ3SS则是残差量化(Residual Quantization)的变体,通过多轮残差补偿的方式在低位宽下尽量保留精度,通常比纯Q2效果更好但体积略大。选择量化版本本质上是在"模型体积/内存占用"与"输出质量"之间做权衡,内存充裕时优先选更高精度版本可获得更接近原始模型的回答质量。
安装流程:脚本一键引导
Strata 的安装体验设计得相当友好,整个过程由安装脚本按步骤自动引导。UP主梳理的完整流程如下:
核心步骤
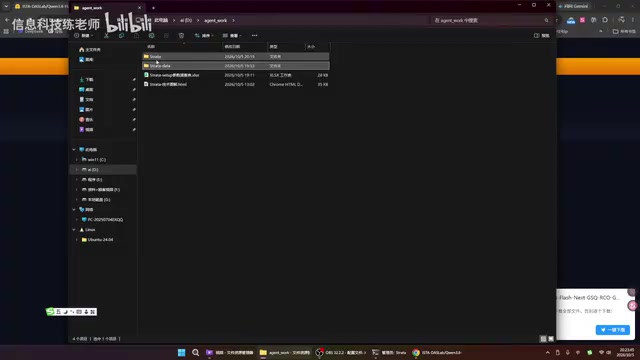
- 克隆源码:到项目主页克隆或下载源代码到本地文件夹
- 运行安装脚本:双击 start 脚本,脚本会先检测是否有 Python 环境,没有会自动安装,并创建虚拟环境
- 硬件检测:脚本自动读取本机配置(如 16GB 显存 + CPU),据此推荐合适的模型
- 选择模型与参数:依次选择模型类型、量化版本、上下文长度(如 64K 或 256K)、KV 缓存精度(8 位快、4 位省显存)、是否启用图片读取、是否强制回答
- 安装依赖:自动装好 llama、CUDA 等虚拟环境所需库
- 下载引擎与模型:根据显卡下载对应引擎文件,再下载约 60GB 的模型数据(最慢环节)
- 生成启动脚本:最后自动写入启动用的 BAT 批处理文件,提示完成
上下文长度的权衡
上下文设置直接影响体验。UP主实测:64K 上下文下生成速度可达每秒 90 多 token,而调到 256K 后速度降到每秒 60 多 token,但能支持更长的任务。256K 上下文约需 70GB 显存,用户需要根据自己硬件在"速度"和"智力/长任务能力"之间权衡调试。
上下文长度(Context Length)决定了模型在单次对话中能"记住"多少历史信息,单位是token(大致对应字词数量,中文约1-2个汉字为一个token)。64K上下文约能容纳数万字的对话或文档,而256K则可处理书籍级别的长文本任务。上下文越长,所需的KV缓存(Key-Value Cache)越大——这是Transformer架构在推理时存储注意力中间结果的内存区域,其大小与上下文长度成正比。这也是为什么256K上下文需要约70GB显存:KV缓存本身就会占据大量显存,而非完全来自模型权重。KV缓存精度选项(8位或4位)则允许用户在速度与显存占用之间进一步调节。
实用技巧与注意事项
黑窗口不能关:启动后那个命令行黑窗口是引擎的运行载体,一旦关闭服务就会中断,所有基于该服务的调用都会失效。
改端口方法:默认服务端口是本地 8080,如果与现有网站冲突,可以在生成的启动脚本中修改成 8081、8088 等其他端口。
单论对话为佳:Strata 支持多轮对话,但个人使用建议只开一个对话窗口。开多个并发对话会非常卡顿,这也是该项目在速度上的一个短板。
支持多卡:脚本默认单卡运行,但通过添加参数可启用双显卡。UP主提到可以研究安装文件中的参数配置,在 run 相关脚本后附加参数来实现更灵活的配置。
加速安装的思路:由于模型下载和依赖安装是最耗时的两部分,如果提前准备好虚拟环境和已下载的模型数据文件,把它们放到同级目录下,再跑配置脚本就会快很多。UP主计划将约 80GB 的完整包上传网盘,解压到同级目录即可省去漫长下载。
小结
Strata 本质上是一个智能的配置脚本工具,它会根据你的硬件自动生成匹配的启动脚本,让量化后的 Qwen3 Next 125B 在消费级设备上跑起来。它的最大价值在于降低了大模型本地部署的硬件门槛——用内存换算力,对显卡要求友好。对于想在本地折腾大模型、又不想投入高端硬件的用户来说,这是一个值得尝试的开源方案。需要注意的是,并发能力和极致速度仍是它的局限,适合单人单对话的深度使用场景。
相关推荐

Mistral Large 4(LeChonk)发布:欧洲从零打造的万亿参数开源模型
Mistral 发布万亿参数开源模型 Mistral Large 4(LeChonk),完全在欧洲从零训练。本文解析其 MoE 架构、定价、网络安全跑分表现,以及开源模型即插即用难题与真实价值。

RISED:多环境智能体训练的评分标准选择与自蒸馏方法
RISED 提出面向多环境智能体训练的评分标准选择与自蒸馏方法,解决跨环境样本精细筛选难题,以及批次内全失败/全成功组导致的组相对奖励信号失效问题,提升通用型 LLM 智能体的训练效率。

GPT-6.1 Sol「泄露」疑云:循环与嵌套模型架构浮出水面
一篇 Reddit 热帖通过推理速度数据反推 GPT-6/6.1 Sol、Astra、Luna 的底层架构,提出循环 Transformer 与嵌套模型可能同时被用于大规模低成本部署。本文梳理其推演逻辑与对开源社区的启示。