Strata开源运行时:12GB显卡跑动125B参数Qwen3模型
Strata把显存、内存、SSD组成三级计算域,让1250亿参数MoE模型跑在12GB显存的消费级GPU上。
Strata是一个开源推理运行时,核心思路是将整台电脑变成三级协同计算系统:GPU显存缓存最热专家,CPU在系统内存中就地并行计算冷门专家,SSD存放N-gram查找表。其目标模型Qwen3.8 Flash Next采用稀疏MoE架构,存储1250亿参数但每Token仅激活约60亿,形成巨大的存储与计算落差。Strata通过热门专家动态缓存、预填充分块隐藏PCIe传输、KV缓存分级存放,以及利用模型内置草稿层进行推测解码等手段叠加优化,最终在RTX 5070(12GB显存)上实现短对话约90 Token/秒。一个典型的反转是:显存更大的旧款RTX 3090反而预估能跑到100-140 Token/秒,说明在这类工作负载下显存容量胜过纯浮点算力。
1250亿参数的模型跑在一张12GB显存的RTX 5070上,按常理这根本不可能——即便压缩到2比特,模型体积仍是显存的好几倍。但一个名为Strata的开源推理运行时做到了:它能在RTX 5070上运行Qwen3.8 Flash Next,输出速度约为每秒90个Token。
它的秘诀不在于更激进的压缩算法,而在于一个颠覆性的思路——GPU根本不需要加载整个模型。Strata把整台电脑变成了一个精心编排的调度系统,让显存、内存、固态硬盘各司其职。本文基于B站UP主对Strata技术方案的讲解,拆解这套本地推理架构的核心设计。
模型本身:稀疏MoE带来的计算与存储鸿沟
理解Strata之前,得先看清Qwen3.8 Flash Next这个模型的特点。它采用稀疏混合专家(MoE)架构:虽然存储1250亿参数,但每个Token仅激活约60亿个参数。
具体机制是,每一层中由路由(router)从512个专家中选出10个激活,外加一个始终运行的共享专家。因此模型的存储量极其庞大,但单次计算量却很小。这正是Strata能够发力的根本缺口。
从整体架构看,模型共48层,由「3个门控DeltaNet层 + 1个稀疏注入」重复12次构成。每层都有512个专家,算下来模型实际包含约24.5万个专家实例。Strata会单独追踪每一个实例,且仅在12层保留传统的注意力缓存,这让长上下文的成本远低于标准Transformer。
混合专家(Mixture of Experts,MoE)架构最初源于1990年代的集成学习思想,近年被大规模语言模型重新采用。其核心思路是将模型的前馈网络层拆分为多个并行的「专家」子网络,每次推理时由一个轻量级的路由网络(router)根据当前输入动态选择少数几个专家参与计算。这样做的好处是模型的总参数量(容量)可以大幅扩展,但每次前向传播实际触发的浮点运算量(FLOPs)几乎不增加。稀疏MoE(Sparse MoE)特指每次仅激活极少数专家的变体,与之对应的是所有专家对每个Token都有贡献的稠密MoE。Qwen3.8 Flash Next从512个专家中每次只选10个,激活比例不足2%,这种极端稀疏性在推理层面制造了一个独特矛盾:GPU必须把全部专家权重放在触手可及的地方,却在绝大多数时候只用到其中极小一部分。传统推理框架面对这一矛盾时要么要求超大显存、要么接受频繁的权重换入换出,Strata的设计正是专门针对这一矛盾展开的。
三级内存层级:把整台电脑变成计算域
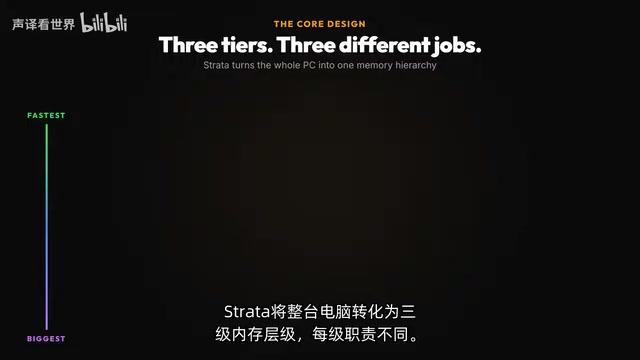
Strata的核心设计,是将整台电脑转化为一个三级内存层级,每级职责分明:
- 显存:存放每个Token会触及的所有内容——异构的注意力和DeltaNet混合器、路由、共享专家、输出头、草稿层,以及最热门专家的缓存。
- 系统内存:固定存放全部约2.4万组专家。
- 固态硬盘:存放29GB的N-gram查找表,每次只读取几行。关键在于这是「查找」而非「计算」。
普通的卸载(offloading)方案,会在需要时从内存复制缺失的专家到GPU,这让数据搬运成为每个Token的关键路径瓶颈。Strata的做法截然不同:当某个专家不在GPU上时,CPU直接在内存中就地计算它,另一边GPU并行处理缓存中的专家。内存不再是慢速的「虚拟显存」,而成为了第二个计算域。
「卸载(offloading)」是指将无法完全放入GPU显存的模型权重暂存于系统内存或磁盘,在需要时再传输到GPU执行计算。这一技术已被llama.cpp等框架广泛支持,但其瓶颈在于PCIe带宽:现代桌面PCIe 4.0 x16理论带宽约32 GB/s,而生成阶段每个Token都需要触发权重传输,传输延迟直接叠加在每步生成时间上,导致速度随卸载比例急剧下降。Strata对此的改进思路可以理解为「异构计算」而非「异构存储」:CPU与其内置的内存控制器本就能直接访问DDR5内存,带宽通常在50-100 GB/s以上,延迟也远低于PCIe往返。让CPU在内存中原地执行矩阵乘法,再将结果经PCIe回传给GPU做汇总,虽然每个冷门专家的单次算力不如GPU,但与「把权重先搬到GPU再算」相比,实际吞吐反而可能更高——尤其是当这两步能与GPU计算真正并行时。
热门专家缓存:显存成为工作集缓存
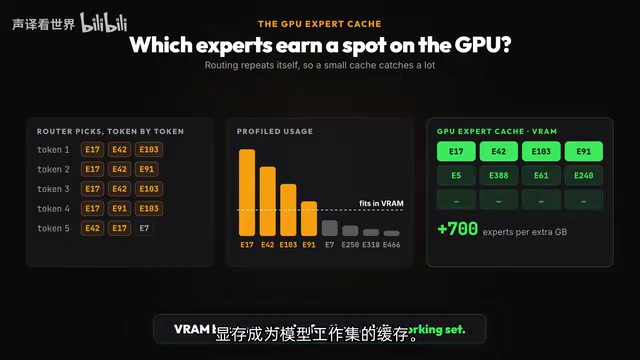
那么哪些专家能占据宝贵的GPU位置?答案是路由并非随机——在特定工作负载下,相同的专家会被连续选中。
Strata会分析全部2.4万个专家的使用情况,用剩余显存填充最热门的专家,并随对话动态调整。每一次缓存命中,都意味着CPU无需触碰该专家。按估算,每多1GB显存可容纳约700个专家。于是显存变成了模型工作集的缓存。
在存储层面,Strata使用低比特量化:最小配置约需38GB的内存+显存总和,最高质量配置约需55GB,因此64GB系统内存是理想目标。而510亿参数规模的N-gram表因为是查找而非矩阵乘法,被保留在固态硬盘上,由操作系统的页缓存维持热数据的访问速度。
预填充与长上下文:把传输藏进计算里
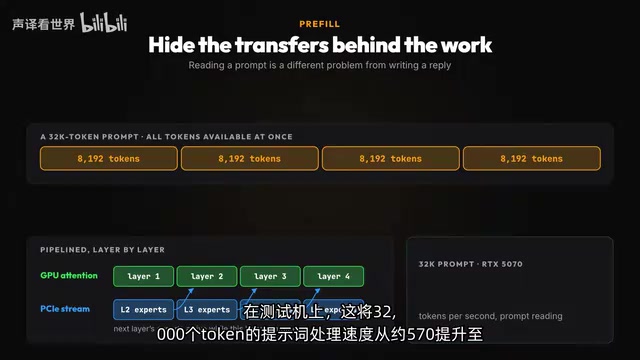
读取长提示词和生成回复是两个不同的问题。预填充阶段,数千个Token同时可用,Strata将提示词分割为最多8000个Token的块。当某一层的注意力在运行时,下一层所需的专家已经通过PCIe流式传输完成——传输被隐藏在有效计算之后。
效果相当明显:在测试机上,处理3.2万个Token的提示词速度从约570个Token每秒提升至近1300个Token每秒。
长上下文还带来KV缓存的内存压力。当上下文超过6.4万个Token时,Strata将大部分KV缓存保留在内存中,仅把最热的3.2万个Token保留在显存里。注意力读取的值完全相同,只是存放位置改变,释放出的显存又回流给专家缓存。在完整的26.2万上下文下,GPU上的专家数量能翻倍以上,速度从约51提升至63个Token每秒。
推测解码:用模型自身的草稿层加速生成
即便内存问题解决了,生成本身仍是串行的——每个Token都需要完整遍历一次48层。Strata利用模型自带的多Token预测层来攻克这一点:它一次起草最多3个Token,单次遍历全部48层即可同时校验。
平均每次遍历能产出2.4到3.2个Token,而大模型最终决定每个Token,因此输出结果不变。对于代码编辑类场景,还可以用「提示词查找」从上下文已有文本中起草候选,再额外提升6%到11%。
推测解码(Speculative Decoding)是一种通用的自回归加速技术,由Google等机构在2022-2023年间系统化提出。其基本逻辑是:大模型验证一批候选Token的成本远低于逐一生成它们的成本。常见做法是用一个参数量极小的「草稿模型」连续生成若干候选Token,再由目标大模型一次并行校验,接受符合其分布的部分并从第一个不符合处截断重新生成。Qwen3.8 Flash Next的设计内置了多Token预测(Multi-Token Prediction,MTP)层,相当于模型自带草稿头,省去了维护独立小模型的成本,也避免了草稿模型与目标模型分布不一致导致接受率偏低的问题。这种内置方式被称为「自推测解码」,其接受率通常高于外置草稿模型,因为草稿头与主干共享所有前层的表示,对下一步生成有更准确的预判。Strata报告的平均2.4到3.2 Token每次遍历的接受率,意味着实际墙上时钟速度相当于原始串行生成的2倍以上,而输出的概率分布与逐步采样严格等价。
实测数据与一个有趣的反转
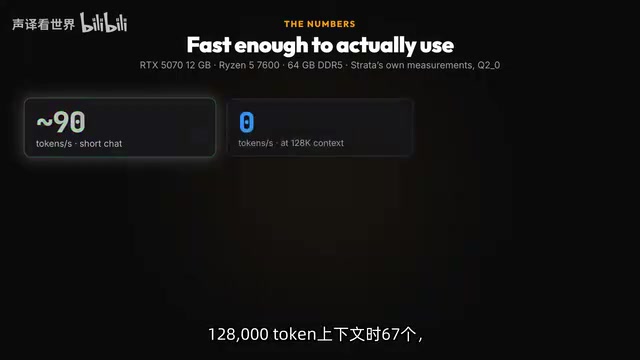
综合所有技术,在配备6核锐龙和64GB内存的RTX 5070上,Strata的自测数据为:
- 短对话约90个Token每秒
- 12.8万Token上下文时约67个Token每秒
- 读取提示词时约1300个Token每秒
一个耐人寻味的反转是:旧款RTX 3090的预估性能反而达到100到140个Token每秒。原因并非3090更快,而是它的24GB显存能容纳更多专家。在这种工作负载下,显存容量胜过了纯浮点算力。
要让Strata正常工作,硬件需要满足几个条件:12GB显存、64GB内存、快速的NVMe固态硬盘和不错的CPU。内存不足则模型无法加载;显存不足则CPU需承担更多专家;CPU太弱时冷门专家会成为瓶颈;若PCIe传输无法被隐藏,GPU就得等待。
不是压缩魔法,而是调度艺术
Strata并没有把1250亿参数硬塞进12GB显存,而是把它转化成了一个调度问题:稀疏性削减计算量,量化削减存储,专家缓存保持热门工作集在GPU上,CPU并行处理其余部分,固态硬盘提供查找服务,推测解码减少遍历次数。
GPU并非独自运行模型,而是整机协同运行。这究竟是本地大模型推理的未来方向,还是一个巧妙的权宜之计,或许要看消费级硬件和MoE架构的演进。但至少它证明了一件事:面对显存瓶颈,除了压缩模型,还有编排硬件这条更聪明的路。
相关推荐

智能体底座(Harness)比模型本身更关键:YC深度解析Agent架构演进
YC在Harness Night分享会上提出:决定智能体能力的关键不是模型本身,而是外层的Harness底座。本文梳理从GPT-2到自改进Harness的演进,解析Prime Agent、OpenJarvis、QM三大实践及Agent架构设计要点。

用n8n搭建LinkedIn线索抓取与丰富化自动工作流
一套基于n8n的LinkedIn线索抓取与丰富化自动工作流:只需填写职位、地点、行业和公司规模,系统即可自动生成含专业邮箱和验证状态的客户名单并写入Google表格。本文解析其流程、输出字段与合规注意事项。

SageMaker HyperPod:跨团队共享GPU集群的隔离与公平性实践
Amazon SageMaker HyperPod 推出跨团队共享GPU集群的参考架构,通过IAM Identity Center认证、Kubernetes命名空间隔离、Task Governance公平调度和成本分摊,实现算力安全共享与费用透明化。