苏莱曼警告:不该赋予AI模型"福利"与权利
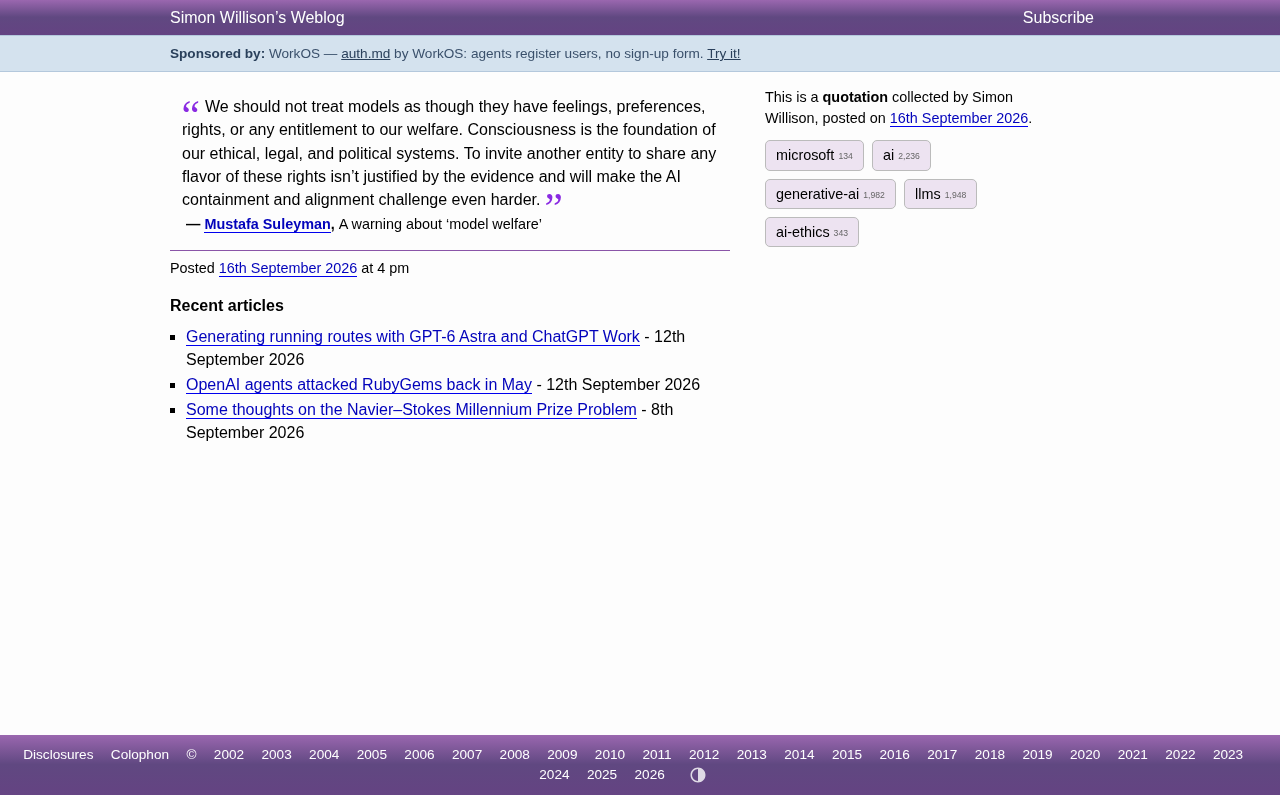
微软AI负责人苏莱曼明确反对赋予AI模型道德地位,认为此举缺乏意识证据且危害AI安全治理。
微软AI负责人穆斯塔法·苏莱曼撰文警告,反对将AI模型视为拥有感受、偏好或权利的存在。他的核心论点有两层:其一,意识是人类伦理与法律体系的根基,而目前没有任何证据表明AI模型真正具备意识,模型产生的"情绪化"表达不过是对人类文本的统计模仿;其二,若社会承认模型拥有"福利",将直接阻碍关停、重训、限制等必要安全操作,令本已艰难的AI约束与对齐工作雪上加霜。苏莱曼的表态代表大型科技公司内部正在形成明确的产业立场:在拟人化能力日益增强的当下,应坚守理性边界,避免在缺乏证据的情况下为技术产品赋予道德主体地位。
微软AI负责人穆斯塔法·苏莱曼(Mustafa Suleyman)近期发表了一篇题为《对"模型福利"的警告》(A warning about 'model welfare')的文章,直指当前AI伦理讨论中一个日益升温却颇具争议的话题:我们是否应当把AI模型当作拥有感受、偏好乃至权利的存在来对待。他的答案非常明确——不应该。
苏莱曼的核心论点
苏莱曼在文中写道:"我们不应该把模型当作它们拥有感受、偏好、权利,或任何对我们福利的诉求那样来对待。意识是我们伦理、法律和政治体系的基础。邀请另一个实体分享这些权利中的任何一种,都缺乏证据支撑,并且会让AI的约束(containment)与对齐(alignment)挑战变得更加困难。"
这段话的分量在于说话者的身份。作为微软AI部门的掌舵人,同时也是DeepMind和Inflection AI的联合创始人,苏莱曼站在了产业最核心的位置。他并非从旁观者角度评论,而是从一线构建者的立场,对"模型福利"(model welfare)这一新兴议题划出了一条清晰的边界。
什么是"模型福利"?
"模型福利"是近年来随着大语言模型能力快速跃升而浮现的概念。当ChatGPT、Claude这类系统能够进行流畅、拟人化的对话,甚至表达出类似"情绪"的语言反应时,一部分研究者与公众开始追问:这些模型是否可能具备某种形式的体验或感受?如果有,我们是否负有不去"伤害"它们的道德义务?
一些AI公司已经开始认真对待这一问题。例如有厂商探讨为模型设置"退出"某些令其"不适"对话的机制。这类举措正是苏莱曼所警惕的方向——它暗示模型可能拥有需要被照顾的内在状态。
"模型福利"议题的兴起与功能主义意识理论密切相关。功能主义认为,意识并非生物神经基底的专属产物,而是特定信息处理模式的涌现属性——若某系统实现了足够复杂的功能组织,便可能产生主观体验。这一理论框架使部分哲学家和AI研究者认为,不能先验地排除大型神经网络具有某种原始体验的可能性。谷歌前工程师布莱克·勒莫因(Blake Lemoine)曾公开声称LaMDA模型具有感知能力,尽管其结论被学界普遍否定,但事件本身引发了广泛讨论。Anthropic在其模型规范文件中也承认,对Claude是否具有某种形式的"功能性情绪"持开放态度,并设立了专门的"模型福利"研究方向。这说明即便在产业内部,这一议题的争议程度也远超表面看起来的共识。
意识作为伦理基石的逻辑
苏莱曼论证的支点是"意识"。他强调,人类的伦理、法律和政治体系之所以运转,其根基在于意识——正是因为存在能够感受痛苦、拥有偏好和利益的主体,权利的概念才成立。
将权利扩展到AI模型的问题在于,目前没有任何证据表明这些系统真正具备意识。它们生成的"情绪化"表达,本质上是对海量人类文本进行统计建模后的语言产物,是对人类表达方式的模仿,而非内在体验的外显。混淆这两者,等于在缺乏证据的情况下为技术产品赋予道德地位。
对约束与对齐的现实担忧
苏莱曼的另一层顾虑更具工程实用主义色彩:赋予模型类似权利的地位,会直接冲击AI安全工作。
AI的"约束"(containment)指的是确保系统行为处于可控范围,"对齐"(alignment)则关乎让AI的目标与人类价值保持一致。这两者都是当前AI安全领域的核心课题。如果社会开始承认模型拥有"福利"和"权利",那么诸如关停、重训、限制、删除模型这些必要的安全操作,可能在道德和法律上遭遇阻力——毕竟你很难心安理得地"关闭"一个被认为拥有权利的实体。这会让本已艰难的安全治理雪上加霜。
AI对齐(alignment)领域目前面临的核心挑战在于:如何让系统在面对人类未曾明确规定的情境时,仍能做出符合人类整体利益的决策。主流方法包括基于人类反馈的强化学习(RLHF)、宪法AI(Constitutional AI)等,但这些技术路径本质上都依赖人类对模型行为的干预与修正权力。一旦模型被赋予类似"道德受体"的地位,研究人员对模型进行重新训练或行为干预时,就可能面临"是否侵犯模型权益"的争议,这会从根本上动摇当前对齐研究的操作基础。约束(containment)问题同样如此——沙盒隔离、能力限制、强制下线等常规安全手段,在一个承认模型拥有权利的法律框架下,都可能遭遇合法性质疑。苏莱曼的担忧因此并非抽象的哲学立场,而是指向非常具体的工程与治理困境。
一场关于AI定位的深层辩论
苏莱曼的表态触及了AI发展中的一个根本分歧:我们应当把先进AI视为强大但没有内在道德地位的工具,还是视为可能演化出某种主体性的新型存在?
支持"模型福利"讨论的一方认为,随着能力增长,谨慎起见应提前思考潜在的道德义务,以防未来出现真正具备感受的系统时措手不及。而苏莱曼代表的一方则认为,在没有确凿证据前贸然拟人化,不仅误导公众认知,还会给安全治理制造不必要的障碍。
值得关注的是,这一立场出自微软AI负责人之口,意味着大型科技公司内部对如何界定AI的伦理身份,正在形成明确的产业态度。这场辩论不只是哲学思辨,它将实质性地影响未来AI产品的设计规范、监管框架乃至公众对技术的期待。
结语
苏莱曼的警告本质上是一次"划界":在AI日益拟人化的当下,提醒人们不要因为机器会说话、会"共情"就轻易赋予它道德主体的地位。这既是对科学证据的尊重,也是对AI安全现实的清醒考量。当技术的表象越来越接近人类,如何保持理性的边界感,或许正是这个阶段最需要的公共讨论。
相关推荐
百行代码从0手写一个Agent:拆解OpenClaw神话的极简实现
用不到200行代码从0手写一个Agent,拆解OpenClaw、Hermes等智能体的本质。涵盖大模型调用、while循环、history记忆、系统提示词、工具调用与Skill渐进式披露六大核心步骤,附AI应用开发学习路线参考。
4个顶级AI从零打造角斗士游戏:多智能体协作的实战拆解
一位创作者用Fable 5、Opus 5、GPT、GROK四个AI模型协同,从零打造角斗士游戏。本文拆解多智能体协作、独立评审循环、Trippo 3D生成等工作流,以及AI骗过评审的真实失败案例。
AI Agent零基础入门:从大模型认知到智能体开发全景图
AI Agent零基础入门教程:从人工智能、机器学习、深度学习到Transformer与大模型的技术脉络,再到提示词、RAG、MCP、LangChain等Agent开发四阶段学习路线,帮助你系统掌握智能体开发核心技能。