算法审计漂绿:机器学习如何量化企业碳排放造假的市场代价

研究用EPA与SEC硬数据构建算法排放基线,证明市场主动惩罚漂绿行为并将其视为企业管理失当的先行指标。
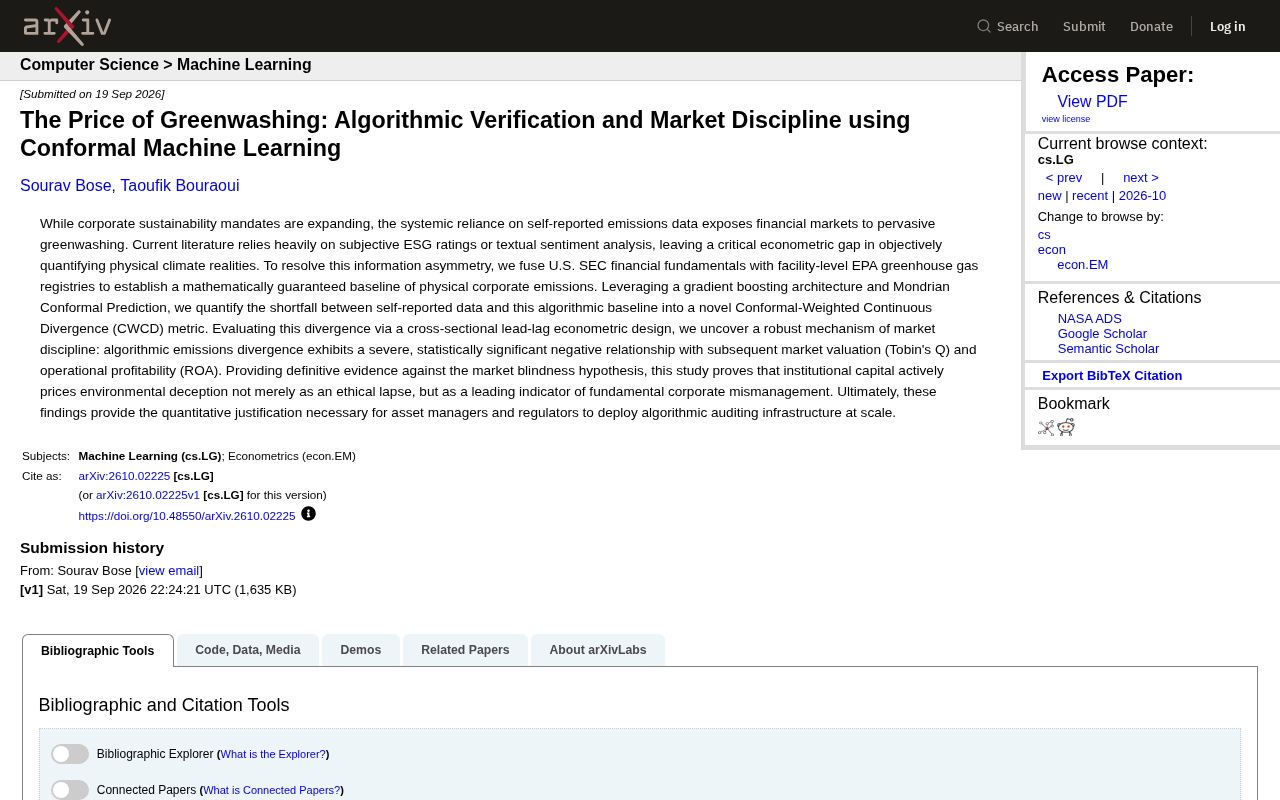
这篇arXiv预印本研究提出了一套绕开企业自我申报、客观量化碳排放造假的方法论体系。研究融合SEC财务数据与EPA设施级强制排放登记,以梯度提升模型构建物理排放基线,并引入Mondrian共形预测生成具有统计保证的预测区间,从而推导出"共形加权连续偏离度"(CWCD)这一新指标,用于量化企业自报数据与算法基线之间的落差。横截面先导—滞后计量分析显示,算法排放偏离度与企业随后的托宾Q值和ROA均呈显著负相关,直接反驳了"市场无法识别环境造假"的市场盲视假说。研究的深层含义在于:市场将漂绿行为读作企业整体治理与运营纪律松懈的早期信号,而非单纯的道德瑕疵。这一发现为资产管理机构和监管部门大规模部署算法审计基础设施提供了量化依据,代表着环境金融监管从"信任企业自述"向"算法验证现实"转变的重要方向。
当企业碳排放"自己说了算"
企业可持续发展的要求在不断扩张,但一个结构性漏洞始终存在:绝大部分排放数据都来自企业自我申报。这种"自说自话"的机制,为金融市场埋下了普遍的"漂绿"(greenwashing)隐患——企业可以在报告中粉饰环境表现,而市场却缺乏客观手段去验证这些数字的真实性。
一篇发表于 arXiv 的最新研究(arXiv:2610.02225v1)正面挑战了这一问题。研究指出,当前学界对企业环境表现的评估高度依赖主观的 ESG 评级或文本情感分析,这些方法本质上仍是"读企业怎么说",而非"看企业实际排了多少"。这留下了一个关键的计量经济学空白:如何客观量化企业的物理排放现实。
用两套权威数据交叉比对出"真实基线"
研究的核心思路,是绕开企业的主观陈述,直接从硬数据中构建一条"数学上有保证"的排放基线。具体做法是融合两类美国官方数据:一是 SEC(美国证券交易委员会)的企业财务基本面数据,二是 EPA(美国环保署)设施级别的温室气体登记数据。
前者反映企业的经营规模与财务状况,后者则是逐个工厂、逐个设施记录的实际排放量。将两者结合,就能建立起一个基于物理现实、而非企业口径的排放参照系。这种数据来源的选择颇具巧思——EPA 的设施级登记是强制性、可核查的,极大降低了被企业操纵的空间。
技术栈:梯度提升 + Mondrian Conformal Prediction
在建模层面,研究采用了梯度提升(gradient boosting)架构来拟合排放基线,并引入了 Mondrian Conformal Prediction(蒙德里安共形预测)来提供带有统计保证的预测区间。
共形预测的价值在于,它不只给出一个点估计,而是给出一个在给定置信水平下有效的预测区间。这意味着研究者可以严谨地判断:某家企业自报的排放数据,是否显著偏离了算法推算出的合理区间。基于此,研究构建了一个新指标——共形加权连续偏离度(Conformal-Weighted Continuous Divergence, CWCD),用来量化"自报数据"与"算法基线"之间的落差。
梯度提升(Gradient Boosting)是一种集成学习方法,通过迭代地训练多棵决策树,每棵新树专门拟合前一轮模型的残差误差,最终将所有树的预测叠加为最终输出。相比单一决策树,它对非线性关系和特征交互的捕捉能力更强,在结构化表格数据(如财务与排放数据)上通常表现优异。常见实现包括 XGBoost、LightGBM 和 CatBoost。
Mondrian Conformal Prediction 是共形预测(Conformal Prediction)框架的一个分层变体。标准共形预测的核心思想是:在不对数据分布做任何参数假设的前提下,利用"非一致性分数"(nonconformity score)构造具有有限样本有效性(finite-sample validity)保证的预测区间——即在指定置信水平 α 下,预测区间覆盖真实值的频率至少为 1-α,这一保证在统计上是严格的。Mondrian 变体进一步将样本按类别或分层(如行业分组)分别校准,使得每个子群体内部的覆盖保证均独立成立,避免了不同规模或行业企业混用同一校准集导致的系统性偏差。这一特性在评估排放偏离时尤为重要:能源密集型行业与轻资产服务业的排放规律差异悬殊,分层校准可确保算法对各类企业给出公平且有统计保证的区间判断。
市场真的在"惩罚"环境欺骗吗
指标建立之后,研究用横截面的先导—滞后(lead-lag)计量设计来检验一个关键问题:这种算法揭示出的排放偏离,是否与企业后续的市场表现相关?
结果相当清晰。研究发现,算法排放偏离度与企业随后的市场估值(以托宾 Q 值衡量)以及经营盈利能力(以 ROA 衡量)之间,存在严重且在统计上显著的负相关关系。换句话说,一家企业的自报排放越是偏离算法推算的真实基线,它后续的估值和盈利往往越差。
这一发现直接反驳了所谓的"市场盲视假说"(market blindness hypothesis)——即认为市场无法识别环境造假的观点。研究给出的证据表明,机构资本实际上在主动为"环境欺骗"定价,而且并非把它当作一个纯粹的道德瑕疵,而是将其视为企业基本面管理失当的先行指标。
从道德问题到管理信号
这个结论的分量值得细品。它暗示:一家企业若在排放数据上造假,往往不是孤立的环境问题,而是整体公司治理与运营纪律松懈的外在表现。市场的敏锐之处在于,它把"漂绿"读作一个关于企业管理质量的早期警报。对投资者而言,CWCD 这类指标因此具备了超越 ESG 合规的实用价值——它可能是预测财务恶化的量化信号。
托宾 Q 值(Tobin's Q)是衡量企业市场估值相对于其资产重置成本之比的指标,计算方式通常为企业市值与总资产账面价值之比。Q 值高于 1 意味着市场对企业未来盈利的预期超出其现有资产的账面价值,反映良好的增长前景与竞争优势;Q 值持续走低则意味着市场对企业价值创造能力的信心下降。ROA(资产回报率,Return on Assets)则衡量企业利用全部资产产生净利润的效率,是评估管理层运营能力的常用会计指标。研究同时选用这两个指标,意在从"市场预期"与"经营现实"两个维度交叉验证排放偏离的经济后果,使结论更具说服力。先导—滞后(lead-lag)设计则确保了因果方向的可信度:排放偏离度在时间上先于估值与盈利变化,排除了"企业因经营恶化才放弃环保"的反向因果解释。
给资产管理者和监管者的启示
研究的落脚点非常务实:这些发现为资产管理机构和监管部门大规模部署"算法审计基础设施"提供了量化依据。
长期以来,ESG 评估面临的最大质疑之一就是主观性强、口径不一、容易被企业公关影响。而这项研究提供了一条替代路径:用权威的物理数据和带统计保证的机器学习方法,构建可规模化、可复现的客观审计体系。对监管者来说,这意味着可以更有针对性地识别高风险企业;对资产管理者而言,则多了一个纳入投资决策的硬指标。
当然,作为一篇预印本研究,其结论仍待同行评审与更广泛数据集的检验,且方法目前基于美国 SEC 与 EPA 数据,迁移到其他市场的适用性有待验证。但它所代表的方向——从"信任企业自述"转向"算法验证现实"——很可能是环境金融监管演进的重要一步。
小结
这项研究的意义,不仅在于提出了一个新指标,更在于它用严谨的计量证据表明:市场并非对漂绿无动于衷。当算法能够以可量化、有统计保证的方式揭示排放数据的真伪时,环境欺骗的成本就不再是模糊的声誉损失,而是实实在在反映在估值与盈利上的市场纪律。
相关推荐
OpenAI DevDay爆料:神秘智能体"o"与超高速API曝光
OpenAI DevDay前夕爆料汇总:神秘全天候智能体"o"曝光,支持63种语言并针对长周期任务设计;超高速API扩容在即;同时Anthropic Sonnet 5.5与MiniMax M3.1 Flash相继发布,AI行业竞争白热化。

谷歌推出全新Gemini企业智能体:一个提示框搞定所有工作
谷歌在NASA一号机库的Gemini at Work活动上推出全新Gemini企业智能体,一个提示框即可完成问答、知识工作、图像生成和代码运行。本文解析其统一智能体、持久执行、多智能体编排等六大核心架构原则。

Markdown为何成为人机与AI智能体沟通的通用语言
Markdown正成为人机与AI智能体之间的通用信息表示格式。本文解析它为何胜出,以及非结构化数据转Markdown这一关键翻译层对AI应用的意义。