Sugra MCP:一键接入200+数据源,打通主流AI应用

Sugra MCP以统一数据层接入多款AI应用,提供200+数据源,降低迁移成本但存单点依赖。
Sugra MCP 定位为统一的数据连接层,让 Claude、ChatGPT、Codex、Cursor、Grok、VS Code 等任何支持 MCP 协议的应用共享同一套数据源。它提供 200+ 数据源、1,600+ 端点和 7 个方向的数据覆盖,示例查询可返回带来源标注的 FRED 失业率数据。该服务已列入 Anthropic Connectors Directory、OpenAI Plugins Directory 和 GitHub MCP Registry 三个分发渠道,接入成本极低:Claude Code 一条命令,ChatGPT 一个按钮。其核心价值在于将数据接入从应用层下沉到协议层,降低多 AI 工具间的迁移成本并保持数据口径一致,但集中化也带来单点依赖风险,且定价、速率限制等细节尚未披露。
为什么需要统一的MCP数据层
每天切换在Claude、ChatGPT、Codex、Cursor、Grok、VS Code之间,是许多开发者和知识工作者的常态。每个应用都有各自的数据接入方式,重复配置、格式不一、维护成本高。Sugra MCP试图解决这个问题:它将自己定位为一个统一的数据连接层,让任何支持MCP协议的应用都能共享同一套数据源。
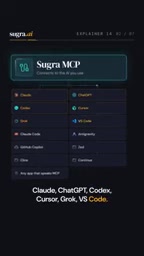
官方介绍视频中,Sugra MCP强调“一次连接”(One connection),覆盖Claude、ChatGPT、Codex、Cursor、Grok、VS Code,以及任何“speaks MCP”的应用。这背后是MCP(Model Context Protocol)作为开放协议的价值——只要应用支持该协议,数据层就可以复用,而不必为每个工具单独开发插件。
MCP(Model Context Protocol) 是由 Anthropic 于 2024 年底提出并开源的协议,旨在为 AI 应用与外部数据源、工具之间提供标准化的通信方式。可以将其类比为“AI 世界的 USB-C 接口”:只要应用实现了 MCP 客户端,就能以一致的方式连接任意 MCP 服务器,而服务器端只需暴露标准接口,无需为每个客户端单独适配。MCP 采用客户端-服务器架构,支持资源(Resources)、工具(Tools)和提示(Prompts)三种原语,传输层可基于 stdio 或 HTTP+SSE。该协议已被 Claude Desktop、Cursor、Zed 等工具采纳,并逐渐成为连接 LLM 与外部系统的行业事实标准之一。
200+数据源与1,600+端点意味着什么
Sugra MCP披露的规模数据值得关注:超过1,600个端点、超过200个数据源、7个方向,全部通过Sugra Data提供。
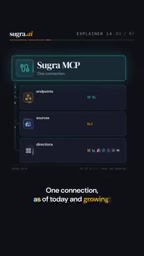
“200+来源”与“1,600+端点”之间的比例说明,平均每个数据源暴露了多个可查询接口。对于需要跨领域取数的场景——比如同时查询宏观经济、行业指标和实时数据——这种聚合方式可以减少在多个API之间来回切换的麻烦。
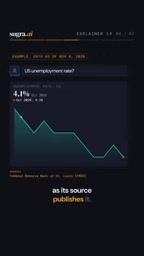
视频中给出的示例是查询美国失业率,返回4.1%,并注明来源为FRED(美联储经济数据)。这里有两个值得注意的细节:一是数据返回时附带来源标注,便于追溯;二是Sugra强调“as its source publishes it”,即按来源发布的原始口径呈现,而不是二次加工。对于研究型任务,来源可追溯性往往比数据本身更重要。
FRED(Federal Reserve Economic Data) 是由美国圣路易斯联邦储备银行维护的宏观经济数据库,收录超过 80 万条经济时间序列,涵盖失业率、CPI、GDP、利率等指标,数据来源包括美国劳工统计局、商务部等官方机构。FRED 提供免费的 API 供开发者按序列 ID 拉取数据,并支持版本追踪与来源标注。在 AI 工作流中,FRED 常被用作宏观经济查询的权威数据源,其数据口径与官方发布保持一致,适合需要可追溯性的研究型任务。
分发渠道:三个目录的背书
Sugra MCP称已列入Anthropic Connectors Directory、OpenAI Plugins Directory和GitHub MCP Registry。
这三个渠道分别对应Claude生态、ChatGPT生态和开源开发者社区。同时进入三者的MCP服务目前并不算多,这在一定程度上说明其兼容性和合规审查通过了不同平台的要求。对用户而言,这意味着在对应应用内可以直接找到并启用,而不必手动配置服务器地址。
Anthropic Connectors Directory 是 Claude 官方维护的连接器目录,收录经过审核的 MCP 服务器与外部服务集成,用户可在 Claude 设置中直接启用;OpenAI Plugins Directory 是 ChatGPT 的插件/工具市场,开发者提交后需通过 OpenAI 的合规与安全审查;GitHub MCP Registry 则是 GitHub 推出的 MCP 服务器注册表,面向开源开发者社区,提供发现与安装入口。三者分别覆盖 Claude、ChatGPT 和开源生态,同时被收录意味着该服务在接口规范、安全策略和用户体验上通过了不同平台的独立评估。
接入成本:一条命令与一个按钮
Sugra MCP在接入体验上做了明显简化:Claude Code只需一条命令,ChatGPT只需点击一个按钮。
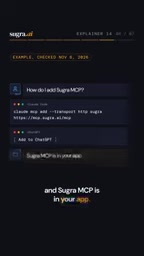
服务器地址为mcp.sugra.ai,详情页在sugra.systems.mcp。这种“命令即接入”的设计思路,与当前AI工具追求低摩擦配置的趋势一致。对于团队而言,统一的数据入口也意味着权限管理和审计可以集中在一处,而不是散落在各个应用的独立配置中。
需要注意的是,视频并未披露具体的定价、速率限制或数据源清单的完整范围。200+来源覆盖哪些领域、7个方向具体指什么,目前只能从官方文档进一步确认。
对开发者的实际意义
从架构角度看,Sugra MCP的价值不在于“又一个数据API”,而在于把数据接入从应用层下沉到协议层。当Claude、ChatGPT、Cursor等应用都通过同一个MCP服务器取数时,切换工具的迁移成本大幅降低,数据口径也更容易保持一致。
对于构建多AI工具工作流的团队,这类统一数据层的吸引力在于可组合性:同一个查询逻辑可以在不同应用中复用,而不必为每个平台重写集成代码。不过,集中化也带来依赖风险——一旦该服务不可用,所有接入的应用都会受影响。是否值得采用,取决于团队对数据源广度与单点依赖之间的权衡。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。