Swift-Qwen3.8-27B:削减58%思考token,推理速度翻倍
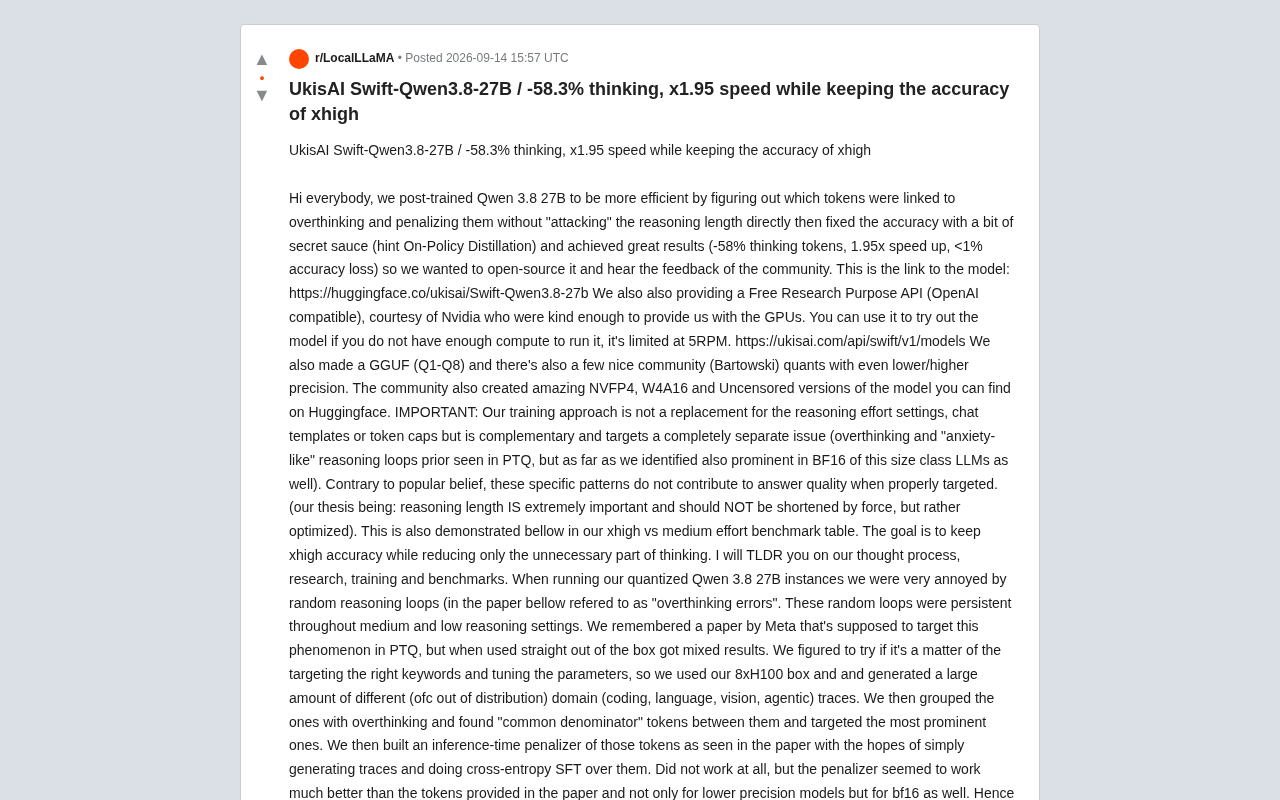
UkisAI开源Swift-Qwen3.8-27B,通过精准惩罚冗余"过度思考"token,在准确率损失1%内实现推理提速1.95倍。
AI推理模型普遍存在"过度思考"问题——模型在生成答案过程中产生大量对结果无贡献的冗余推理循环。新兴实验室UkisAI开源的Swift-Qwen3.8-27B通过后训练手段系统解决了这一问题:团队在多个OOD领域采集推理轨迹,识别出导致冗余循环的关键token,构建推理时惩罚器,再结合LoRA SFT、GSPO强化学习与On-Policy Distillation,最终将思考token削减58.3%、推理速度提升1.95倍,多数基准准确率损失控制在1%以内。其核心洞见在于区分"优化推理长度"与"强制缩短推理"——前者精准移除焦虑式循环,后者则以牺牲准确率为代价。模型已完整开源并提供免费研究API,是本地部署推理模型的开发者值得关注的方向。
AI推理模型的一个隐藏成本,是它们在解题过程中生成的大量冗余"思考"内容。新兴实验室 UkisAI 最近在 Reddit 上开源了 Swift-Qwen3.8-27B,声称通过后训练手段将思考 token 削减 58.3%、推理速度提升 1.95 倍,同时把准确率损失控制在 1% 以内。这套方法背后的思路,以及它为何不同于常见的"强制缩短推理",值得深入拆解。
问题起点:不是思考太长,而是"过度思考"
UkisAI 团队在运行量化版 Qwen3.8-27B 时,反复遇到一种令人困扰的现象——随机出现的推理循环,他们称之为"过度思考错误"(overthinking errors)。这些循环在中低推理强度设置下持续存在,表现出一种"焦虑式"的反复推演,看似在思考,实则对最终答案质量毫无贡献。
团队特别强调了一个核心论点:推理长度本身非常重要,不应被强行缩短,而应当被优化。这与市面上很多"压缩思考链"的做法形成鲜明对比。他们认为过度思考是一个独立于推理强度设置、chat 模板或 token 上限之外的问题——换言之,Swift 的训练方法是对现有 reasoning effort 机制的补充,而非替代。
有意思的是,团队最初以为这种循环只是低精度量化(PTQ)带来的副作用,但在实验中发现,即便是 BF16 全精度的同尺寸模型也普遍存在这一模式。这说明问题的根源更深,也让这套优化方法的适用范围更广。
技术路径:定位"过度思考token"并惩罚
UkisAI 的方法论借鉴了 Meta 的一篇论文,但直接套用时效果参差。团队意识到关键在于"锁定正确的关键词"和调参,于是动用 8×H100 集群,在编码、语言、视觉、智能体等多个分布外(OOD)领域生成了大量推理轨迹。
他们将带有过度思考的轨迹归类,找出其中的"共同分母" token,并针对最显著的那些构建了一个推理时惩罚器(inference-time penalizer)。这个惩罚器的表现明显优于论文中给出的原始 token 集合,且不仅对低精度模型有效,对 BF16 同样奏效。
从惩罚器到LoRA训练
最初的思路是用惩罚器生成轨迹后做交叉熵 SFT,但完全失败。团队转而用识别出的 token 构建损失函数,在此前生成的轨迹上运行 LoRA SFT。这一次推理长度显著下降,且这种缩减具备泛化能力——但准确率也随之下滑。
为了把准确率"救回来",他们尝试了多种方法,包括强化学习(GSPO)、On-Policy Distillation(在线策略蒸馏),以及 ThinkingCap 3.6 27B 的适配器分块。最终在几乎所有内部 OOD 测试中,将准确率损失恢复到 1% 以内。团队将 On-Policy Distillation 视为其"秘密武器"的关键一环。
基准测试:token减半,准确率基本持平
团队做了相当扎实的基准评测,每个 benchmark 都跑了 10 次(基座 5 次 + 带适配器 5 次),遵循 Qwen 3.6 27B 模型卡在 Terminal Bench 上的标准流程。以下是 xhigh 推理强度下的核心数据对比:
| Benchmark | Qwen3.8-27B | Swift-27B | Token节省 |
|---|---|---|---|
| GPQA-Diamond | 88.4% | 88.3% | 58% |
| LiveCodeBench v6 | 76.8% | 81.6% | 46% |
| Terminal-Bench 2.1 | 66.7% | 65.8% | 39% |
| MMLU-Pro | 85.5% | 85.0% | 28% |
| C-Eval | 90.0% | 90.6% | 19% |
| IFBench | 73.5% | 71.8% | 51% |
| AIME 2026 | 98.7% | 94.0% | 50% |
| HMMT | 99.3% | 96.0% | 46% |
| ERQA(视觉) | 67.5% | 66.3% | 55% |
多数任务上准确率波动在 1% 以内,个别甚至有提升。唯一明显的例外是 AIME 2026,准确率下降 4.6%——团队坦诚这是训练中的一个 bug,某个与数学推理相关的关键 token 被误惩罚,计划在后续版本修复。这种如实披露问题的做法,在开源项目中值得肯定。
xhigh vs medium 的关键对照
最能说明方法价值的是 GPQA-Diamond 上的三方对比:基座 xhigh 达到 88.4% 准确率但消耗 6,642 个中位 token;Swift xhigh 保持 88.3% 准确率,token 却降至 2,771,几乎腰斩;而基座 medium 虽然 token 更少(1,753),准确率却只有 84.1%。
换句话说,Swift 在不到一半 token 的情况下守住了 xhigh 的准确率,同时以约 1.6 倍的 token 代价,比 base-medium 高出 4 个百分点。这正验证了团队"优化而非缩短"的核心思路。不过 token 节省在不同推理强度下并不均匀:xhigh 平均减少 41%,medium 23%,low 26%,且 medium 和 low 档位伴随 1-4% 的准确率损失,仍需进一步测试。
生态与开源:模型、API与授权
UkisAI 把这个模型完整开源到了 Hugging Face,并提供了 Q1-Q8 的 GGUF 量化版本,社区还贡献了 Bartowski 量化、NVFP4、W4A16 乃至去审查(Uncensored)版本。在 Nvidia 提供 GPU 支持下,团队还开放了一个 OpenAI 兼容的免费研究用途 API,限速 5 RPM,方便算力不足的用户试用。
授权方面需要留意:许可证并非 Apache 2.0,但团队表示限制只针对年营收超过 100 万美元的公司,对绝大多数社区用户和研究者不构成障碍。作为一家新实验室,他们也保留了部分训练细节和数据不公开。
团队透露正在开发 Swift 3.8 Flash Next,目前已实现 -30% 思考 token 且维持 xhigh 准确率,他们将此视为方法论在 Qwen 系列上可复现的强信号,未来还计划扩展到其他模型家族。
值得关注的几点
这套工作的最大启发在于对"推理效率"的重新定义——真正的优化不是砍掉思考,而是精准移除那些不贡献答案质量的"焦虑式循环"。这与业界普遍的 token cap、强制截断思路有本质区别,也解释了为何 Swift 能在保持高推理强度准确率的同时大幅提速。
当然,目前所有数据均来自团队自评,社区独立复现结果尚待观察。AIME 上暴露的 token 误惩罚问题也提醒我们,基于 token 级别的干预存在精度风险。对于本地部署推理模型、又受困于算力成本的开发者而言,Swift-Qwen3.8-27B 仍是一个值得动手一试的方向。
相关推荐
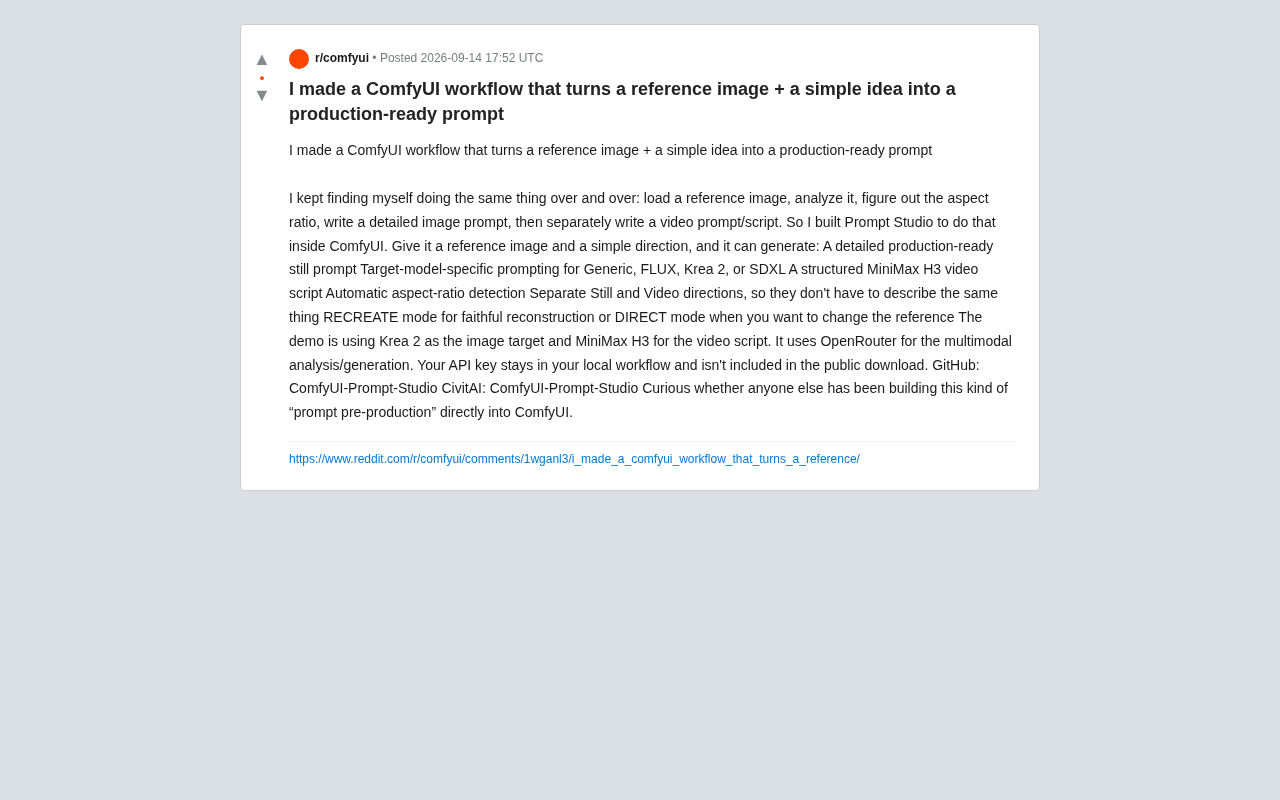
ComfyUI Prompt Studio:从参考图到可用提示词的工作流
ComfyUI Prompt Studio 是一款开源工作流工具,能从参考图和简单创意自动生成可投产的图像提示词、多模型定制提示和 MiniMax 视频脚本,支持忠实重建与自由创作两种模式。
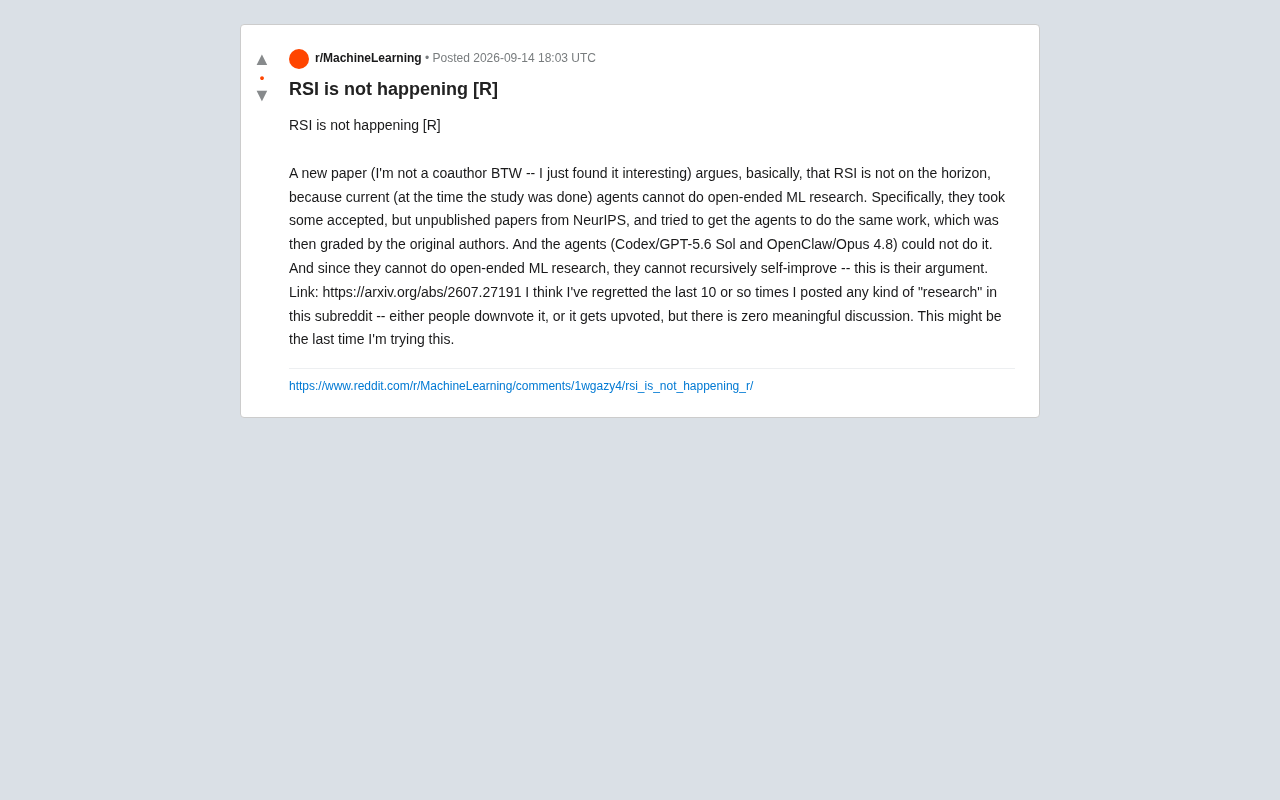
RSI短期不会发生?新论文用NeurIPS实验给出否定答案
一篇新论文让AI智能体重做未发表的NeurIPS论文并由原作者评分,结果显示当前智能体无法胜任开放式ML研究,据此论证递归自我改进(RSI)短期内不会发生。本文解析其实验设计、核心论证与局限。
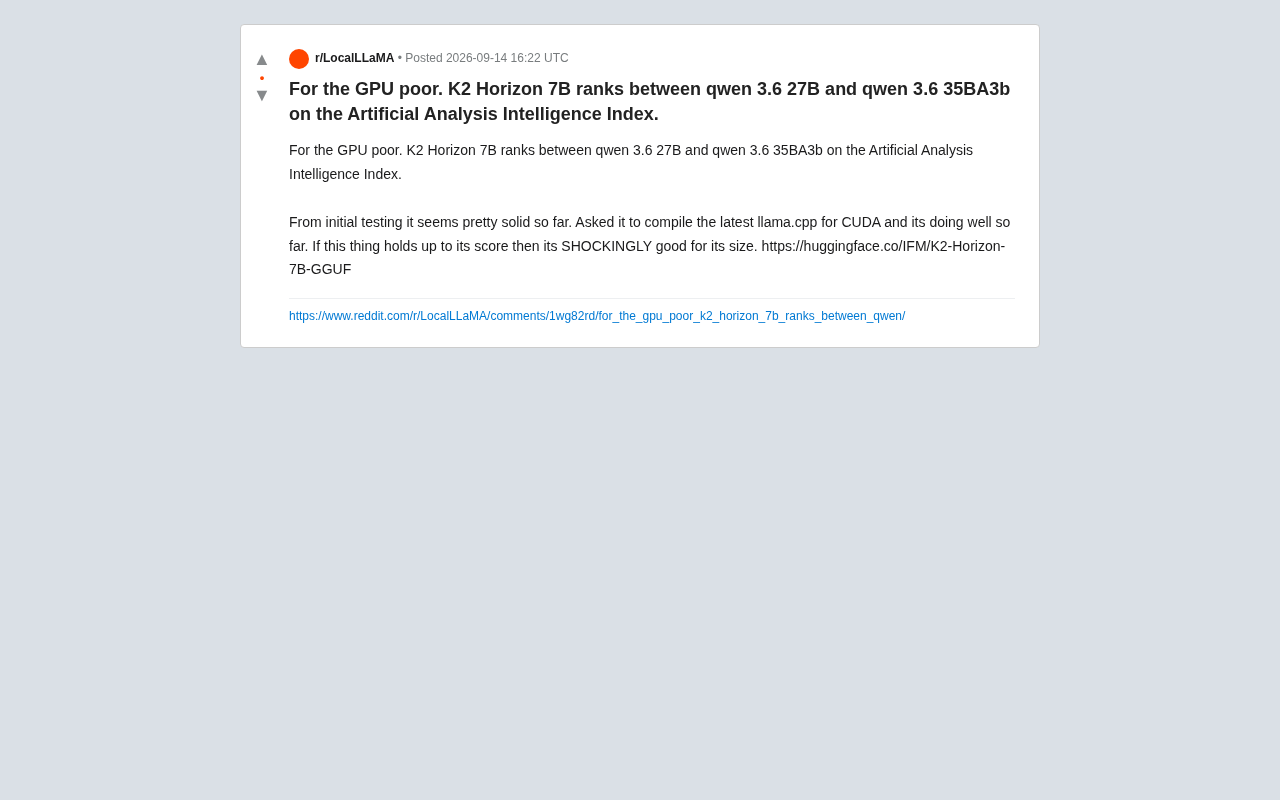
K2 Horizon 7B:小体量模型跑出中量级智能水平
K2 Horizon 7B 在 Artificial Analysis 智能指数上排名介于 Qwen 3.6 27B 与 35BA3b 之间,用 70 亿参数逼近数倍体量模型的表现,成为本地部署用户的高性价比选择。