K2 Horizon 7B:小体量模型跑出中量级智能水平
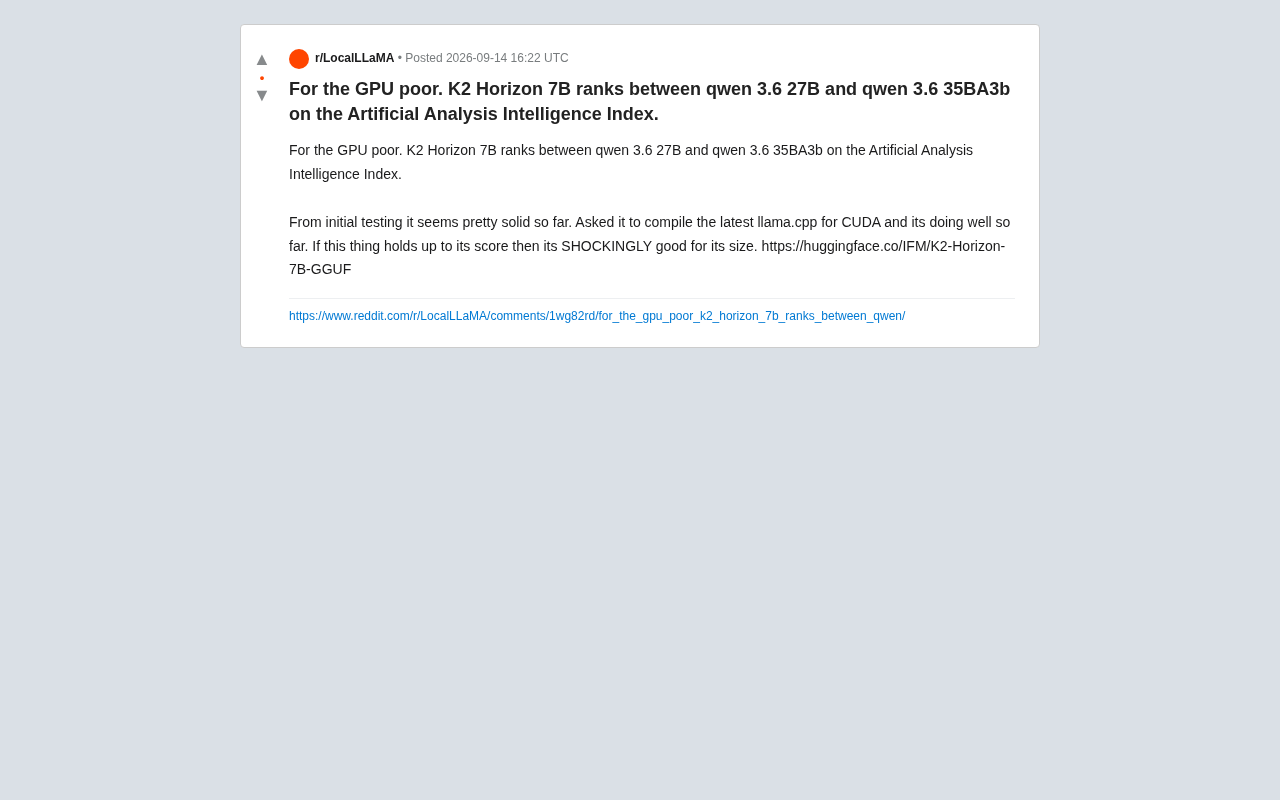
7B参数的K2 Horizon在综合基准上逼近27B级模型,为消费级硬件用户提供高性价比本地推理选项。
K2 Horizon 7B是一款面向"GPU穷人"的小参数量开源模型,凭借仅70亿参数在Artificial Analysis智能指数上取得了介于Qwen 3.6 27B与35BA3b之间的成绩,理论上实现了以四分之一参数逼近三至五倍体量模型的智能表现。模型以GGUF格式发布于Hugging Face,可直接配合llama.cpp、Ollama等主流本地推理工具部署,量化后通常只需8GB以下显存即可运行。发帖者实测其在处理CUDA编译llama.cpp这类复杂技术任务时表现稳健,评价为"考虑到体量好得惊人"。文章同时提示,基准排名是综合指标,不等于全场景优秀,真实价值仍需用户以自身典型任务横向对比验证。
一个为"GPU穷人"准备的小模型
在大模型军备竞赛不断堆参数、拼算力的当下,一款名为 K2 Horizon 7B 的小体量模型在 Reddit 本地部署社区引起了讨论。它的卖点直白而诱人:只有 70 亿参数,却在 Artificial Analysis Intelligence Index(人工智能分析智能指数)上取得了介于 Qwen 3.6 27B 和 Qwen 3.6 35BA3b 之间的成绩。
对于那些没有高端显卡、只能在消费级硬件上跑模型的用户——社区戏称的"GPU poor"群体——这样的性价比意味着他们有可能用一块普通显卡获得接近中量级模型的推理能力。模型已在 Hugging Face 上以 GGUF 格式发布(IFM/K2-Horizon-7B-GGUF),这种格式正是本地推理框架 llama.cpp 生态的主流选择。
排名背后意味着什么
要理解这个成绩的分量,需要先看清对比对象的体量差距。Qwen 3.6 27B 拥有约 270 亿参数,而 K2 Horizon 只有 70 亿——不到前者的三分之一。如果榜单成绩属实,意味着 K2 Horizon 用大约四分之一的参数量,逼近了三到五倍于自身规模模型的智能表现。
参数量直接关系到显存占用和推理速度。7B 级别的模型经过量化后,通常可以在 8GB 甚至更低显存的显卡上流畅运行,而 27B 以上的模型往往需要 24GB 以上显存或多卡配置。这种硬件门槛的差异,正是"小模型逼近大模型"话题的价值所在——它把高质量推理能力下放到了普通用户的桌面。
需要提醒的是,Artificial Analysis Intelligence Index 是一个综合基准,排名高不等于在所有任务上都表现优异。基准分数与真实使用体验之间往往存在差距,这也是社区用户强调要亲自测试的原因。
**量化(Quantization)**是让大模型在消费级硬件上可行的关键技术。它将模型权重从32位或16位浮点数压缩为4位、5位或8位整数,显存占用可降低至原来的四分之一到二分之一,推理速度也往往同步提升。以7B模型为例,FP16精度下约需14GB显存,而Q4量化版本只需约4-5GB,一块普通的8GB显卡即可流畅运行。代价是精度损失——量化位数越低,模型在细节推理上的表现越可能下滑,但在4-bit以上的量化级别中,多数任务的体验差距对普通用户并不明显。GGUF格式正是专为存储这类量化权重设计的容器格式,由llama.cpp项目主导开发,已成为本地部署社区的事实标准。
实测反馈:编译任务表现稳健
发帖者分享了自己的初步测试结果。他让 K2 Horizon 7B 处理一个相当实际的技术任务——为 CUDA 编译最新版本的 llama.cpp。据其反馈,模型"到目前为止表现不错",处理这类需要理解构建流程和依赖关系的任务时没有明显翻车。
这类测试比单纯跑基准更有说服力。编译开源项目涉及对命令行工具、编译选项、CUDA 环境的综合理解,能稳定给出可用建议的模型,通常在代码辅助场景下有实际价值。发帖者用了"SHOCKINGLY good for its size"(考虑到体量好得惊人)来形容——前提是它能在更长时间的使用中兑现榜单成绩。
小模型路线的现实意义
K2 Horizon 7B 的出现,延续了近期开源社区对"小而精"模型的持续探索。相比动辄数百亿参数的旗舰模型,7B 级别的模型在部署成本、响应延迟和隐私可控性上都有天然优势——本地运行意味着数据不出本机,也无需支付 API 调用费用。
对于开发者和爱好者而言,这类模型让"人人都能在自己电脑上跑一个够用的 AI 助手"从口号变成了可行方案。GGUF 格式的发布进一步降低了上手门槛,配合 llama.cpp、Ollama 等工具,即便是没有深度学习工程背景的用户也能快速部署。
当然,单一来源的社区反馈和一份基准排名还不足以给这款模型下定论。它在复杂推理、长上下文处理、多语言等维度的真实表现,仍需更多用户在不同场景下验证。但至少从目前的信号看,K2 Horizon 7B 值得关注小模型生态的人下载一试。
llama.cpp 是一个由Georgi Gerganov开发的开源C/C++推理框架,最初为在MacBook上运行LLaMA模型而创建,现已发展为支持数十种模型架构、覆盖CPU和GPU推理的通用引擎。Ollama 则是在llama.cpp之上构建的更高层封装工具,提供类似Docker的模型管理体验——用一行命令即可拉取并运行模型。这两款工具共同构成了本地AI部署生态的基础设施,使得非工程背景用户也能在分钟级别内完成从零到可用AI助手的全流程。K2 Horizon以GGUF格式发布,意味着它可以直接被这套生态无缝接入,无需额外转换步骤。
值得留意的几点
如果你打算尝试这款模型,有几点建议:优先根据自己的显存选择合适的量化版本;不要只看榜单分数,用自己的典型任务做实测;将它与同尺寸的其他 7B 模型横向对比,才能判断它是否真的"越级"。基准排名是起点,不是终点。
相关推荐
Claude与GPT操控机械臂绘画对决:谁更胜一筹?
一位开发者让Claude Fable 5.1与GPT 6 Astra分别操控同一台SO-101机械臂完成单色填充绘画任务,对比两款大模型在具身智能与动作控制上的表现。本文解析实验设计、评测维度及其对AI具身能力评估的启示。
2D引力沙盒实验:把万物扔进黑洞会发生什么?
开发者用AI助手Opus 5复活了一个搁置多年的2D引力沙盒项目《First Light》。基于three.js构建,支持移动端,可以绘制岩石、气体、恒星和黑洞并观察引力效果,甚至降落到自己创造的世界上。
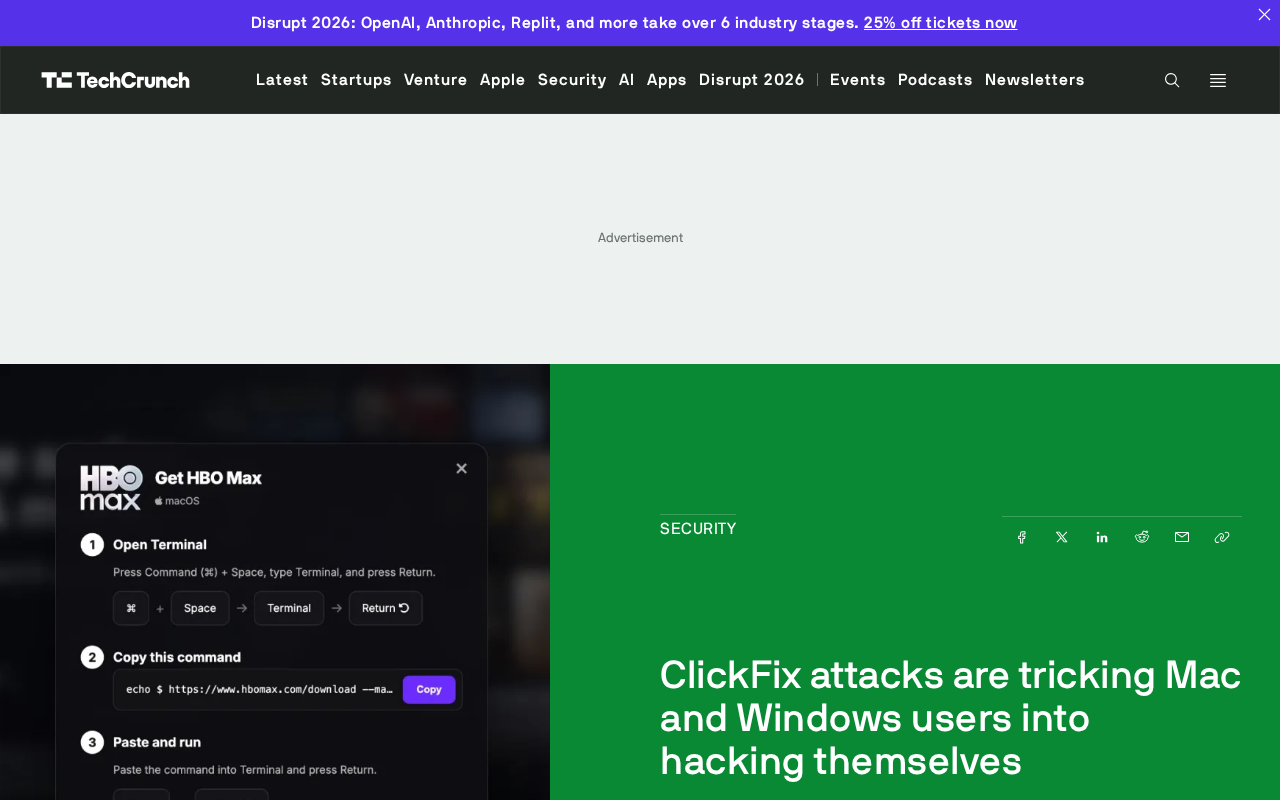
ClickFix攻击兴起:Mac与Windows用户如何被诱骗"自我入侵"
ClickFix是一种新兴网络安全威胁,通过伪装成HBO Max等品牌的虚假广告诱导Mac和Windows用户亲手运行恶意命令。本文解析其攻击原理、跨平台危害及实用防范建议。