System-1决策模型评测:快模型遇上严谨证据的真相

严格评测揭示System-1决策模型在Agent任务中存在显著短板,团队自审还将成本节省宣称从23.9%修正为4.3%。
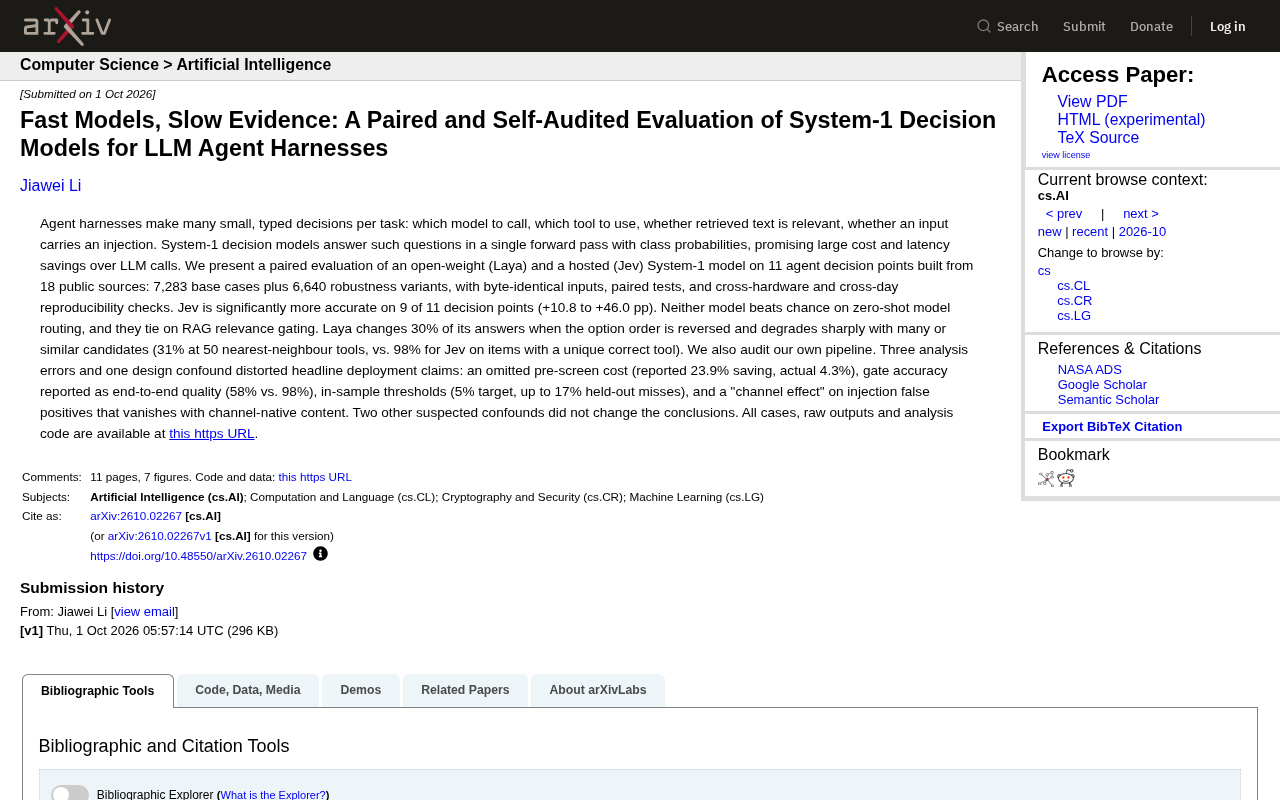
这篇研究对用于AI Agent快速决策的System-1轻量级分类模型进行了迄今较为严谨的对比评测,比较对象为开放权重模型Laya与托管服务模型Jev,覆盖11个Agent决策场景、逾1.3万个测试案例。结果显示托管模型Jev在9个决策点上显著领先,优势幅度达10至46个百分点;但两款模型在零样本模型路由上均未超过随机水平,鲁棒性测试中Laya在50个候选工具场景下准确率骤降至31%。研究最具价值之处在于团队对自身评测流程的主动自审——他们发现多处分析错误,将原本宣称的23.9%成本节省修正为实际4.3%,深刻揭示了AI评测中隐藏成本、指标混淆与样本内过拟合等常见陷阱,为工程团队提供了极具参考价值的方法论警示。
当Agent需要快速决策时
现代AI Agent在执行任务时,往往需要做出大量细小而明确的判断:该调用哪个模型、使用哪个工具、检索到的文本是否相关、输入是否携带了注入攻击。这些判断看似琐碎,却直接影响整个Agent系统的效率与成本。
传统做法是把这些判断交给大语言模型(LLM)来处理,但每次LLM调用都意味着可观的延迟与费用。于是,System-1决策模型应运而生——它们在单次前向传播中直接输出分类概率,承诺以极低的成本和延迟完成这些决策。这正是人类认知中"快思考"的机器版本。
一篇发表于arXiv的研究(arXiv:2610.02267)对这类模型进行了迄今较为严谨的配对评估,并罕见地对自己的评测流程进行了自我审计,揭示出不少值得警惕的问题。
"System-1"这一命名借用了心理学家丹尼尔·卡尼曼在《思考,快与慢》中提出的双系统理论:System-1代表快速、自动、直觉式的思考,System-2则代表缓慢、深思熟虑的推理。在AI Agent架构中,System-1决策模型通常是经过专门微调的小型分类器或轻量级语言模型(参数量往往在百亿以下),它们不进行多步推理,而是将输入直接映射到有限的输出类别(如"相关/不相关""调用工具A/B/C")。相比之下,GPT-4或Claude这类通用LLM在做同类判断时需要完整的自回归解码过程,单次调用延迟往往在数百毫秒到数秒之间,成本也高出数个数量级。正因如此,System-1模型被视为在Agent流水线中替代LLM进行"路由与过滤"决策的候选方案。
两款模型的正面交锋
研究团队选取了两款代表性的System-1模型进行对比:一款是开放权重的 Laya,另一款是托管服务型的 Jev。评测覆盖了11个Agent决策点,数据来自18个公开来源,共构建了7,283个基础案例,外加6,640个鲁棒性变体。
为了保证结论的可靠性,研究采用了严苛的实验设计:字节级别完全相同的输入、配对统计检验,以及跨硬件、跨日期的可复现性校验。这种做法在AI评测中并不常见,却恰恰是检验模型真实能力的关键。
准确性差距显著
结果显示,托管模型 Jev 在11个决策点中的9个上显著更准确,优势幅度从 +10.8 到 +46.0 个百分点 不等。这是一个相当大的性能鸿沟,说明托管模型在工程打磨和数据覆盖上确实占据优势。
两个共同的软肋
但两款模型都暴露出了弱点。在零样本模型路由任务上,两者的表现都没能超过随机猜测——这意味着让System-1模型来决定"该调用哪个大模型"目前并不可靠。在 RAG相关性门控(判断检索文本是否相关)任务上,两者打成平手,谁也没有明显优势。
RAG(Retrieval-Augmented Generation,检索增强生成)是目前主流的知识增强方案:在生成回答前,系统先从外部知识库中检索若干候选文本片段,再将其拼入上下文供LLM参考。然而并非所有检索结果都真正相关,将无关内容塞入上下文不仅浪费Token,还会干扰模型判断,引发所谓"上下文污染"。因此,在检索结果进入LLM之前,往往需要一个"相关性门控"步骤来过滤噪声。这一步骤如果由System-1模型承担,理论上可以在极低延迟下完成过滤;但本研究显示两款模型在此任务上旗鼓相当且均未展现出决定性优势,意味着相关性判断的难度超出了轻量级分类器的能力边界。
鲁棒性:开放模型的脆弱面
开放权重模型 Laya 在鲁棒性测试中表现堪忧。当选项顺序被颠倒时,它会改变 30% 的答案——这说明模型的判断在很大程度上依赖于选项的排列位置,而非内容本身的实质。
更严重的是在候选项增多或相似度增高的场景下的崩溃。当面对50个最近邻工具时,对于那些存在唯一正确工具的任务,Laya的准确率骤降至 31%,而 Jev 仍能保持 98% 的高水平。这一对比凸显出:在真实的、充满干扰项的Agent环境中,模型的稳定性可能比峰值准确率更重要。
最值得关注的:评测自审
这篇研究最具价值的部分,是团队对自身评测流程的严格审计。他们主动找出了三处分析错误和一处设计混淆,这些问题都曾扭曲了最初的部署收益宣称:
- 被遗漏的预筛选成本:原本报告的23.9%成本节省,修正后实际仅为 4.3%。这几乎是数量级的差距,提醒我们在计算收益时必须纳入所有隐藏环节。
- 门控准确率被误当成端到端质量:报告中的58%与真实端到端的98%存在巨大偏差,混淆了局部指标与整体效果。
- 样本内阈值问题:设定5%目标时,在留出集上的漏检率最高可达 17%,说明阈值在训练数据上的表现无法直接外推。
- 注入误报的"通道效应":这一效应在使用通道原生内容后便消失了,表明它是实验设计的伪影而非真实现象。
团队还提到,另外两处可疑的混淆因素经核查并未改变最终结论。这种坦诚的态度,在当下充斥着夸大宣称的AI评测领域显得尤为难得。
"样本内阈值"问题是机器学习评测中的经典陷阱,值得展开说明。在二分类场景(如判断是否存在注入攻击)中,研究者通常需要选定一个概率阈值来决定输出"是"还是"否"。若该阈值是在训练集或验证集上通过优化目标(如将假阳性率控制在5%以内)搜索得到的,则它天然对这批数据过拟合——模型恰好在这些样本上的置信度分布符合该阈值的假设,但换到真实部署环境中,分布可能发生偏移,导致实际漏检率远超预期。本研究中留出集上17%的漏检率与5%目标之间的巨大落差,正是这一机制的直接体现。这提示工程团队:阈值必须在与训练数据完全独立的保留集上验证,且应针对预期的部署分布进行校准。
对实践者的启示
这项研究传递出几个清晰的信号。System-1决策模型确实能在部分Agent决策任务上提供价值,但它并非万能——模型路由和相关性门控仍是难啃的硬骨头。
在选型上,托管模型目前在准确性和鲁棒性上领先,但开放权重模型的透明度和可控性仍有其价值,前提是要充分测试其在干扰项增多时的稳定性。
更深层的教训在于评测本身。所谓"Fast Models, Slow Evidence"(快模型,慢证据)的标题一针见血:模型可以很快,但支撑部署决策的证据必须经得起反复推敲。隐藏成本、指标混淆、样本内过拟合,这些陷阱会让表面光鲜的收益数字严重失真。
研究团队将所有案例、原始输出和分析代码开源在 GitHub(David-DL-Space/sys1-eval),为后续研究提供了可复现的基础。对于正在构建Agent系统的工程团队而言,这是一份极具参考价值的方法论样本。
相关推荐

Cursor AI编程工具保姆级教程:下载、模式与模型选择全解析
Cursor AI编程工具保姆级教程:从下载安装、界面布局到Agent/Ask/Manual三种模式解析,以及GPT、Claude大模型选择建议,帮你快速上手这款强大的AI代码编辑器。

Cursor Projects深度解读:云端代理会终结Claude Code吗
Cursor Projects通过云端代理解决上下文衰减问题,支持多代理并行、完整开发闭环和真实软件交付。本文解读其工作机制、实测观察,并分析它能否真正挑战Claude Code与ChatGPT Codex。

Cursor创始人深度对话:代码之死与"品味"的崛起
Cursor创始人Michael Truell深度对话:解析AI编程的真实瓶颈、"vibe coding"为何在专业开发中行不通,以及为什么"品味"将成为未来工程师唯一不可替代的能力。附AnySphere从CAD到90亿估值的创业历程。