TempoPFN:线性RNN合成预训练,实现零样本时间序列预测

TempoPFN 用合成时间序列预训练线性 RNN,实现零样本预测并开源。
TempoPFN 是 NeurIPS 2026 接收的时间序列基础模型工作,其核心是一套合成时间序列生成器与增强方法库。与语言模型依赖互联网文本不同,时间序列缺乏统一预训练语料,TempoPFN 选择主动合成具有多样统计特性的序列,绕开真实数据领域覆盖不全与获取成本高的问题。被预训练的模型是线性 RNN,以线性推理复杂度适配长序列与高吞吐场景,目标是在未见数据集上直接零样本预测。其合成数据已被 Toto-2 和 TS-ICL 采用,显示出基础设施价值。论文、代码与模型权重均已开源,定位为研究基础设施而非端到端产品。
时间序列预测正迎来「基础模型时刻」。Reddit 上引发讨论的 TempoPFN 提出了一条反直觉的路径:不依赖海量真实数据,而是用精心设计的合成时间序列预训练一个线性 RNN,让模型在从未见过的数据集上直接完成零样本预测。该工作已被 NeurIPS 2026 接收,并已开源库、模型权重与论文。
核心思路:用合成数据代替真实语料
据作者团队(Vladyslav Moroshan、Julien Siems、Arber Zela、Timur Carstensen、Frank Hutter)介绍,TempoPFN 的核心贡献是一套合成时间序列生成器与增强方法库,专门用于训练时间序列基础模型。与语言模型依赖互联网文本不同,时间序列领域缺乏统一的「预训练语料」,TempoPFN 选择主动合成:通过可控的生成器构造具有多样统计特性的序列,让模型在预训练阶段就见识足够丰富的模式。
这一思路的价值在于绕开了真实数据的两大痛点——领域覆盖不全与获取成本高。生成器的库化设计意味着研究者可以按需组合、扩展,而不是被单一数据集绑定。
基础模型(Foundation Model) 通常指在大规模、多样化数据上预训练、可通过少量适配甚至零样本迁移到下游任务的模型。语言模型中这一范式已成熟,但在时间序列领域长期缺乏统一的大规模预训练语料,导致模型往往针对单一数据集或单一领域训练。TempoPFN 的合成预训练正是试图在时间序列领域复制「大规模预训练 + 下游迁移」的路径:用可控生成器替代真实语料,让模型在预训练阶段获得跨领域的模式覆盖,从而具备零样本泛化能力。
为什么选线性 RNN 而非 Transformer
论文中被预训练的模型是一个线性 RNN。在 Transformer 主导基础模型的当下,这一选择颇具针对性:时间序列往往很长,注意力机制的二次复杂度在长序列上代价高昂;线性 RNN 在推理时具备线性复杂度,更适合长上下文与高吞吐的预测场景。
合成预训练与线性结构的组合,瞄准的是「零样本」这一目标——模型不针对特定数据集微调,直接在新序列上给出预测。这对实际部署意义明显:用户不必为每个新业务序列重新训练模型。
线性 RNN 指状态转移不含非线性激活函数的循环网络,其隐状态更新可写成 (h_t = A h_t + B x_t) 的形式。这类结构的关键优势是训练与推理都可借助并行扫描或卷积核高效计算,且推理复杂度随序列长度线性增长。与经典非线性 RNN 相比,线性 RNN 的表达能力受限,但换来的是长序列上的效率与稳定性;与 Transformer 相比,它避免了注意力机制的二次复杂度。近期在状态空间模型(如 Mamba 系列)研究中,线性递归结构重新受到关注,TempoPFN 将其用于时间序列基础模型,正是看中长上下文预测场景下的效率优势。
已被 Toto-2 与 TS-ICL 采用
一个值得关注的信号是,Reddit 帖子提到该合成数据已被 Toto-2 和 TS-ICL 使用。这说明 TempoPFN 的贡献不止于单个模型,其生成器库正在成为时间序列基础模型训练的基础设施之一。对社区而言,可复用的数据生成管线往往比单个 checkpoint 更具长期价值。
Toto-2 是 Datadog 推出的时间序列基础模型系列,主打面向可观测性与监控场景的预测;TS-ICL 则聚焦时间序列的上下文学习(In-Context Learning),即让模型在不更新参数的情况下,仅凭输入上下文完成新任务的预测。两者都依赖大规模、多样化的预训练数据,TempoPFN 的合成生成器库被它们采用,说明该库在时间序列基础模型训练中已具备跨团队的复用价值。对社区而言,这种「数据配方」层面的共享,往往比共享单个模型权重更能推动领域整体进展。
开源资源与上手路径
作者同步放出了完整资源:论文在 arXiv(2510.25502),代码在 GitHub 的 automl/TempoPFN 仓库,模型权重托管于 Hugging Face 的 AutoML-org/TempoPFN。三个入口覆盖了「读方法—跑代码—直接用模型」的完整链路,对想复现或在此基础上做二次开发的研究者较为友好。
从定位看,TempoPFN 更接近一个研究基础设施而非端到端产品:生成器库用于造数据,线性 RNN 用于验证合成预训练的有效性,零样本预测则是检验成果的任务形态。
值得思考的几个问题
合成数据的多样性边界在哪里,决定了模型能泛化到多「野生」的真实序列;线性 RNN 在表达能力上的取舍,是否会在某些强非线性的序列模式上暴露短板;以及当合成预训练被多个模型复用时,社区是否会形成类似 NLP 的「数据配方」共识。这些问题的答案,可能要等更多基于该库的后续工作来揭晓。
相关推荐
一人量产90集AI漫剧:10小时10块钱的完整制作流程
没有编剧经验也能做AI漫剧:10小时10块钱成本,红果平台单部收益4200元。本文拆解从AI生成剧本、分镜脚本到成片的六步完整流程,附万能提问公式和新手避坑指南。
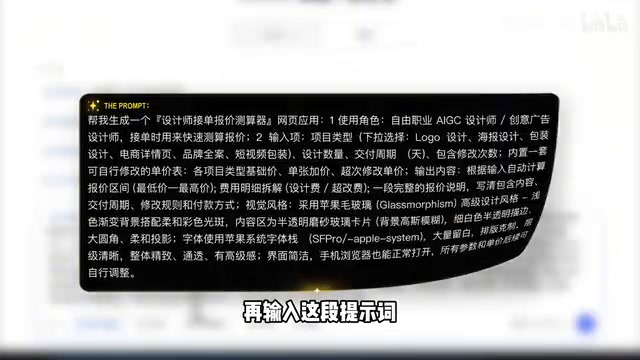
豆包Agent自制报价测算器:接单报价告别凭感觉
B站UP主用豆包Agent零代码自制报价测算器,输入项目类型、数量、周期即可自动生成报价明细,支持加急与版权买断费率,一键复制发客户,手机端也能随时报价。
WorkBuddy实战教程:10个Agent项目从入门到简历级
WorkBuddy 实战教程解析:用中文交代任务的 AI 工作助手,配置环境比 Codex、Claude Code 更简单。10 个 Agent 实战项目覆盖文件整理、表格汇整、网页生成,新手三步上手,学完可写进简历。