TextSphere:共享超球面对齐实现高效文生图

TextSphere 将超球面采样与 CLIP 文本条件结合,实现少步数高质量文生图。
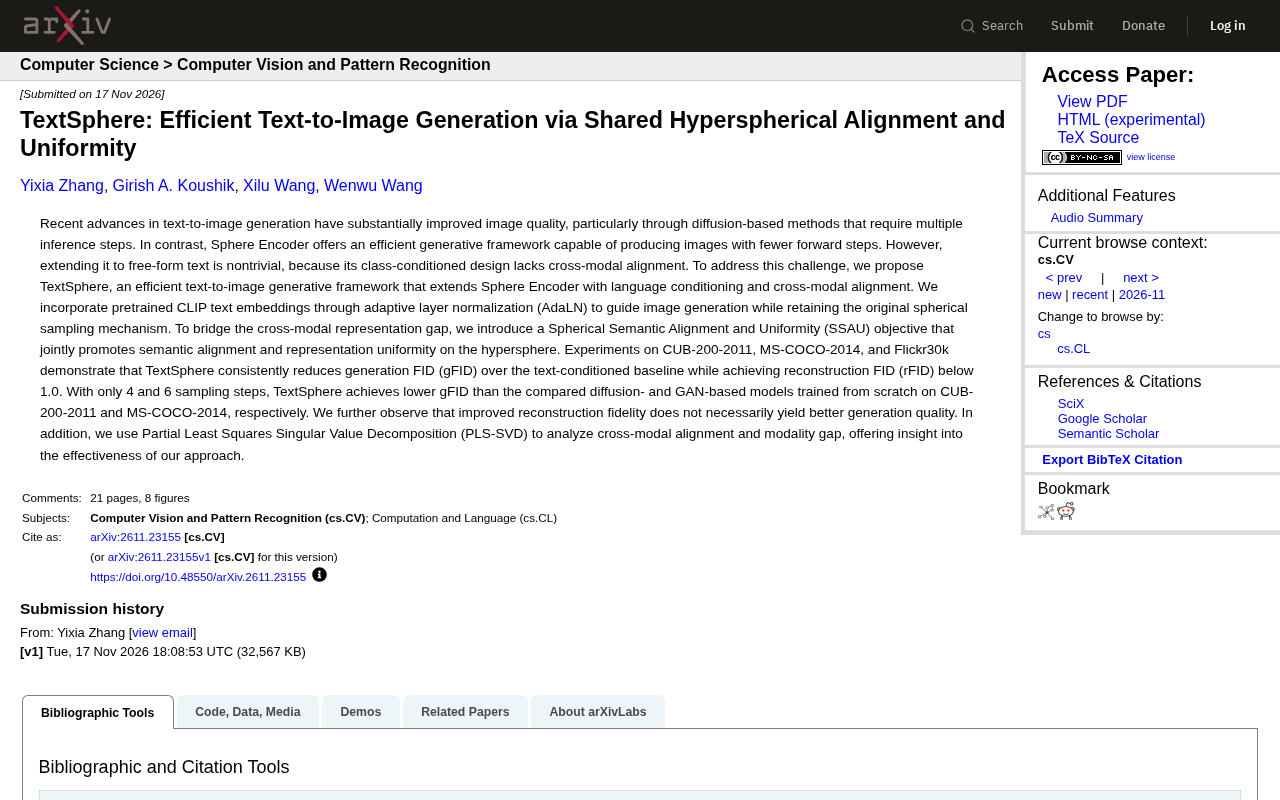
TextSphere 针对 Sphere Encoder 只能处理类别标签的局限,提出用 AdaLN 注入预训练 CLIP 文本嵌入,在保留球面采样机制的同时实现自由文本条件生成。为弥合跨模态表示差距,论文设计了 SSAU 目标,在超球面上联合优化语义对齐与表示均匀性,兼顾条件准确性与生成多样性。在 CUB-200-2011、MS-COCO-2014 和 Flickr30k 上的实验表明,仅用 4 步和 6 步采样即可取得低于对比扩散模型和 GAN 模型的 gFID,rFID 低于 1.0。论文还发现重建保真度提升不必然带来生成质量提升,并用 PLS-SVD 从几何层面解释了模态差距的压缩过程。
扩散模型推动了文生图质量的大幅提升,但其代价是多次迭代推理带来的高延迟。Sphere Encoder 提供了一条更高效的路径——用更少的前向步骤生成图像,却受限于类别条件设计,无法处理自由文本输入。TextSphere 的核心思路,是把 Sphere Encoder 的超球面采样机制与语言条件结合,并用一个共享的超球面对齐目标填补跨模态表示的鸿沟。
从类别条件到自由文本:需要解决什么
Sphere Encoder 的高效来自在超球面上进行采样,但它的条件输入是离散类别标签,而非自由形式的文本描述。要把它扩展到文生图,至少面临两个障碍。
其一是条件注入方式。TextSphere 选择通过自适应层归一化(AdaLN)引入预训练的 CLIP 文本嵌入来引导图像生成,同时保留原有的球面采样机制。这样既复用了 CLIP 已经学到的语言表示,又不破坏 Sphere Encoder 的高效生成路径。
其二是跨模态表示差距。文本嵌入和图像表示处在不同的语义空间中,直接拼接或简单条件化往往导致对齐不足。TextSphere 的应对方式是引入一个专门的训练目标,而非仅靠架构改动。
自适应层归一化(AdaLN) 是一种条件注入机制,它不直接拼接条件向量,而是用条件信息动态缩放和偏移归一化层中的激活值。具体而言,给定文本嵌入 (c),AdaLN 通过一个可学习的投影生成两组参数 (\gamma(c)) 和 (\beta(c)),对特征图做逐通道的仿射变换:(\text{AdaLN}(h, c) = \gamma(c) \cdot \frac{h - \mu}{\sigma} + \beta(c))。相比交叉注意力,AdaLN 参数开销更小、训练更稳定,且不会改变主干网络的序列结构,因此特别适合需要保留原有采样路径的高效生成框架。TextSphere 选择 AdaLN 而非交叉注意力,正是为了在注入 CLIP 文本条件的同时,不破坏 Sphere Encoder 的球面采样几何。
SSAU:对齐与均匀性的联合目标
TextSphere 提出的球面语义对齐与均匀性目标(Spherical Semantic Alignment and Uniformity,SSAU),在超球面上同时优化两件事:语义对齐和表示均匀性。
语义对齐让文本嵌入与对应图像表示在球面上相互靠近,这是跨模态条件生成的基础。均匀性则约束表示在球面上的分布不要坍缩到局部区域,从而保留生成多样性。把两者放在同一个球面几何框架下联合优化,是该工作的关键设计——对齐负责"说得准",均匀性负责"生得开"。
这一目标与 Sphere Encoder 原有的球面采样机制在几何上是一致的,因此不需要对生成框架做根本性重构。
表示均匀性(Uniformity) 是对比学习领域提出的一个度量,用于衡量特征向量在单位超球面上的分布是否过于集中。其典型形式为 (\mathcal{L}{\text{uniform}} = \log \mathbb{E}{x,y} e^{-t |f(x)-f(y)|^2}),值越小表示表示越分散。在生成模型中,均匀性不足会导致模式坍缩——模型反复生成少数几种样本,多样性下降。SSAU 将均匀性约束引入超球面采样空间,与语义对齐项联合优化,本质上是给生成过程加了一个几何正则项,防止条件化后的表示挤占球面的局部区域,从而在少步数采样下仍能覆盖较广的生成分布。
实验表现:少步数下的竞争力
论文在 CUB-200-2011、MS-COCO-2014 和 Flickr30k 三个数据集上进行了验证。主要结论有三点。
第一,TextSphere 在文本条件基线上持续降低生成 FID(gFID),并将重建 FID(rFID)压到 1.0 以下。
第二,在采样步数极少的情况下,它依然具备竞争力:仅用 4 步和 6 步采样,TextSphere 在 CUB-200-2011 和 MS-COCO-2014 上的 gFID 分别低于从零训练的对比扩散模型和 GAN 模型。这一点直接指向实际部署中的推理成本问题——少步数意味着更低的延迟。
第三,论文观察到一个反直觉现象:更好的重建保真度并不必然带来更好的生成质量。这说明在评估这类高效生成框架时,rFID 与 gFID 需要分开看待,不能把重建能力当作生成能力的代理指标。
FID(Fréchet Inception Distance) 是评估生成图像质量的常用指标,计算真实图像与生成图像在 Inception 网络特征空间中的两个高斯分布之间的 Fréchet 距离,数值越低表示两者分布越接近、生成质量越高。本文区分了 rFID 与 gFID:rFID(reconstruction FID)衡量模型对给定输入的重建能力,gFID(generation FID)衡量模型自由生成新样本的能力。在少步数生成框架中,重建保真度和生成质量可能脱钩——模型可以很好地还原训练样本,却无法在球面上采样出多样且合理的新图像。因此,把 rFID 与 gFID 分开报告,能更准确地刻画高效生成框架的真实能力边界。
PLS-SVD 视角下的模态差距
除了指标对比,TextSphere 还用偏最小二乘奇异值分解(PLS-SVD)分析跨模态对齐和模态差距,为方法有效性提供几何层面的解释。
这类分析的价值在于,它不只回答"指标是否更好",还试图说明"为什么更好"——跨模态表示在超球面上的分布如何随 SSAU 目标变化,模态差距在训练中如何被压缩。对于关注表示学习与生成模型交叉方向的研究者,这部分提供了可复用的分析工具。
偏最小二乘奇异值分解(PLS-SVD) 是一种用于分析两组多变量数据之间关联结构的降维方法。它先通过偏最小二乘寻找使两组变量协方差最大的投影方向,再对投影后的矩阵做奇异值分解,从而提取出跨模态共享的潜在因子。在跨模态表示分析中,PLS-SVD 可以把文本嵌入和图像表示投影到同一低维子空间,观察两者在子空间中的重叠程度与残余差异——后者即所谓“模态差距”。相比 PCA 或 CCA,PLS-SVD 更侧重于最大化跨模态协方差,因此能更直接地量化文本条件与图像生成表示之间的对齐质量,为 SSAU 目标的有效性提供几何层面的证据。
效率与质量的再平衡
TextSphere 的意义不在于刷新某个榜单,而在于验证了一条路线:用几何约束(超球面对齐与均匀性)替代大量采样步骤,可以在保持生成质量的同时显著压缩推理成本。
它与扩散模型的关系更接近互补而非替代——扩散模型追求质量上限,TextSphere 这类框架探索的是少步数下的质量下限能推到多高。对于需要在延迟敏感场景中部署文生图能力的应用,少步数生成框架的每一次质量提升都直接对应可用性的提升。
论文同时留下的开放问题是:当重建保真度与生成质量出现背离时,应该如何设计训练目标与评估体系。这个问题的答案,可能比单一模型的指标提升更影响后续研究的方向。
相关推荐
哈佛AI安全课程CS 2881R引热议
哈佛大学CS 2881R AI Safety课程在Hacker News被提及,本文介绍课程背景、AI安全的核心议题及对学习者的启示,帮助理解顶尖高校如何培养AI安全人才。

拓展社交圈:值得尝试的几款交友应用
交友应用怎么选?本文梳理朋友发现平台BFF与活动导向应用Timeleft等不同定位的友谊类应用,分析两类思路的适用人群,并给出线下见面安全与预期管理的实用建议。
为什么不该在个人电脑上运行Hermes智能体
为什么不应该在个人电脑上运行Hermes等自主AI智能体?本文从安全风险、资源占用、凭证泄露和自主性需求四个角度,分析为何应将智能体部署到独立VPS而非主力设备,并给出隔离部署的实践逻辑。