The Library:用查询组织业务上下文,让AI回答有据可依
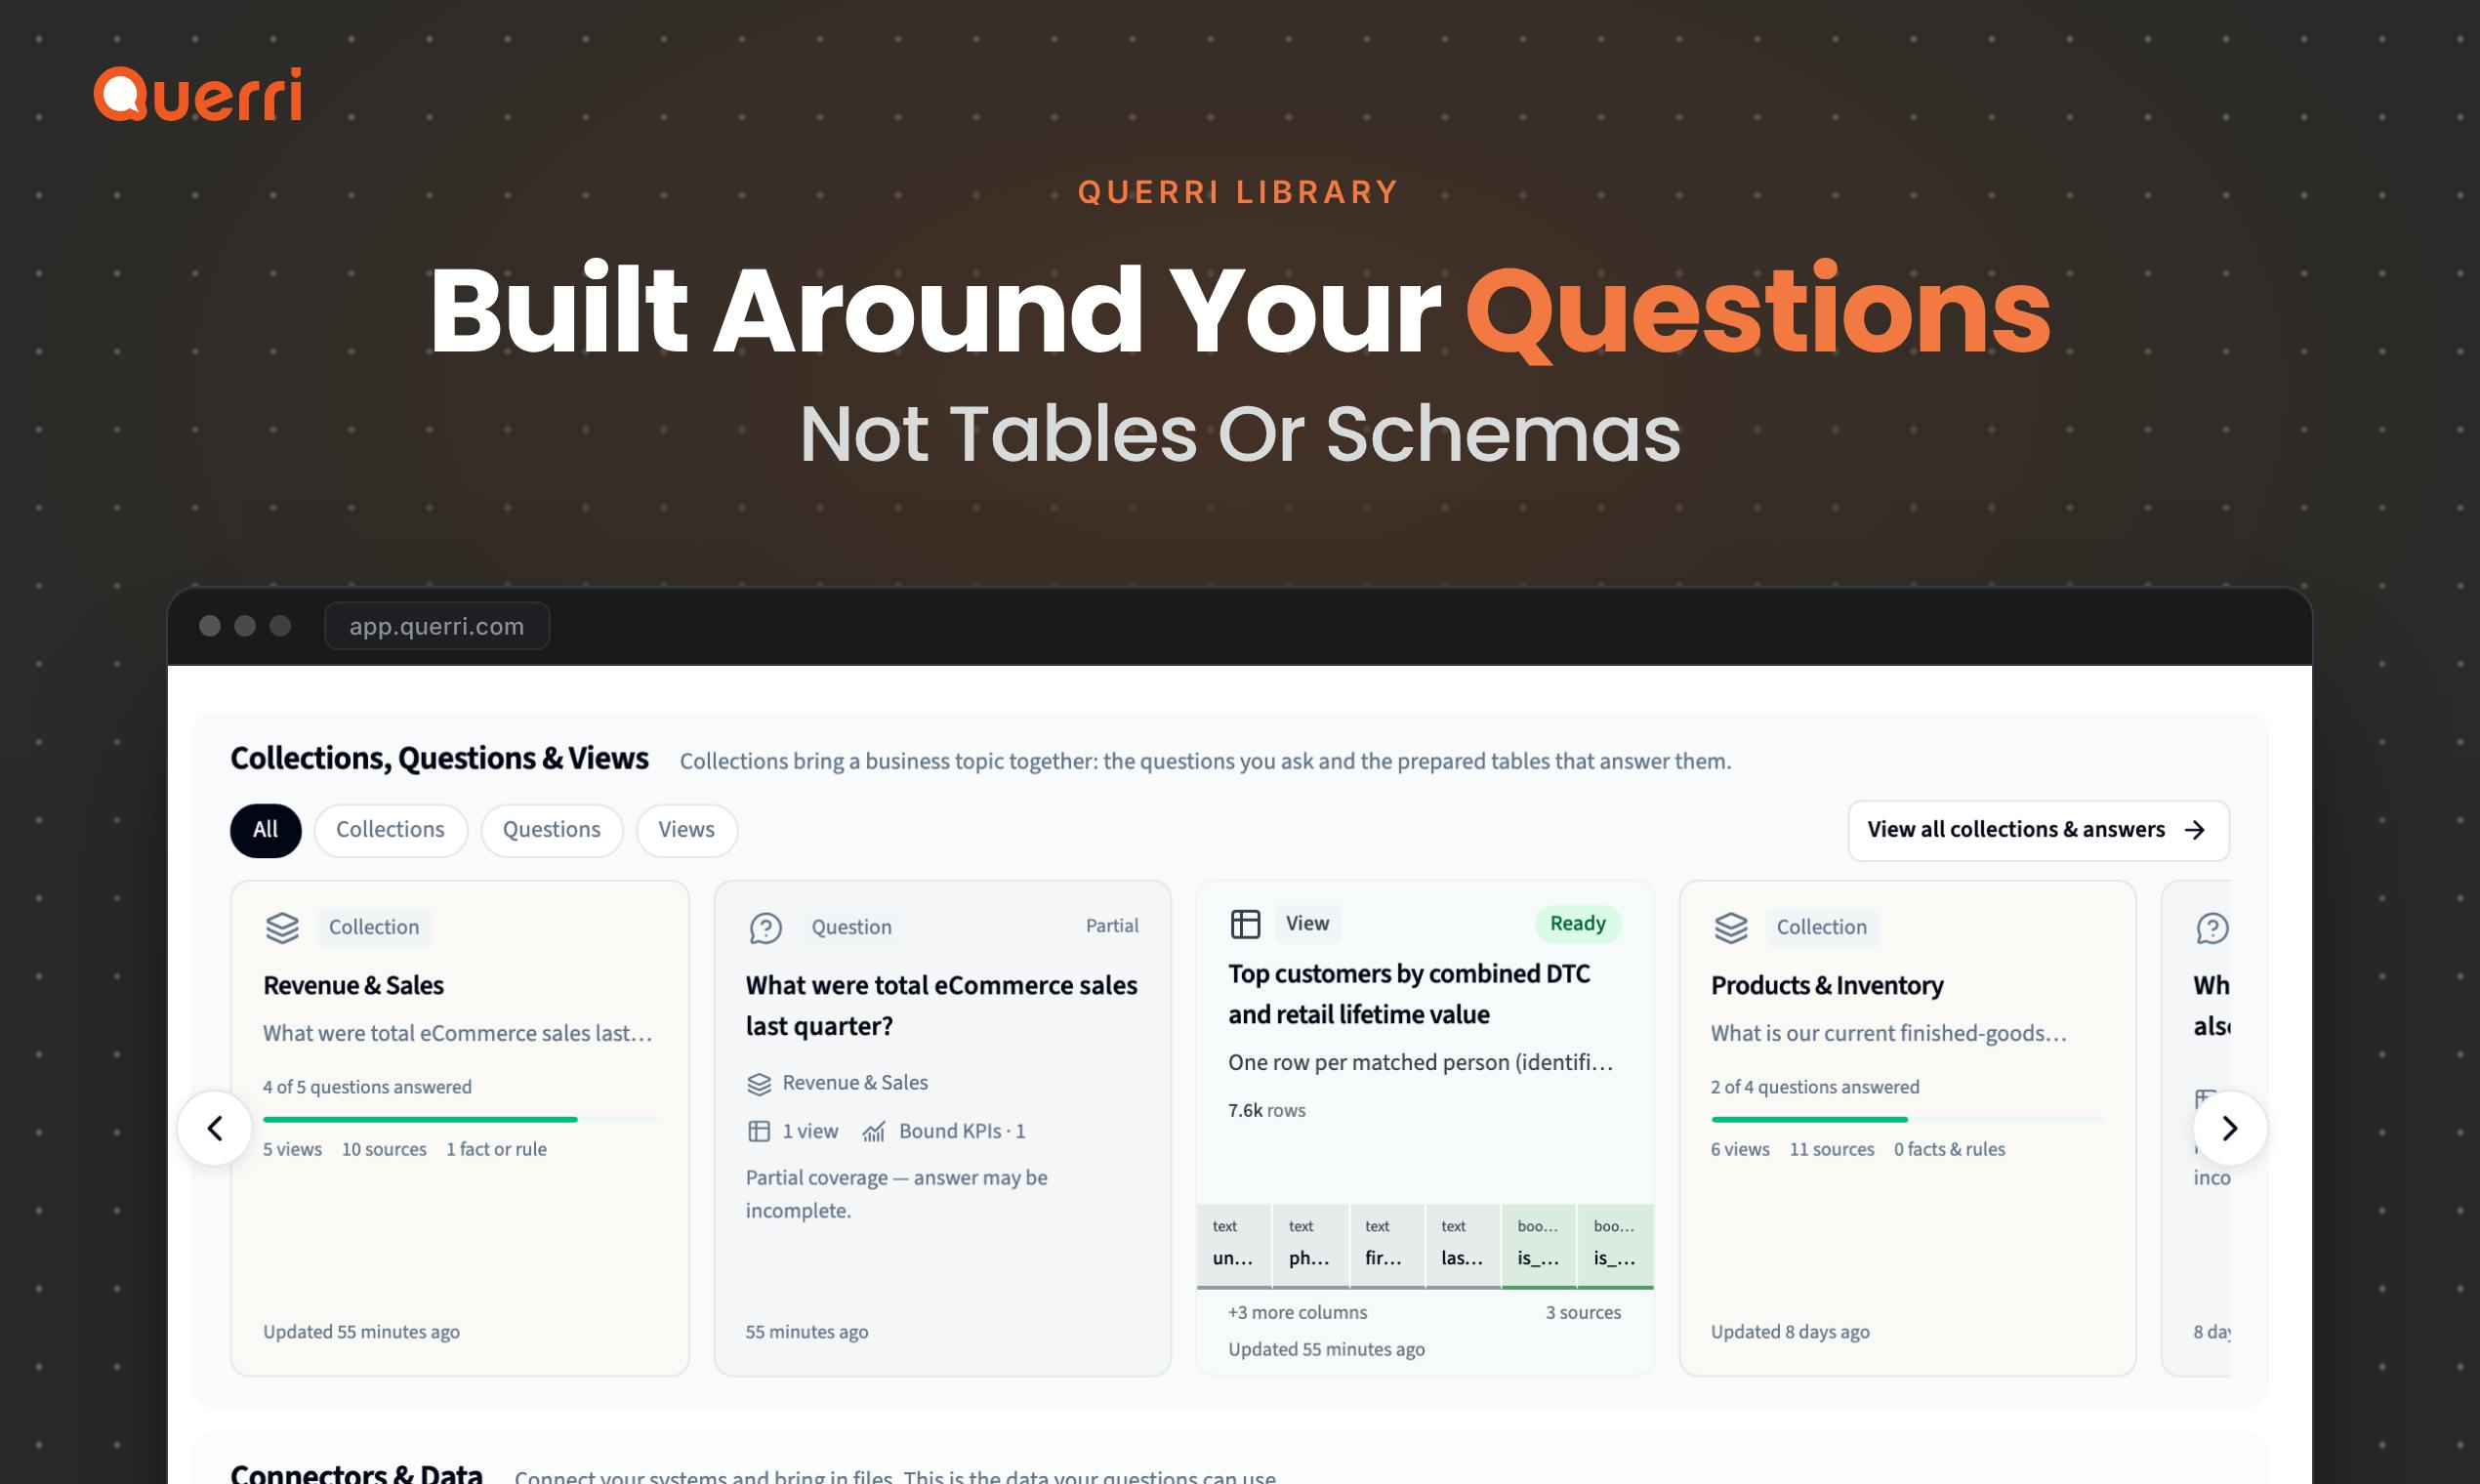
The Library 以查询为单位组织业务上下文,让 AI 回答有据可依、不知道时不编造。
The Library 是 Querri 推出的一款企业级 AI 分析产品,核心思路是以“查询”为单位组织业务上下文,把数据、指标定义和历史分析围绕问题沉淀为共享可信底座。其最受关注的设计是:当 AI 不知道答案时会直接说明,而非编造,直击企业分析场景中的大模型幻觉痛点。产品在 Product Hunt 获得 122 票、排名当日第三,反映出业务上下文管理方向的真实需求。文章同时指出,这类产品面临业务定义持续变化、上下文需要长期维护的挑战,能否平衡易用性与准确性仍需实践验证。
The Library:用查询组织业务上下文,让AI回答有据可依
当企业把AI接入数据分析,最头疼的往往不是模型能力,而是它“不懂业务”。同一个指标,销售部和财务部的定义可能不同;一次分析得出的结论,换个人再问就变了样。Product Hunt上排名第三的 The Library,试图用“查询”作为组织业务上下文的单位,让AI的每个回答都建立在共享、可信的数据基础上。
产品定位:把业务上下文围绕“问题”组织起来
The Library 来自 Querri,官方定位是“你的业务上下文,按查询组织”。它的核心思路并不复杂:企业在经营中会不断提出各种问题——本月复购率是多少、哪个渠道的获客成本最高、某产品线的毛利变化趋势如何。The Library 把这些查询作为组织数据的入口,让数据、定义和分析围绕问题沉淀下来,而不是散落在不同的报表和文档里。
这样做的直接好处是,同一个问题无论谁去问、什么时候问,答案都来自同一个共享底座。Product Hunt 页面上给出的描述是,Library 会学习企业的定义、业务上下文和过往分析,让回答“扎根于业务实际运作的方式”。
AI 回答可信的关键:知道自己不知道
在所有产品宣传里,最值得关注的一点是 The Library 对“不知道”的处理方式。官方明确表示:当它不知道时,会直接说出来,而不是编造。
这看似是产品细节,实际上击中了企业级AI应用的核心痛点。大模型幻觉在消费场景里或许只是体验问题,在商业分析场景里却可能直接导致错误决策。一个敢说“我不知道”的分析助手,比一个永远给出流畅答案的工具更有长期价值——前者让使用者知道边界在哪里,后者则需要额外花精力去验证每一句话。
The Library 的做法是把回答锚定在已沉淀的业务定义和历史分析上。回答有据可查,不确定时坦白,这种设计取向比单纯追求回答覆盖率更务实。
大模型幻觉(Hallucination) 是指大语言模型生成看似合理、流畅,但事实上错误、无依据或与输入不符内容的现象。其成因包括训练数据中的噪声、模型倾向于补全缺失信息的概率生成机制,以及缺乏对知识边界的自我认知。在消费场景中,幻觉可能只影响体验;但在商业分析场景中,一个被编造的指标定义或数据结论可能直接误导决策。业界常见的缓解手段包括检索增强生成(RAG)、将回答锚定在可信知识库、要求模型在不确定时明确表达不确定性等。The Library 强调“不知道就说不知道”,本质上是在产品层面设置知识边界,降低幻觉带来的决策风险。
从产品排名看市场信号
The Library 在 Product Hunt 上获得 122 票、10 条评论,排名当日第三。这个成绩在竞争激烈的分析类产品中属于不错的起步表现,说明“业务上下文管理”这个方向确实有需求。
Maker 团队包括 John Sim 等五人。产品归类在 Analytics 和 Tech 下,官网链接指向 Product Hunt 的产品页。从目前公开的信息看,产品仍处于早期阶段,具体的数据接入方式、支持的查询类型、团队协作能力等细节尚未完全披露。
这类产品解决的是什么问题
企业数据分析长期存在一个结构性矛盾:数据平台负责存储和计算,BI 工具负责可视化,但“这个指标到底怎么算”这类业务知识,往往存在于老员工的脑子里或零散的文档中。每次新人提问,都要重新解释一遍。
把业务上下文围绕查询组织起来,本质上是把隐性的业务知识显性化、可复用化。当 AI 基于这套上下文回答问题时,它不只是在做文本生成,而是在调用企业积累的分析资产。这个思路与知识管理领域的“第二大脑”理念有相似之处,只是落点在商业分析场景。
当然,这类产品的挑战也很明显:业务定义会变化,上下文需要持续维护,否则沉淀下来的可能是过时甚至错误的“共识”。The Library 能否在易用性和准确性之间找到平衡,还需要更多实际使用来验证。
“第二大脑”(Second Brain) 是知识管理领域的一个流行概念,指个人或组织通过工具将分散的信息、笔记和思考集中管理,形成可检索、可关联、可复用的外部知识系统。其核心理念是减轻大脑记忆负担,让知识在需要时能被快速调用。在企业场景中,第二大脑的实践包括构建内部知识库、指标字典、分析案例库等。The Library 将这一理念延伸到商业分析领域:把“这个指标怎么算”“上次类似问题怎么分析”等隐性知识沉淀为围绕查询组织的共享上下文,使 AI 在回答时能够调用组织积累的分析资产,而非仅依赖通用训练数据。
值得关注的方向
对于正在把 AI 引入数据分析流程的团队,The Library 提供了一个值得观察的产品样本:不是让 AI 更会说话,而是让 AI 更懂业务、更有边界。在 AI 分析工具普遍追求“什么都能答”的当下,明确“什么不该编”反而是差异化所在。
产品目前公开信息有限,建议关注其后续在数据源接入、团队协作和定义管理方面的迭代。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。