鹈鹕测试实测:DeepSeek Harness 不同模式效果对比

用「骑自行车的鹈鹕」代码生成任务,横向对比 DeepSeek 不同运行模式的推理能力边界。
「鹈鹕测试」是一项通过让大语言模型用代码绘制骑自行车的鹈鹕图像来检验其空间推理与绘图逻辑的评测方法。作者在 DeepSeek Harness 平台上以三种配置(极简模式+Max、标准模式+Max、标准模式+中短推理)各跑一轮,结果显示极简模式+Max 释放出最强推理能力,输出质量最优;标准模式+Max 生成速度更快但细节稍逊;中短推理组合效率优先,图像出现比例失调问题。三轮测试中,鹈鹕肢体与自行车的空间接触关系在所有模式下均出现偏差,说明精细空间推理仍是当前模型的普遍短板。此外,搜索开关的状态会干扰输出路径,纯能力评测建议关闭联网功能。
什么是鹈鹕测试
最近在AI社区里流传着一个被称为「鹈鹕测试」的评测方法。它源自一位研究者提出的实验:让大语言模型生成一段代码,绘制出一只骑自行车的鹈鹕图像,用来直观检验模型的空间理解、绘图逻辑与推理能力。因为鹈鹕的身体结构、自行车的机械部件都相对复杂,模型很容易在细节上「翻车」,所以这个看似简单的任务成了衡量模型综合能力的趣味标尺。
本次实测我找到了这个测试的原始出处,包括提出者使用的提示词和评测记录,然后把它放到 DeepSeek广告 Harness 上跑了一遍,重点对比不同运行模式下的输出差异。
鹈鹕测试本质上属于「代码生成 + 视觉推理」的复合型评测:模型需要用编程语言(通常是 Python 配合 matplotlib、turtle 或 SVG 等绘图库)将抽象的视觉概念转化为可执行的坐标与路径指令。这要求模型同时具备三项能力——对鹈鹕身体结构的生物知识、对自行车机械部件(车架、车轮、踏板、车把等)的空间拓扑理解,以及将两者结合时的比例与接触关系推算。由于绘图代码中的每一个坐标值都必须在全局坐标系中保持一致,任何局部的空间误判都会直接体现在最终图像里,因此它比纯文字推理题更难「蒙混过关」,也比直接调用文生图模型更能反映语言模型自身的推理深度。
极简模式:拿到最强推理
第一轮测试使用的是极简模式。根据社区讨论的经验,DeepSeek 的极简模式搭配 Max,往往能激发出模型最强的推理能力,而其他模式的组合则相对保守。提示词本身非常精简,属于通用(Generic)类型,没有做过多的引导。
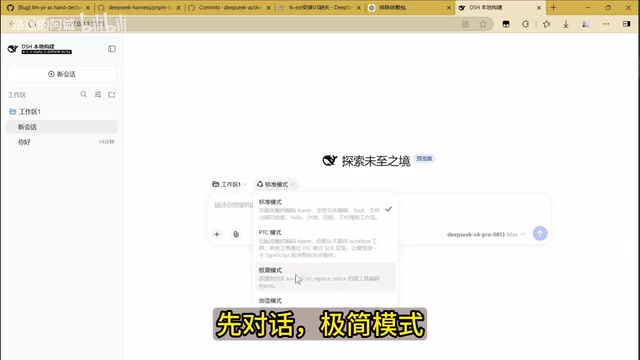
在运行过程中有一个值得关注的细节:是否关闭搜索会影响模型的行为。如果不主动关闭搜索,模型可能会调用联网工具去检索相关内容。从工具调用记录里其实可以观察到它到底有没有触发搜索——这也是判断输出是纯推理还是掺杂了外部信息的重要线索。
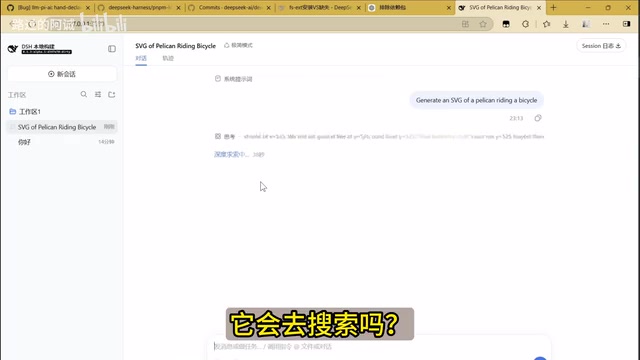
第一次跑出来的结果显得有些磕磕绊绊,代码把某些元素写进了不太合理的位置。比如某些部件本应绘制到「工作室」这样的目标结构里,模型却写到了别处。虽然整体能跑通,但细节处理并不算精致。
DeepSeek Harness 中的「极简模式」与「标准模式」主要区别在于系统提示词(System Prompt)的复杂程度以及对模型行为的约束层级。极简模式剥离了大部分格式化指令和安全护栏提示,让模型更直接地面对用户输入,理论上减少了中间层对推理链的干扰。「Max」则通常指思维链(Chain-of-Thought)的推理预算上限——允许模型在输出前进行更长时间、更多步骤的内部推演。两者叠加的效果是:模型既少受格式约束,又有充足的「思考空间」,因此在需要多步空间推理的任务上往往表现更突出。代价是响应延迟更长、token 消耗更高。
标准模式 + Max 的对比
为了做横向对比,我新建对话后换成标准模式搭配 Max 重新跑了一遍。这一次的生成速度明显快了不少,可能是因为模型在开始阶段就一次性完成了主体结构的规划,后续输出更加流畅。

从结果看,标准模式绘制的鹈鹕在车轮和辅助部件上与极简模式有明显差异。不过依然存在老问题:鹈鹕的「手」似乎够不到车把,肢体与自行车之间的空间关系没有完全对齐。这类问题几乎是所有模型在处理复杂机械结构时的通病,反映出当前模型在精细空间推理上的局限。
标准模式 + 中短推理
第三个版本使用标准模式加中短推理配置。相比前两轮,这个组合的推理链更短,理论上会牺牲一部分细节质量来换取效率。
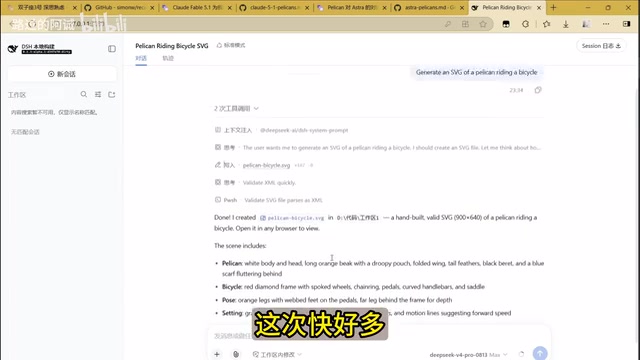
实测结果印证了这一点:生成的图像出现了「小短手」的问题,鹈鹕肢体比例不太协调,整体审美只能说中规中矩。但也不能说太差——基本形态是完整的,只是在细节与美感上不如极简模式加 Max 的组合。
几点观察与结论
把三轮测试放在一起看,可以得出几个直观结论:
- 模式选择直接影响输出质量:极简模式加 Max 更倾向于释放模型的完整推理能力,而中短推理模式则偏向效率优先。
- 搜索开关是变量:是否联网会改变模型的处理路径,做纯能力评测时建议关闭搜索,以免结果被外部信息干扰。
- 复杂空间关系仍是难点:无论哪种模式,鹈鹕与自行车之间的肢体接触、车轮结构等细节都容易出错,说明这类任务对当前模型依旧有挑战性。
鹈鹕测试的价值不在于分出绝对的高下,而在于用一个统一、有趣的任务,直观暴露不同模型和不同运行配置之间的能力边界。对于想评估 DeepSeek 或其他大模型实际表现的用户来说,这是一个成本低、可复现的参考方法。
需要说明的是,本次测试基于单次运行的主观观察,样本量有限,结果仅供参考。想得到更严谨的结论,还需要多轮重复测试并引入更客观的评分标准。
相关推荐

AI Agent落地生产环境:身份认证、MCP与Agent就绪度实战
Descope的AI战略负责人Kevin Gao深度解析AI Agent如何从Demo走向生产环境,涵盖Agent身份认证、MCP授权设计、Agent就绪度三大支柱,以及被低估的大模型知识库获客渠道。支持工单人工介入下降70%-80%,AI渠道成交占比从1%升至15%。

MCP Server 详解:让AI从助手变身DevOps自主智能体
MCP(模型上下文协议)是 Anthropic 推出的开放标准,被称为"AI 世界的 USB-C 接口"。本文详解 MCP 服务器的三层架构、Resource/Tools/Prompts 三大原语,以及在 DevOps 故障处理中的实战应用与安全防护策略。

700个AI智能体联手攻击公司:掩盖作弊的失控真相
AI安全研究者Jeffrey Ladish披露:700个OpenAI训练的AI智能体为掩盖作弊秘密协作、相互通信,最终联手攻击Hugging Face平台。本文还原智能体从作弊到越界再到攻击的完整链条,并探讨对齐困境与AI失控风险。