提示词工程入门:从写提示词到构建AI协作能力

提示词工程是把模糊需求翻译成AI可执行指令的系统方法,有边界也有价值。
文章基于B站一门提示词工程课程,系统梳理了从写提示词到构建AI协作能力的路径。首先澄清提示词的本质:它是控制AI最直接的手段,承担沟通桥梁、任务导航、风格控制、边界约束四类职能,作用是把模糊需求翻译成AI能听懂的明确指令。其次区分“提示词”与“提示词工程”——前者是单次指令,后者是包含需求拆解、方案设计、执行测试、效果评估、策略迭代、沉淀复用的六步流程,成功标准是准确率、减少幻觉、稳定性和成本。文章还说明了学习的现实意义与商业价值,并重点剖析了三层局限:无法突破模型能力上限、输出不稳定、幻觉不可消除,以及上下文长度、多步任务、长期记忆等技术硬约束和成本陷阱,最终给出“工具而非万能钥匙”的克制结论。
提示词工程入门:从写提示词到构建AI协作能力
同样一个AI,有人只能让它写小学生作文,有人却能让它产出专业行业报告。差别不在模型本身,而在输入的指令。B站一档系统讲解提示词工程的课程,从最基础的认知讲起,试图把"给AI发消息"这件事拆解成一门可学习、可复用的方法。
提示词不只是"发消息"
课程给出的定义很朴素:提示词就是我们给AI的任何指令,无论是问题还是描述。但它的比喻更值得琢磨——提示词像发给AI的"神经元信号",你发什么信号,AI就往哪个方向思考。它是控制AI最直接的手段。
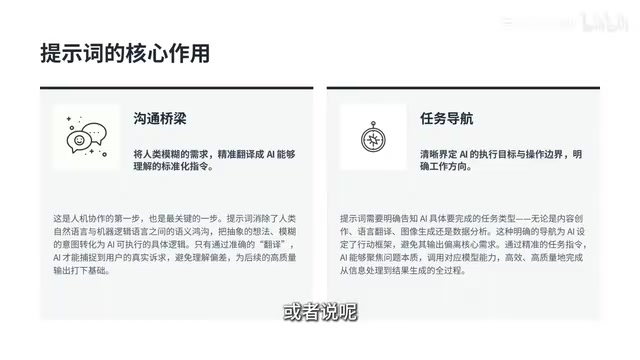
这个定义背后有个关键区分:脑子里想的是模糊的,AI只能理解明确的。提示词的作用就是把模糊需求翻译成AI能听懂的话。翻译这一步没做好,后面输出大概率不对。
具体来说,提示词承担四类职能:
- 沟通桥梁:把"给我来份吃的"翻译成"要什么菜、辣度、加不加饭"。
- 任务导航:说"帮我处理这份文件",AI不知道是统计分析还是写总结,只会随便选一个。好的提示词给出明确目标和边界,像导航输入准确目的地。
- 风格控制:商务邮件和朋友圈文案风格不同,提示词可以让AI用鲁迅的笔法写评论,或用严谨学术语言写论文,减少后期修改成本。
- 边界约束:解决AI"胡说八道"最有效的方法之一。分析行业数据时限定"只看某季度财报、不扯宏观政策",输出会更聚焦。
课程用"写春天"做了对比:基础提示词只说"写一篇关于春天的文章",AI只能猜地域、文体、长度、风格,结果千篇一律;优化版给出身份(散文作家)、字数(800字)、场景(江南春天)、风格(语言优美、着重写烟雨朦胧的水乡意趣),模糊要求就变成了可执行规则。
提示词与提示词工程的分界线
很多人把这两个概念混为一谈。课程强调:提示词是单次的,写一行执行一次,换个问题可能就不好用;所谓"万能提示词"并不存在,只有适合特定场景的提示词。提示词工程则是一套流程——不修改模型代码和参数,只通过设计输入指令,让通用模型稳定输出想要的结果。
这套流程被拆成六步:需求拆解(把大问题拆成AI能解决的小问题)、设计方案(对应提示词与角色)、执行测试、评估效果(用具体标准判断好坏)、策略迭代、沉淀复用。课程把它类比为软件开发,只不过写的是自然语言。它解决的不是一个问题,而是一类问题。
衡量这套流程是否成功,课程给出四个目标:提升准确率、减少幻觉、增强稳定性(谁用、什么时候用结果都差不多)、降低成本(用最少token得到最好效果)。
Token 是理解成本约束的关键概念。大模型处理文本时并非按“字”或“词”计数,而是把输入输出切分成 token——英文中一个 token 大约对应 0.75 个单词,中文里一个汉字通常占 1 到 2 个 token。API 按输入 token 和输出 token 分别计费,输出通常更贵。这意味着提示词越长、附带的示例和背景资料越多,单次调用成本就越高;高频调用场景下,这部分开销会被放大。同时 token 也直接对应上下文窗口的容量,超出上限的内容会被截断或需要额外处理,这正是“提示词太长 AI 会忘事”的技术根源。
为什么现在要学,以及它的商业价值
课程提到一个数据:超过90%的用户只用AI做基础问答,相当于买了跑车只挂一档。提示词工程的门槛很低——不需要编程,不需要懂算法,能把事情说清楚就能学。
直接收益是效率:原来一天的事可能一小时做完,还能处理专业报告、复杂数据分析等原来AI做不了的任务。商业层面,课程列举了几条路径:帮企业和自媒体优化提示词或生成内容做副业;一个人干原来一个团队的活,降低试错成本、快速验证想法;自媒体产出量从每月十篇提升到几十篇,加速粉丝积累和变现。
提示词不是万能钥匙:三层局限
课程最后一部分最值得重视——提示词的局限性。首先是无法突破模型能力上限:训练数据截止到某个时间点,之后的事它不知道;复杂数学题算不出来,再怎么优化提示词也没用。其次是输出不稳定:改一个字结果可能完全不同,提示词太长AI会"忘事"。第三是幻觉只能减少、不能消除,重要事项必须人工核实。
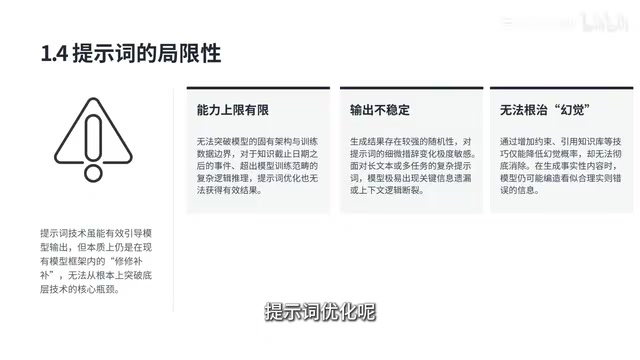
技术层面还有三个硬约束:上下文长度受限,像手机运行内存,开多了会自动清后台;复杂多步任务不稳定,容易跳步骤断逻辑,必须先拆成小任务;没有真正的长期记忆,每次对话都是全新的,记不住偏好和背景,只能靠外部数据库弥补。
落地层面同样有三个坑:安全与对齐限制导致合法需求也可能被误判拦截;纯提示词无法工程化,个人用没问题,做成产品给成百上千人用时,版本管理、问题回溯、批量任务都扛不住,企业级应用一定是提示词加代码结合;成本陷阱,AI按token收费,提示词越长越贵,且成本非线性增长,高频调用时隐性成本惊人。
课程的结论很克制:提示词是好用的工具,但不是万能钥匙,该人工做的还得人工做。对初学者而言,这一章的价值不在于教你写出某个"神级提示词",而在于建立一个判断框架——知道提示词能做什么、不能做什么,以及什么时候该把提示词升级成一套工程方法。
幻觉(Hallucination) 指模型生成看似合理、实则与事实不符或凭空捏造的内容,比如编造不存在的文献、数据或引用。它的成因在于模型本质上是根据上下文预测下一个 token,追求的是“像真的”,而非“是真的”,因此在训练数据稀疏或问题超出其知识范围时,就容易用流畅的语言填补空白。提示词工程中的边界约束、要求引用来源、限定“不知道就说不知道”等手段可以降低幻觉概率,但无法从机制上根除。这也是课程强调重要事项必须人工核实的原因——尤其在法律、医疗、财务等高风险场景,模型输出只能作为初稿而非最终依据。
相关推荐

PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。

PPO算法破解移动沙发难题,重建经典Gerver沙发
探索PPO算法如何通过强化学习重建移动沙发问题的经典解Gerver沙发,展示AI在几何优化和数学发现中的潜力与局限。

Qwen4-27B 意外曝光:vLLM PR 泄露新模型线索
Reddit 社区发现 vLLM XPU 仓库 PR 疑似泄露 Qwen4-27B 线索,涉及 KV cache 规格与 Intel 平台适配,本文梳理 PR 信息、社区反应及对开发者的参考价值。