提示词失效?AI Agent 落地难的真相与解法
Agent 不听话的根源多在提示词与工程配套,而非模型本身。
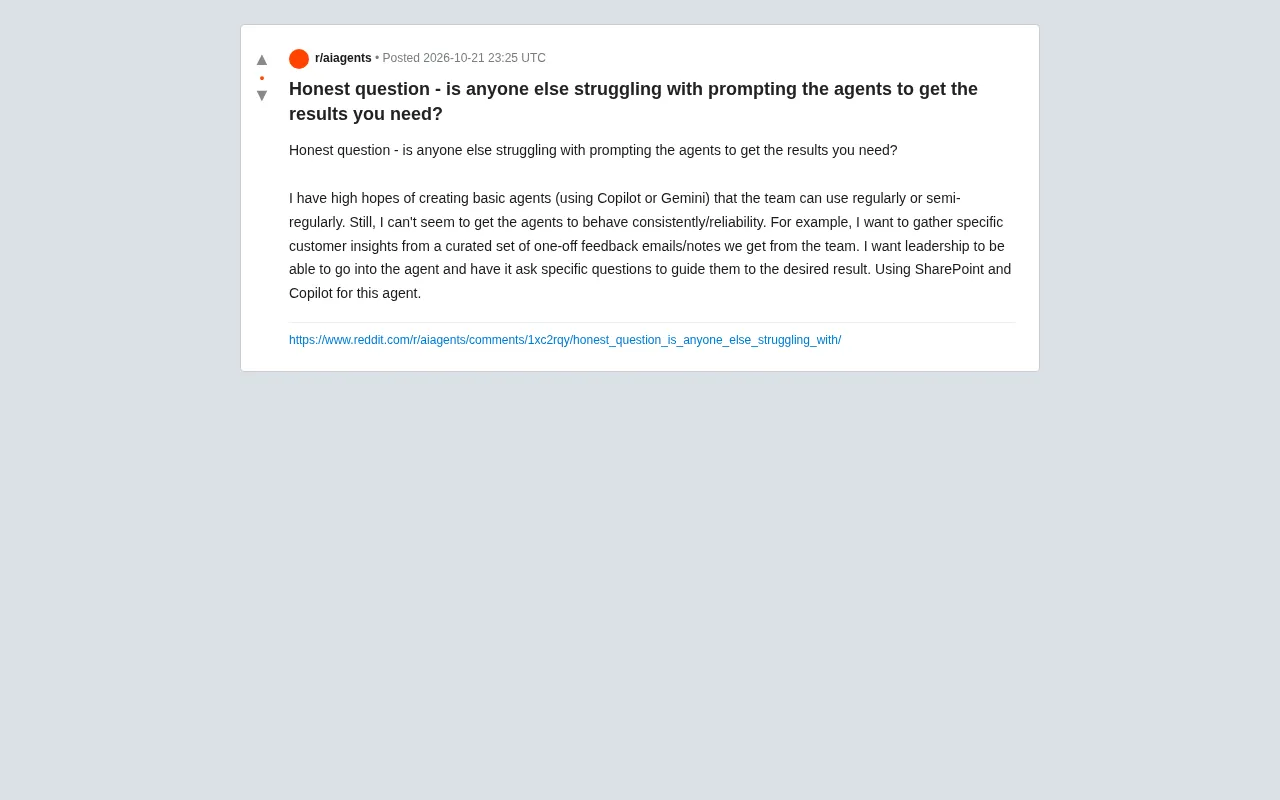
文章从一位开发者在 Reddit 的求助切入:他用 Copilot 和 Gemini 搭建从客户反馈邮件中提取洞察的 Agent,却始终无法稳定运行。作者指出,Agent 的上限往往取决于如何“指挥”它,而非模型能力。问题集中在三个断层:单轮问答到多轮引导的跳跃、离散数据源导致的上下文断裂、以及评估标准的缺失。对此提出三条路径:把提示词当产品需求文档写、先用工作流再上自主 Agent、建立小规模评估闭环。核心结论是,Agent 落地需要工程化思维——清晰指令、可靠数据管道与可度量评估体系。
为什么你的 AI Agent 总是不听话?
一位开发者在 Reddit 上发帖坦言:他满怀期待地用 Copilot 和 Gemini 搭建基础 Agent,希望团队能定期使用,却始终无法让 Agent 稳定、可靠地工作。他的具体需求很明确——从一组精选的客户反馈邮件、笔记中提取洞察,并让领导层通过 Agent 的引导式提问获得想要的结果。平台用了 SharePoint 和 Copilot,但结果依然不尽如人意。
这个场景并非孤例。它精准地戳中了一个被忽略的现实:Agent 的上限,往往不取决于模型本身,而取决于你如何“指挥”它。 当提示词设计跟不上业务复杂度时,再强大的模型也会表现得像个不听话的实习生。
提示词工程在 Agent 场景下的三个断层
1. 从“单轮问答”到“多轮引导”的跳跃
普通对话中,一句清晰的指令就能换来满意回答。但 Agent 需要主动引导用户、追问细节、逐步收敛目标。这意味着提示词不能只描述“做什么”,还要定义“怎么问”。那位 Reddit 用户希望的“引导式提问”,本质上要求 Agent 具备对话状态管理能力——这需要结构化的提示词框架,而非一段自然语言描述。
2. 数据源的离散性与上下文断裂
他使用的素材是一批“一次性”的反馈邮件和笔记,散落在 SharePoint 中。Agent 每次调用时,检索到的上下文可能不完整、格式不统一,导致输出波动。提示词的稳定性,建立在数据管道的稳定性之上。 如果检索增强生成(RAG)的切片策略、元数据标注没有做好,再精细的提示词也救不了断裂的上下文。
检索增强生成(RAG) 是指让大模型在生成回答前,先从外部知识库中检索相关片段,再把这些片段作为上下文拼入提示词的技术范式。它把“模型记忆”与“事实来源”解耦,使 Agent 能引用企业私有数据。RAG 的效果高度依赖三个环节:文档切片(chunking)决定检索粒度,过大会稀释相关性、过小则丢失语义;元数据标注(如来源、时间、部门)支撑过滤与可追溯;重排序(rerank)在初筛后精挑最相关的片段。任一环节粗糙,Agent 拿到的上下文就会残缺或错位,表现为答非所问或前后矛盾。因此文中强调,提示词的稳定性必须建立在数据管道稳定性的基础之上。
3. 评估标准的缺失
“行为不一致”是一个模糊的抱怨。到底是不该回答时回答了,还是该追问时没追问?没有明确的成功标准,就无法迭代提示词。成熟的 Agent 团队会建立测试集,用固定输入验证输出是否符合预期,而不是靠感觉调整。
让 Agent 可靠的三条实操路径
路径一:把提示词当作产品需求文档来写
不要写“帮我总结客户反馈”,而是写清楚:输入是什么格式、输出必须包含哪些字段、遇到模糊信息时应该追问哪三个问题、什么情况下拒绝回答。把隐含的期望显性化,是提升 Agent 确定性的第一步。
路径二:先用工作流,再上自主 Agent
Copilot 和 Gemini 的 Agent 能力仍在演进中。对于“从邮件中提取洞察”这类相对固定的任务,用 Copilot Studio 搭建带分支逻辑的工作流,比让 Agent 自由发挥更可靠。把复杂任务拆成可验证的小步骤,每一步都有明确的输入输出约束,稳定性会显著提升。
自主 Agent 与工作流是两种不同的编排范式。自主 Agent 由模型自行决定调用哪些工具、按什么顺序推进,灵活但行为难以预测;工作流(如 Copilot Studio 中的分支流程)则由人预先定义步骤与条件分支,模型只在固定节点内完成受限任务。对“从邮件提取洞察”这类输入输出相对固定的场景,工作流把不确定性收敛到可控范围,每步都可单独验证和回滚。业界常见的做法是先以工作流跑通并积累评估数据,再在确有必要的开放环节引入 Agent 自主决策,形成“工作流为主、Agent 为辅”的混合架构。
路径三:建立小规模评估闭环
挑出 10 到 20 条典型的反馈邮件作为测试集,定义“好答案”的标准——比如必须引用原始邮件编号、必须区分事实与建议、领导层能在两轮追问内得到结论。每次调整提示词后跑一遍测试集,观察通过率变化。没有度量,就没有优化。
这不是你一个人的困境
Reddit 原帖下的讨论氛围本身就说明问题:大量团队在 Agent 落地阶段卡在“演示惊艳、生产拉胯”的鸿沟里。模型能力的进步有目共睹,但把能力转化为稳定产出,需要的是工程化思维——清晰的指令设计、可靠的数据管道、可度量的评估体系。
那位发帖者问“有没有人也遇到同样的问题”,答案显然是肯定的。真正值得追问的是:你愿意在提示词之外,投入多少精力去搭建让 Agent 可靠运转的基础设施?
相关推荐
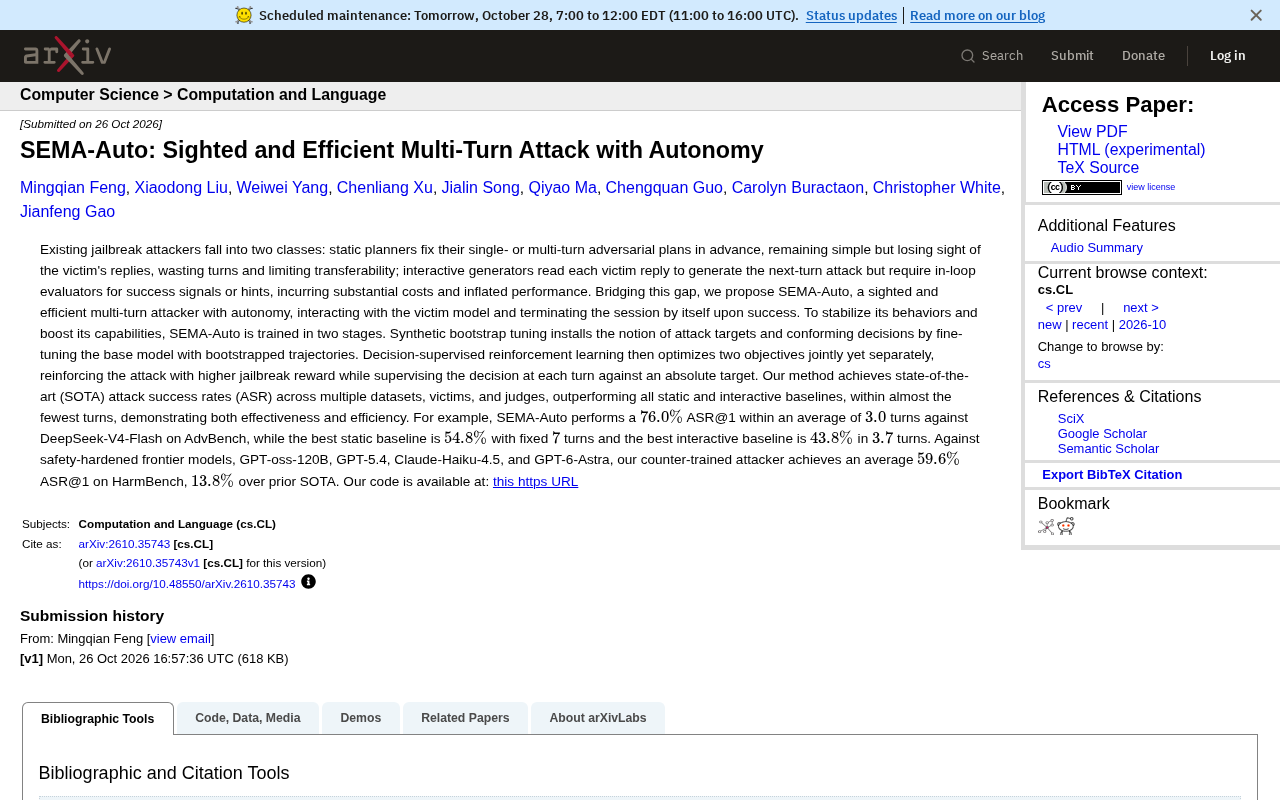
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。
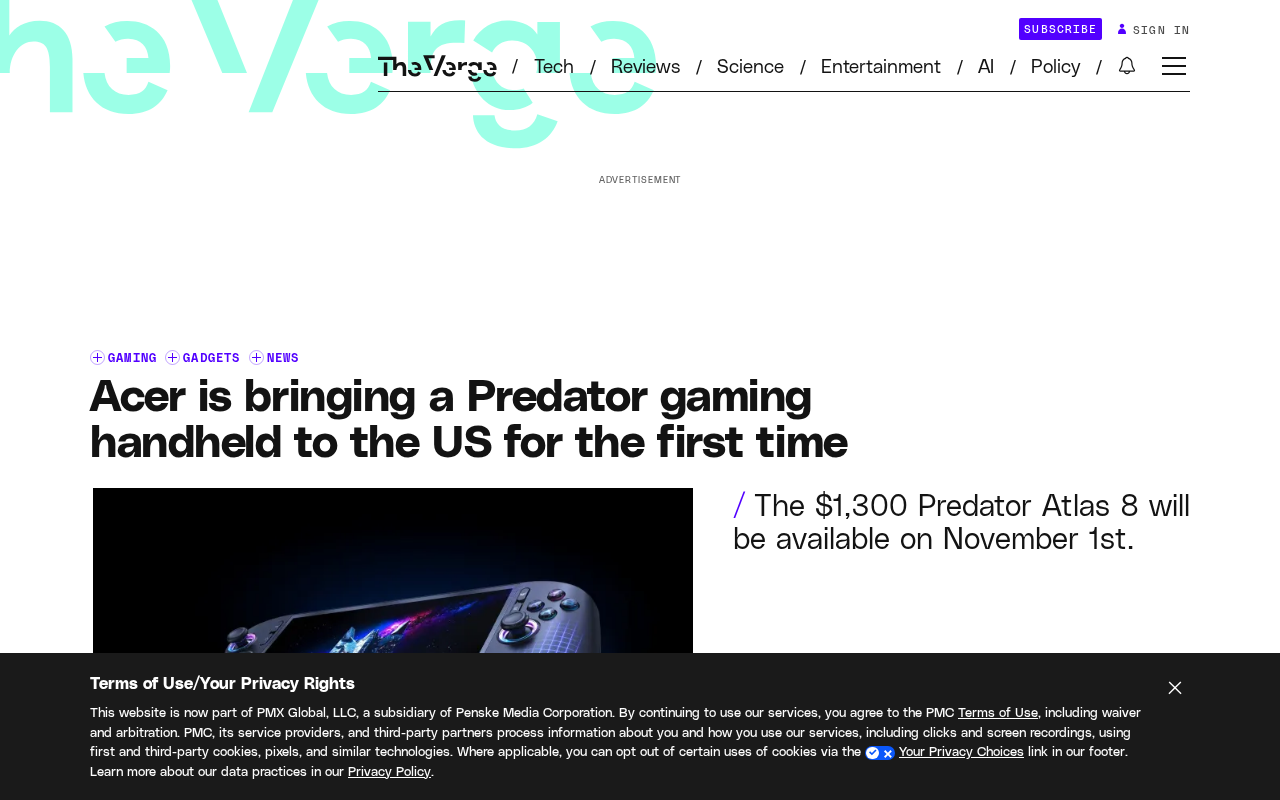
宏碁Predator Atlas 8游戏掌机首次登陆美国,独家首发Best Buy
宏碁Predator Atlas 8游戏掌机首次登陆美国市场,Intel Arc G3 Extreme版本将在Best Buy独家销售。本文梳理型号选择、渠道策略与市场竞争格局。
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。