TileLang:用Python语法写出高性能GPU内核的DSL

TileLang是以Python编写、以Tile分块为核心的高性能AI内核DSL,兼顾开发效率与硬件极限性能。
TileLang是一门面向GPU、CPU及各类AI加速器的领域特定语言(DSL),允许开发者用Python语法编写接近硬件性能极限的计算内核。其核心设计哲学以"Tile"(分块)为抽象单元,通过将计算任务分块映射到寄存器和共享内存等层级化存储资源,由编译器自动完成底层调度优化,让开发者无需深入CUDA汇编即可实现FlashAttention、GEMM、量化算子等大模型核心组件。项目在GitHub已积累超过8200颗Star,与OpenAI Triton共同代表了"Python风格内核开发"这一新范式的快速成熟,标志着高性能计算正从专家手工艺走向可编程、可复用的工程实践。
为什么我们需要一门新的内核开发语言
高性能计算领域长期存在一个尴尬的权衡:想要榨干GPU性能,开发者往往要深入CUDA甚至手写汇编,付出巨大的工程成本;而追求开发效率时,又不得不接受性能的折损。随着大模型训练与推理对算力需求的爆炸式增长,这种矛盾被进一步放大——无论是注意力机制、矩阵乘法还是量化算子,每一次手工优化都意味着漫长的调试周期。
TileLang(tile-ai/tilelang)正是为解决这一痛点而生。它是一门领域特定语言(DSL),目标是简化面向GPU、CPU乃至各类加速器的高性能内核开发。项目目前已在GitHub上收获超过8200颗Star、800多个Fork,并在单周内新增约800颗Star,增长势头相当可观。
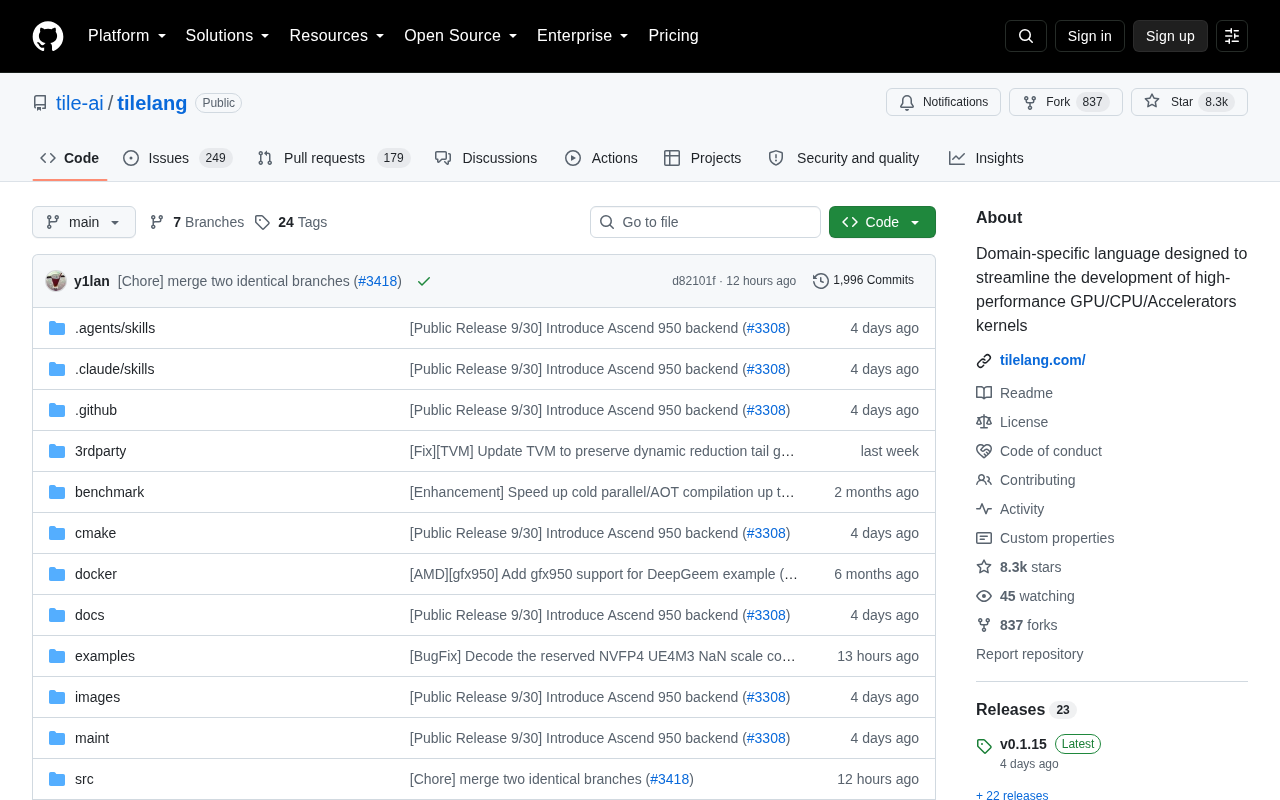
TileLang 的核心定位
TileLang 最大的特点是以 Python 作为开发语言。这意味着开发者可以在熟悉的语法环境中编写内核,而无需完全切换到 CUDA C++ 的思维模式。对于本就以 Python 为主力语言的机器学习工程师而言,这显著降低了进入高性能内核开发的门槛。
从命名可以看出,TileLang 的设计哲学围绕"Tile"(分块)展开。分块是高性能计算中提升数据局部性、优化内存访问的关键技术。通过将计算任务按 tile 组织,编译器能够更好地利用寄存器、共享内存等层级化存储资源,从而逼近硬件的理论性能上限。这种以 tile 为中心的抽象,让开发者得以在较高层面描述算法逻辑,把繁琐的底层调度交给编译器处理。
跨硬件平台的野心
值得关注的是,TileLang 并不局限于 GPU。项目描述明确提到它同时面向 GPU、CPU 和各类加速器(Accelerators)。在当前 AI 芯片百花齐放的格局下,这种跨平台的抽象能力尤为重要——它让同一套算子逻辑有机会在不同硬件后端复用,避免为每种芯片重复造轮子。

"Tile"(分块)抽象背后有一套完整的硬件原理支撑。现代GPU的内存层级从慢到快依次是:全局内存(HBM)→共享内存(Shared Memory/SRAM)→寄存器文件。全局内存的访问延迟可高达数百个时钟周期,而共享内存仅需几十个周期,寄存器则近乎零延迟。Tile分块的核心思想是:将一个大计算任务切分为若干小块,每块数据能够完整装入共享内存或寄存器,在该层级完成所有运算后再写回全局内存,从而最大化数据复用、隐藏内存访问延迟。以矩阵乘法为例,朴素实现中每个输出元素都需要重复读取输入行/列;分块后,一个线程块可以共享同一片输入tile,显著减少全局内存读取次数。这正是cuBLAS、FlashAttention等高性能库获得接近硬件峰值性能的关键手段,也是TileLang将其作为核心抽象的根本原因。
它适合解决哪些问题
结合其设计定位,TileLang 最直接的应用场景集中在深度学习的核心算子上。大模型时代,诸如 FlashAttention、GEMM(通用矩阵乘法)、量化与反量化等算子的性能,直接决定了训练与推理的效率和成本。这些算子恰恰是手工优化最耗时、最需要专业知识的部分。
通过提供 Python 层面的高性能抽象,TileLang 试图让研究者能够快速实现并迭代自定义算子,而不必在每次调整时都陷入底层优化的泥潭。对于需要频繁实验新结构的科研团队和工程团队来说,这种"写得快、跑得快"的组合具有相当的吸引力。
FlashAttention 是理解TileLang价值的一个典型案例。标准Transformer中的自注意力机制需要对长度为N的序列计算N×N的注意力矩阵,朴素实现会将这个巨大矩阵写入GPU全局内存,造成严重的内存带宽瓶颈,空间复杂度达O(N²)。FlashAttention的关键创新在于:将Q、K、V矩阵按tile分块,在SRAM中完成分块内的softmax与加权求和,避免将完整注意力矩阵物化到HBM,从而将内存复杂度降至O(N)并大幅提升吞吐量。手工实现FlashAttention需要精确控制CUDA线程块、共享内存分配和数值稳定性技巧,代码量庞大且难以移植。TileLang的目标正是让研究者能用数十行Python代码表达同等逻辑,将底层tile调度与内存管理委托给编译器,从而将精力集中在算法创新而非工程细节上。
开源生态中的位置
类似思路的项目并非孤例。OpenAI 的 Triton 同样试图用 Python 风格的语法来编写 GPU 内核,并已在业界获得广泛采用。TileLang 的出现,表明以 Python 为载体、以编译器优化为核心的内核开发范式正在形成一股不可忽视的潮流。它们共同指向一个趋势:高性能计算正在从"专家手工艺"走向"可编程、可复用的工程实践"。
对于希望了解或参与这一方向的开发者,TileLang 作为一个处于快速成长期的开源项目,既提供了实践高性能内核开发的入口,也是观察 AI 编译技术演进的一个良好样本。
OpenAI Triton 于2021年发布,是目前这一赛道中最具代表性的先行者。Triton 以Python语法编写GPU内核,编译器自动处理共享内存分配、线程调度与向量化等底层细节,已被PyTorch作为算子融合(torch.compile)的默认后端之一。相较而言,TileLang 的tile-centric设计在抽象层次上更为明确,强调将分块策略显式暴露给开发者,以便在自动优化之外保留精细调控的空间。此外,学术界还有 Halide(图像处理DSL)、TVM的TE/TIR等先例,它们共同验证了"计算与调度分离"这一设计哲学的可行性。TileLang 的差异化在于同时面向多类硬件后端,并针对大模型时代的算子需求(如Flash Attention变体、MoE路由等)做了专项优化,这也是其能在Triton已相对成熟的情况下仍快速吸引社区关注的重要原因。
小结
TileLang 以 Python 为语法基础、以 tile 分块为核心抽象,瞄准 GPU/CPU/加速器的高性能内核开发,在降低门槛的同时追求接近硬件极限的性能。在大模型算力需求持续攀升、AI 芯片生态日益多样化的背景下,这类领域特定语言的价值会愈发凸显。其在 GitHub 上的高速增长,也从侧面印证了社区对高效内核开发工具的强烈需求。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。