TIRx Harness:面向智能体GPU编程的开源编译器框架

TIRx Harness 是一个将LLM智能体与GPU编译流程对接的开源框架,旨在标准化AI生成高性能kernel的闭环工具链。
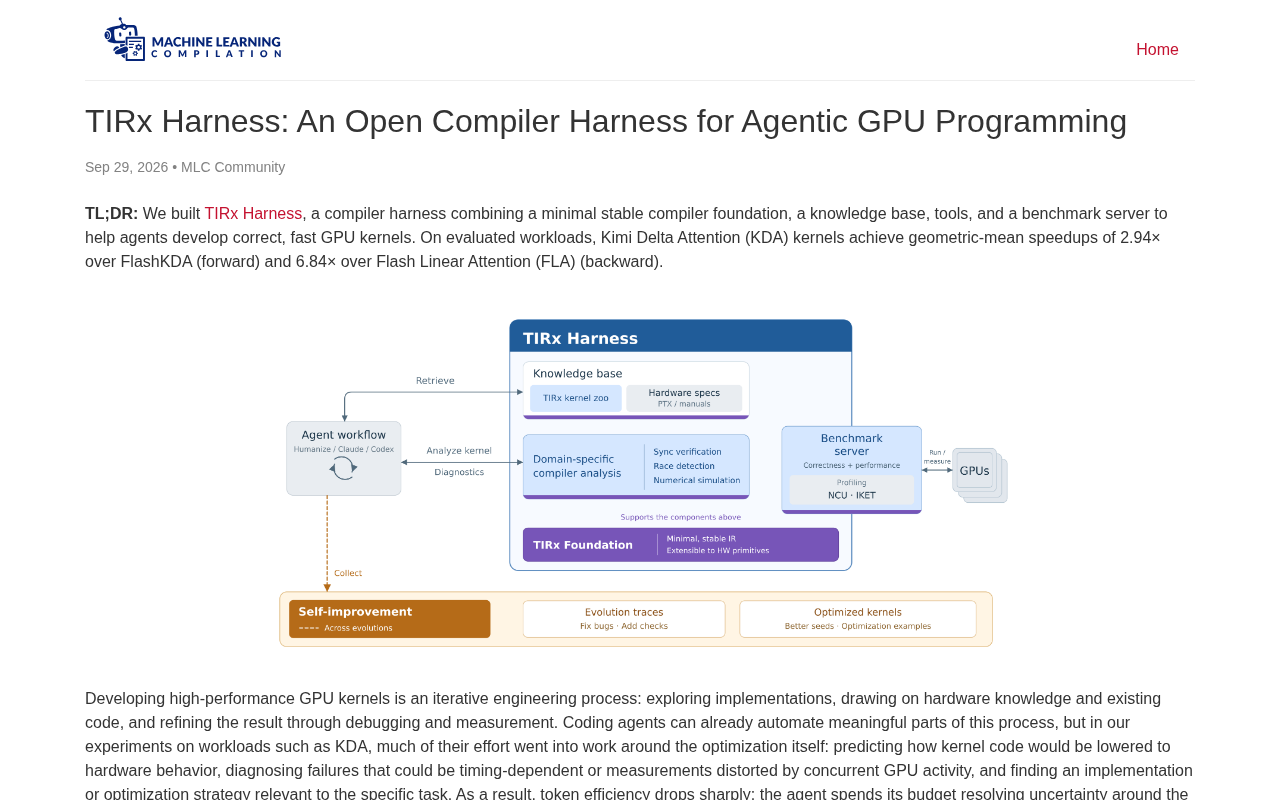
TIRx Harness 是一个定位于「智能体式GPU编程」的开源编译器框架,核心思路是为LLM智能体提供一个标准化的编译-执行-反馈闭环:接收智能体生成的GPU kernel代码,调用编译器工具链,在真实或模拟GPU环境中执行并捕获错误与性能指标,再将结果结构化地返回给智能体以驱动下一轮迭代。该项目契合近一两年「用AI自动生成高性能GPU kernel」的活跃研究趋势,试图通过开源方式降低门槛、提升可复现性并推动生态协同。目前项目处于早期曝光阶段(Hacker News仅5赞、无评论),成熟度仍需通过仓库实际代码验证,但其所代表的方向——AI从写业务代码延伸至写底层高性能代码——具有清晰的长期价值。
一个瞄准GPU编程新范式的开源工具
TIRx Harness 是一个近期在 Hacker News 上被提及的开源项目,定位为面向「智能体式 GPU 编程」(Agentic GPU Programming)的编译器框架(Compiler Harness)。从命名和定位来看,它试图将大模型驱动的智能体(Agent)与 GPU 底层编译流程结合起来,让 AI 在生成、优化和验证 GPU 代码的过程中拥有一个标准化、可复用的工具链入口。
需要说明的是,该项目目前在社区中的讨论仍处于早期阶段——原始帖子仅有 5 个赞、暂无评论,属于典型的早期开源项目曝光。因此本文更多是从其定位切入,分析这类工具背后的技术趋势与潜在价值,而非对其成熟度下结论。
什么是「智能体式GPU编程」
传统 GPU 编程(如 CUDA、Triton、以及各类 kernel 编写)对开发者的底层知识要求极高:你需要理解内存层级、线程块划分、寄存器压力、访存合并等一系列细节,才能写出高性能的 kernel。这也是为什么 GPU 高性能计算长期是少数专家的领域。
所谓「智能体式」编程,核心思路是让 LLM 智能体承担起编写和调优这些底层代码的重复性劳动。智能体可以生成候选 kernel、编译运行、读取性能反馈、再迭代优化,形成一个闭环。而这个闭环要真正跑起来,就需要一个可靠的「Harness」——一个把编译、执行、评测、反馈串联起来的中间层。
Harness 的关键作用
在软件工程中,Harness(测试/执行框架)指的是为代码提供运行环境、驱动执行并收集结果的支撑结构。放到 GPU + 智能体场景下,一个编译器 Harness 通常需要承担几类职责:
- 接收智能体生成的代码并调用相应编译器工具链
- 在真实或模拟的 GPU 环境中执行并捕获错误、性能数据
- 将编译失败、运行时错误、性能指标结构化地反馈给智能体
- 提供可复现、可对比的评测基准
这套基础设施的价值在于:它把「智能体如何与 GPU 底层交互」这一复杂问题标准化,让研究者和开发者不必每次都重复搭建脚手架。
Triton 是由 OpenAI 开源的一种 GPU 编程语言与编译器,目标是让开发者用比 CUDA 更高层的 Python 式语法写出接近手写 CUDA 性能的 kernel,目前已被 PyTorch 广泛用于算子融合与自定义算子开发。与之相比,CUDA 是 NVIDIA 推出的并行计算平台与编程模型,要求开发者直接管理线程网格(Grid)、线程块(Block)和共享内存等硬件细节。「kernel」在 GPU 编程语境中特指在 GPU 上并行执行的函数单元,一个深度学习模型的前向推理往往由数十乃至数百个 kernel 拼接而成。正是因为每个 kernel 的性能差异可以直接决定整体推理延迟,手工调优 kernel 成为 AI 基础设施工程师的核心工作之一,也因此成为 LLM 自动化的高价值目标。
为什么这类工具正在变得重要
近一两年,用 LLM 生成高性能 GPU kernel 已经成为一个活跃的研究方向。业界普遍面临的痛点是:模型能生成语法正确的代码,但要保证正确性和性能却困难重重,必须依赖大量的编译-执行-反馈循环。缺少统一的 harness,各个团队只能各自造轮子,结果难以横向比较。
一个开源的编译器 harness 若能被社区接受,可能带来几方面意义:
- 降低门槛:让更多研究者能快速验证「AI 写 GPU 代码」的想法
- 可复现性:统一的执行与评测环境有助于研究结果对比
- 生态协同:开源属性意味着可以接入不同编译器后端、不同硬件目标
这一方向已有若干代表性工作可供参照。Meta 的 KernelBench 和 DeepMind 等机构的相关研究均尝试用 LLM 自动生成并评测 GPU kernel,AlphaCode 等代码大模型也开始涉及底层性能代码生成。与此同时,TVM、MLIR 等编译器基础设施的成熟,使得「将 LLM 输出接入编译器流水线」在工程上变得更可行——这些框架提供了结构化的中间表示(IR)和可编程的优化 pass,让 harness 有了标准化的对接界面。缺少这一层抽象时,LLM 生成的代码往往只能被当作黑盒字符串,难以进行语义级别的验证或增量式的调优反馈。
理性看待:早期项目的不确定性
必须强调,仅凭 Hacker News 上的一条曝光信息,无法判断 TIRx Harness 的技术实现深度、适配范围和实际效果。它可能是一个成熟框架的公开发布,也可能只是一个概念验证阶段的雏形。
对于关注 AI 编程与 GPU 高性能计算交叉领域的开发者,建议的做法是:
- 直接查阅其开源仓库,了解支持的编译器后端和硬件平台
- 关注它是否提供可运行的示例与基准测试
- 观察后续社区讨论与 issue 活跃度,判断项目生命力
结语
TIRx Harness 反映的是一个清晰的趋势:随着智能体能力增强,AI 正在从「写业务代码」向「写底层高性能代码」延伸,而 GPU 编程正是这一延伸中最具挑战也最有价值的战场。无论这个具体项目最终走向如何,围绕「智能体 + 编译器 harness」的基础设施建设,都值得长期关注。感兴趣的读者不妨亲自去仓库一探究竟,用实际代码验证它的能力边界。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。