TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响

TMLE与AIPW的样本分割方式会系统性影响区间覆盖率,需谨慎设计。
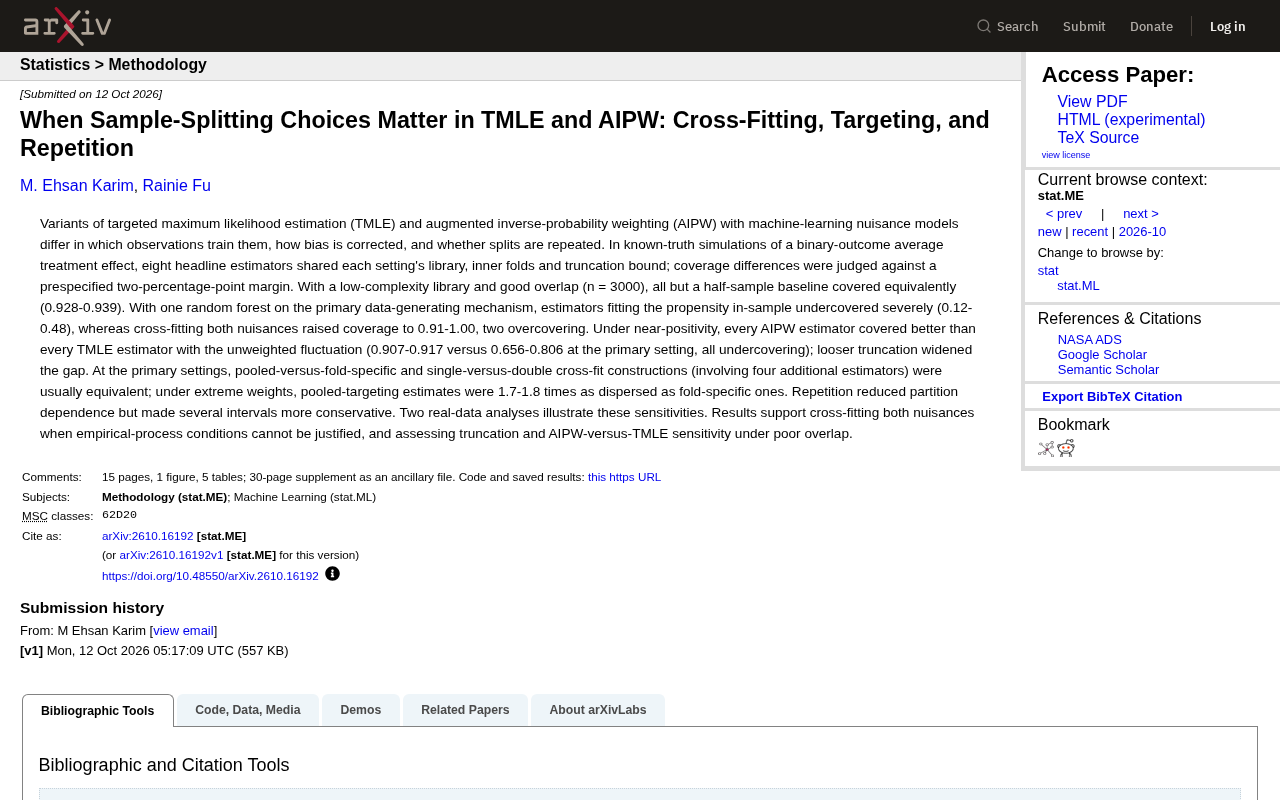
一项arXiv模拟研究系统评估了TMLE与AIPW中样本分割设计(交叉拟合、靶向方式、重复划分)对区间覆盖率的影响。结果显示,在主数据生成机制上使用随机森林、并在样本内拟合倾向得分时,覆盖率会从正常水平跌至0.12–0.48;而对两个nuisance同时做交叉拟合可恢复到0.91–1.00。近正性设定下,所有AIPW覆盖率(0.907–0.917)优于采用未加权波动的TMLE(0.656–0.806)。极端权重下,合并靶向的估计值离散度是分折靶向的1.7–1.8倍。重复划分虽能降低对单次划分的依赖,但会使区间更保守。研究建议:无法论证经验过程条件时应对两个nuisance都做交叉拟合,并在重叠较差时评估截断界限并同时报告AIPW与TMLE结果。
在因果推断的实践中,TMLE(Targeted Maximum Likelihood Estimation)和AIPW(Augmented Inverse-Probability Weighting)常被视为「即插即用」的稳健方法——只要把机器学习模型接入便可以获得双重稳健性。但一项发表在arXiv上的模拟研究给出了更细致的警告:样本分割方式本身就是一个不可忽视的设计维度,交叉拟合(cross-fitting)与否、靶向步骤(targeting)如何执行、以及是否重复划分(repetition),都会系统性地改变估计量的区间覆盖率。
研究设计:已知真值的对照实验
该研究采用已知真值的模拟框架,针对二值结局的平均处理效应(ATE)进行评估。八个「头条」估计量共享同一设定下的 nuisance 模型库、内部折数与截断界限(truncation bound),从而把差异归因于样本分割策略本身。覆盖率的判定标准是预先设定的两个百分点边际:超出这个范围的偏离才算「有实质差异」,避免把蒙特卡洛噪声当成结论。
模拟分为三层难度。第一层是低复杂度模型库加良好重叠(n=3000),此时除半样本基线外,所有估计量的覆盖率在0.928–0.939之间,彼此等价。第二层换成在主数据生成机制上使用随机森林,情况急转直下:在样本内拟合倾向得分(in-sample propensity)的估计量覆盖率跌至0.12–0.48,严重欠覆盖;而两个 nuisance 都做交叉拟合后,覆盖率回升到0.91–1.00,其中两个还出现过度覆盖。第三层是近正性(near-positivity)设定,此时每个AIPW估计量的覆盖率都好于每个采用未加权波动(unweighted fluctuation)的TMLE估计量,差距在主设定下为0.907–0.917对0.656–0.806,且所有TMLE都出现欠覆盖;放宽截断后差距进一步拉大。
双重稳健性(double robustness) 是AIPW与TMLE共同的卖点:估计量由「结局回归模型」与「倾向得分模型」两部分构成,只要其中之一设定正确,ATE估计就是一致的。这一性质在数学上依赖于两个nuisance函数的收敛速率与经验过程条件,因此实际表现高度依赖于机器学习模型的拟合方式。Nuisance函数指的是我们并不直接关心、但估计目标参数时必须先估出来的辅助函数,在此处即结局回归函数与倾向得分函数;TMLE正是通过对初始估计施加一个「靶向更新步」来消除这些nuisance估计误差带来的偏误。
交叉拟合:不是可选项,而是默认前提
上述结果中最有实践价值的一条是:当经验过程条件(empirical-process conditions)无法被严格论证时,应该对两个 nuisance 同时做交叉拟合。理由并不抽象——在样本内拟合倾向得分会让个体贡献之间产生依赖,基于独立同分布假设推导的方差估计因此低估真实不确定性。随机森林这类高方差、数据自适应强的模型会把这种依赖放大,于是覆盖率崩塌到0.12–0.48也就不足为奇。
交叉拟合把样本分成若干折,用其他折训练、留出折评估,恢复了贡献之间的近似独立性。研究显示,这一操作不仅修复了覆盖率,还在某些设定下略微过度覆盖,属于保守但安全的方向。对做实际数据分析的人而言,这意味着当重叠情况一般、模型复杂度较高时,不应为了节省计算量而跳过交叉拟合。
经验过程条件(empirical-process conditions) 是保证交叉拟合估计量渐近正态、方差估计有效的技术前提,直观上要求nuisance估计的复杂度不能太高,否则基于独立同分布假设的方差公式会失效。正性(positivity) 也称重叠(overlap),指在不同处理组中每个协变量取值都有非零概率被观测到;当倾向得分接近0或1时,权重会极端膨胀,方差急剧上升。截断界限(truncation bound) 就是人为把倾向得分限制在如[0.01, 0.99]区间内,以牺牲少量偏误换取方差稳定,这一选择本身也会影响覆盖率,因此研究建议在重叠较差时做敏感性分析。
靶向方式:合并与分折的取舍
研究还比较了合并(pooled)与分折(fold-specific)靶向、以及单次与双重交叉拟合构造,额外涉及四个估计量。在主设定下,这些变体通常等价;但在极端权重下,合并靶向的估计值离散度是分折靶向的1.7–1.8倍。原因在于合并靶向把所有折的残差汇到一起更新,个别高权重观测能对整体更新产生不成比例的影响;分折靶向则把这种影响限制在局部。
这提示一条实用规则:当权重分布尾部很厚时,分折靶向更稳;权重温和时,合并靶向因使用全部数据而方差更小,两者并无显著差异。
靶向步骤(targeting step) 是TMLE区别于AIPW的关键:AIPW直接在初始估计上做一步校正,而TMLE通过拟合一个以「倾向权重」为协变量的波动模型来更新初始结局回归,使更新后的估计满足有效影响函数方程。波动模型(fluctuation model) 通常对二值结局用logistic回归、连续结局用线性回归,其唯一协变量由倾向得分构造。合并靶向是把所有交叉拟合折的残差拼在一起更新一次,分折靶向则是每折单独更新。影响函数(influence function) 决定了估计量的渐近方差,交叉拟合后的有效影响函数依赖于折间平均,这也是为什么折数与划分方式会影响区间宽度。
重复划分:稳健但保守
重复样本分割(repetition)通过平均多个随机划分的结果,降低了对单次划分的依赖——这是它的核心价值,尤其在样本量有限、划分偶然性影响大时。但代价是多个区间取平均后整体变得更保守,研究观察到若干估计量的区间变宽。换言之,重复划分换来了稳定性,牺牲了部分效率。是否值得,取决于分析目标:若关注区间覆盖的可靠性,重复划分划算;若关注区间宽度与检验功效,则需权衡计算成本与保守程度。
对实践的启示
两项真实数据分析印证了上述敏感性,说明这些模式并非模拟人工产物。综合来看,研究给出两条明确建议:其一,在无法论证经验过程条件时,对两个 nuisance 都使用交叉拟合;其二,在重叠较差(poor overlap)时,主动评估截断界限的选择,并同时报告AIPW与TMLE的结果,而不是只选一个。
对使用机器学习做因果推断的研究者,这项工作的意义在于把「样本分割」从一个实现细节提升为需要报告和做敏感性分析的设计选择。仅说明用了TMLE或AIPW远远不够——怎么分割、在哪一步做交叉拟合、截断设在哪,都直接决定结论是否可信。
在报告因果推断结果时,敏感性分析(sensitivity analysis) 应至少覆盖三个维度:折数(如2折、5折、10折)、靶向方式(合并或分折)、截断界限(如0.01、0.025、0.05)。可以借助重复交叉拟合(repeated cross-fitting) 报告区间平均与覆盖率的经验表现,从而把样本分割的不确定性显式纳入推断。对于医学、经济等对结论可信度要求较高的场景,建议同时报告AIPW与TMLE的区间,并说明二者在极端权重下可能出现的分歧来源,便于审稿人与读者判断结论的稳健性。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。