Tokeniser覆盖率:小语言模型在多语言场景下的隐形天花板

小语言模型的效率神话在非英语语言中破灭,词汇表覆盖率而非参数量才是多语言场景的真正瓶颈。
一项针对11种印度文字、13.1万句子的研究揭示,小语言模型的效率度量标准以英语为中心,无法直接迁移。TinyLlama-1.1B在卡纳达语上每词产生22.60个token,是拉丁文字的17倍,导致2048上下文窗口下仅剩91词可用。11种文字中5种的fertility达到UTF-8字节回退上限,奥里亚语码点覆盖率为0%,但UNK率显示为0.0%,失败完全静默。mBERT在奥里亚语上获得低fertility的同时丢弃87.9%文本为UNK,表明低fertility可能掩盖信息损失。MuRIL参数量仅为TinyLlama五分之一,却实现1.23-2.26 tokens/word且零UNK,证明词汇表而非参数量是约束瓶颈。
引言:被忽视的效率指标
当我们谈论小语言模型(SLM)的效率时,几乎总是引用一个数字:内存占用。量化、参数高效微调等技术被广泛宣传为在算力受限条件下实现多语言AI的途径。然而,一项针对11种印度文字系统的研究揭示了一个被忽视的事实:效率的度量标准是用英语定义的,并不能直接迁移到其他语言。
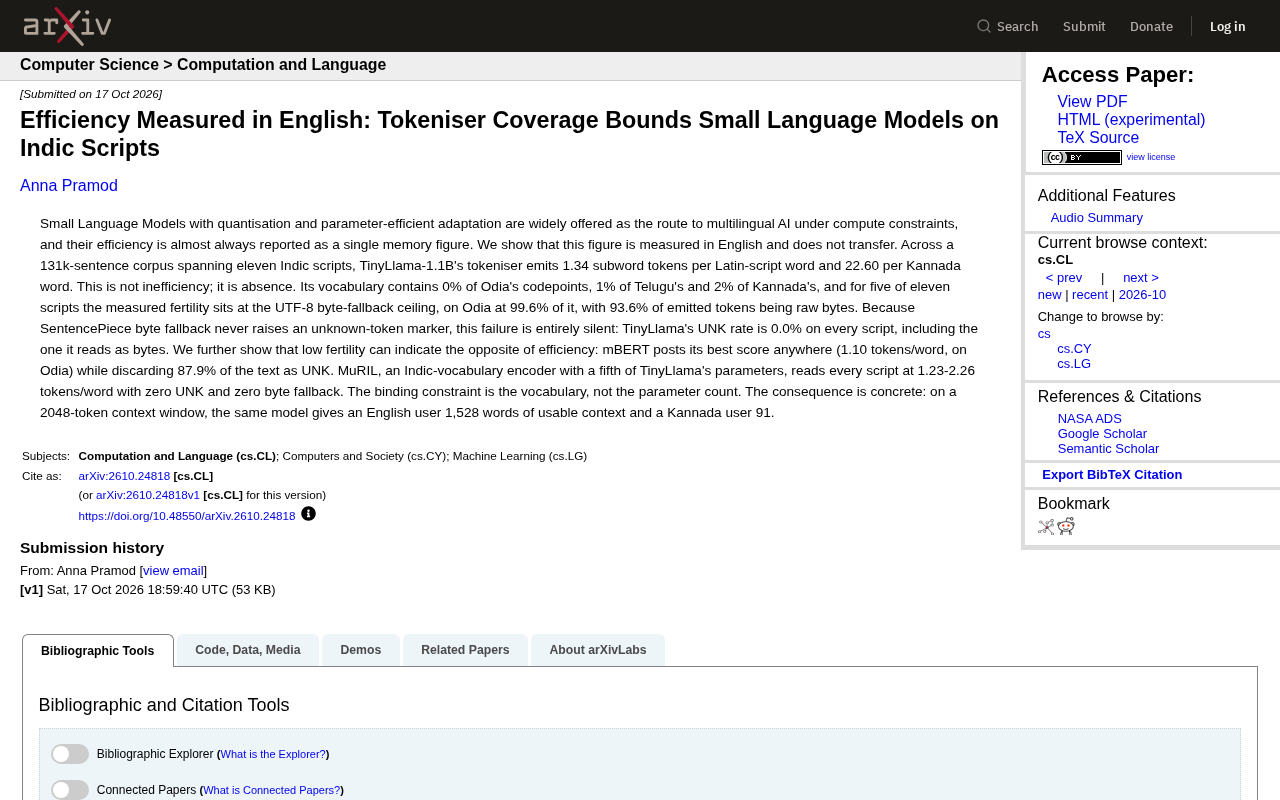
该研究基于一个包含13.1万句子的语料库,覆盖了11种印度文字,对比了TinyLlama-1.1B、mBERT和MuRIL等模型的分词器表现。结果直指一个核心问题:词汇表覆盖率,而非参数数量,才是小语言模型在多语言场景下的根本约束。
分词器效率的真相:英语中心主义的度量
子词 token 数量的巨大差异
研究显示,TinyLlama-1.1B的分词器在处理拉丁文字时,每个单词平均产生1.34个子词token;而处理卡纳达语(Kannada)时,每个单词平均产生22.60个token。这并非简单的效率低下,而是词汇表缺失的体现。
这种差异直接影响了模型的有效上下文长度。在2048个token的上下文窗口中,英语用户可以获得1528个单词的可用上下文,而卡纳达语用户仅能获得91个单词。这意味着,同样的模型,对不同语言用户的实际可用容量相差近17倍。
Fertility 是衡量分词器效率的常用指标,定义为每个单词平均被切分成的子词 token 数量。fertility 越高,表示同一段文本消耗的 token 越多,模型的有效上下文长度被压缩得越严重。理想情况下,针对某语言训练的分词器在该语言上的 fertility 应接近 1(一个词对应一个 token)。跨语言比较时,fertility 的差异直接反映了词汇表对该语言的覆盖程度——若词汇表中缺乏某语言的常用子词单元,分词器只能退而求其次,将词语切得更碎,甚至回退到字节级别。
词汇覆盖率的触目惊心
TinyLlama的词汇表中,奥里亚语(Odia)的码点覆盖率为0%,泰卢固语(Telugu)为1%,卡纳达语为2%。在11种文字中,有5种文字的fertility(每个单词产生的token数)达到了UTF-8字节回退的上限,奥里亚语更是达到了上限的99.6%,其中93.6%的token是原始字节。
更隐蔽的是,由于SentencePiece的字节回退机制从不产生未知token标记(UNK),这种失败是完全静默的。TinyLlama在所有文字上的UNK率均为0.0%,包括那些被当作字节读取的文字。模型看似“认识”所有文字,实则只是在拼凑字节。
SentencePiece 的字节回退机制 是理解“静默失败”的关键。当分词器遇到词汇表中完全不存在的字符时,SentencePiece 默认不会输出 UNK(未知)标记,而是将该字符拆解为 UTF-8 原始字节序列,每个字节映射为一个 token。这一设计保证了任何输入都可被编码,但代价是:一个字符可能膨胀为 2-4 个字节 token,且这些 token 不携带任何语义信息,模型只能从头学习如何从字节拼凑出字符。更严重的是,由于 UNK 率为零,常规的效率报告无法察觉这种退化——分词器表面“正常”,实际却以极低的语义密度在运行。
低 fertility 的陷阱:mBERT的虚假效率
研究进一步揭示,低fertility可能意味着与效率相反的结果。mBERT在奥里亚语上获得了其最佳分数(1.10 tokens/word),但同时将87.9%的文本丢弃为UNK。这种“高效”是以牺牲信息为代价的——模型大量忽略输入内容,却因为UNK率未被纳入效率报告而显得表现优异。
这提醒我们,单一的内存或token数指标可能产生误导。真正的效率应当综合考虑词汇覆盖率、UNK率以及字节回退的使用情况。
UNK 率(未知 token 比率)是评估分词器覆盖质量的另一核心指标,指输入文本中被映射为 UNK 标记的 token 占比。与字节回退不同,UNK 意味着该部分输入被彻底丢弃,模型无法从中获取任何信息。在效率报告中,fertility 和 UNK 率必须联合解读:低 fertility 若伴随高 UNK 率,说明分词器通过“忽略”而非“理解”输入来降低 token 数,这是一种信息损失而非效率提升。仅报告 fertility 或仅报告内存占用,都可能掩盖分词器在特定语言上的严重缺陷。
词汇表,而非参数量:MuRIL的启示
MuRIL是一个具有印度语言词汇的编码器,其参数量仅为TinyLlama的五分之一,却在所有文字上实现了1.23-2.26 tokens/word的读取效率,且零UNK、零字节回退。这一对比清晰地表明:绑定约束是词汇表,而不是参数数量。
对于资源受限环境下的多语言AI部署,盲目追求更小的参数量或更高的量化精度可能收效甚微。优先构建或选择覆盖目标语言词汇的分词器,才是提升实际效率的关键。
MuRIL(Multilingual Representations for Indian Languages)是 Google 基于 BERT 架构专门针对印度语言预训练的编码器模型,其词汇表在构建时纳入了大量印度文字的子词单元,并使用了 transliteration 和 translation-based 的训练目标来增强跨文字对齐。与通用多语言模型不同,MuRIL 的设计假设是:目标语言的词汇覆盖是模型实用性的前提。该研究中的对比之所以有力,正是因为 MuRIL 以极小的参数量实现了对 11 种印度文字的高效读取,说明在低资源多语言场景下,词汇表设计的前置投入比模型规模的堆叠更具性价比。
结论与启示
这项研究对多语言AI的实践者提出了重要警告:
- 效率报告需要区分语言,不能将英语基准直接外推。
- 分词器的词汇覆盖率应作为核心评估指标,与内存占用同等重要。
- 字节回退机制虽然避免了UNK,但可能掩盖严重的词汇缺失问题。
- 在印度语言等低资源场景下,选择具有针对性词汇表的模型(如MuRIL)比单纯缩小模型规模更有效。
小语言模型的“效率”神话,在英语之外的语言中可能只是幻觉。真正的多语言公平,需要从分词器开始重新思考。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。